امنیت، هویت، استقرار و تابآوری · فصل ۹ — Resource، Provider، Cost و Organizational Failure · 125
Main Workstation Interference
failure را بعد از وقوع و بهصورت موردی تحلیل میکند و هنوز detection، containment و repair path از قبل طراحی نشده است. موضوع جاری: «Main Workstation Interference». میتواند failure family «Main Workstation Interference» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
خلاصهٔ درس
failure را بعد از وقوع و بهصورت موردی تحلیل میکند و هنوز detection، containment و repair path از قبل طراحی نشده است. موضوع جاری: «Main Workstation Interference».
میتواند failure family «Main Workstation Interference» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
خروجی این درس
میتواند failure family «Main Workstation Interference» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
پیشنیازها
1. کندی workstation بهتنهایی علت را ثابت نمیکند
وقتی editor، terminal یا browser کند میشود، اولین فرض نباید «خرابی سیستم» باشد. failure این درس زمانی مطرح است که یک workload پسزمینه مثل build، container، indexing یا model job با مصرف CPU، memory یا I/O روی workflow تعاملی foreground اثر قابلاندازهگیری بگذارد. تشخیص باید از شواهد per-workload و responsiveness شروع شود، نه از یک حس کلی کندی.
2. foreground و background را جدا اندازه بگیرید
Foreground همان کاری است که responsiveness آن برای کاربر مهم است؛ background همان کاری است که میتواند منابع را مصرف کند بدون اینکه مستقیماً interactive باشد. برای هر پنجره زمانی، latency foreground و مصرف CPU/memory/pressure workload پسزمینه را کنار هم ثبت کنید. اگر فقط host-wide utilization را ببینید، attribution ضعیف میشود.
3. container boundary بهتنهایی isolation نیست
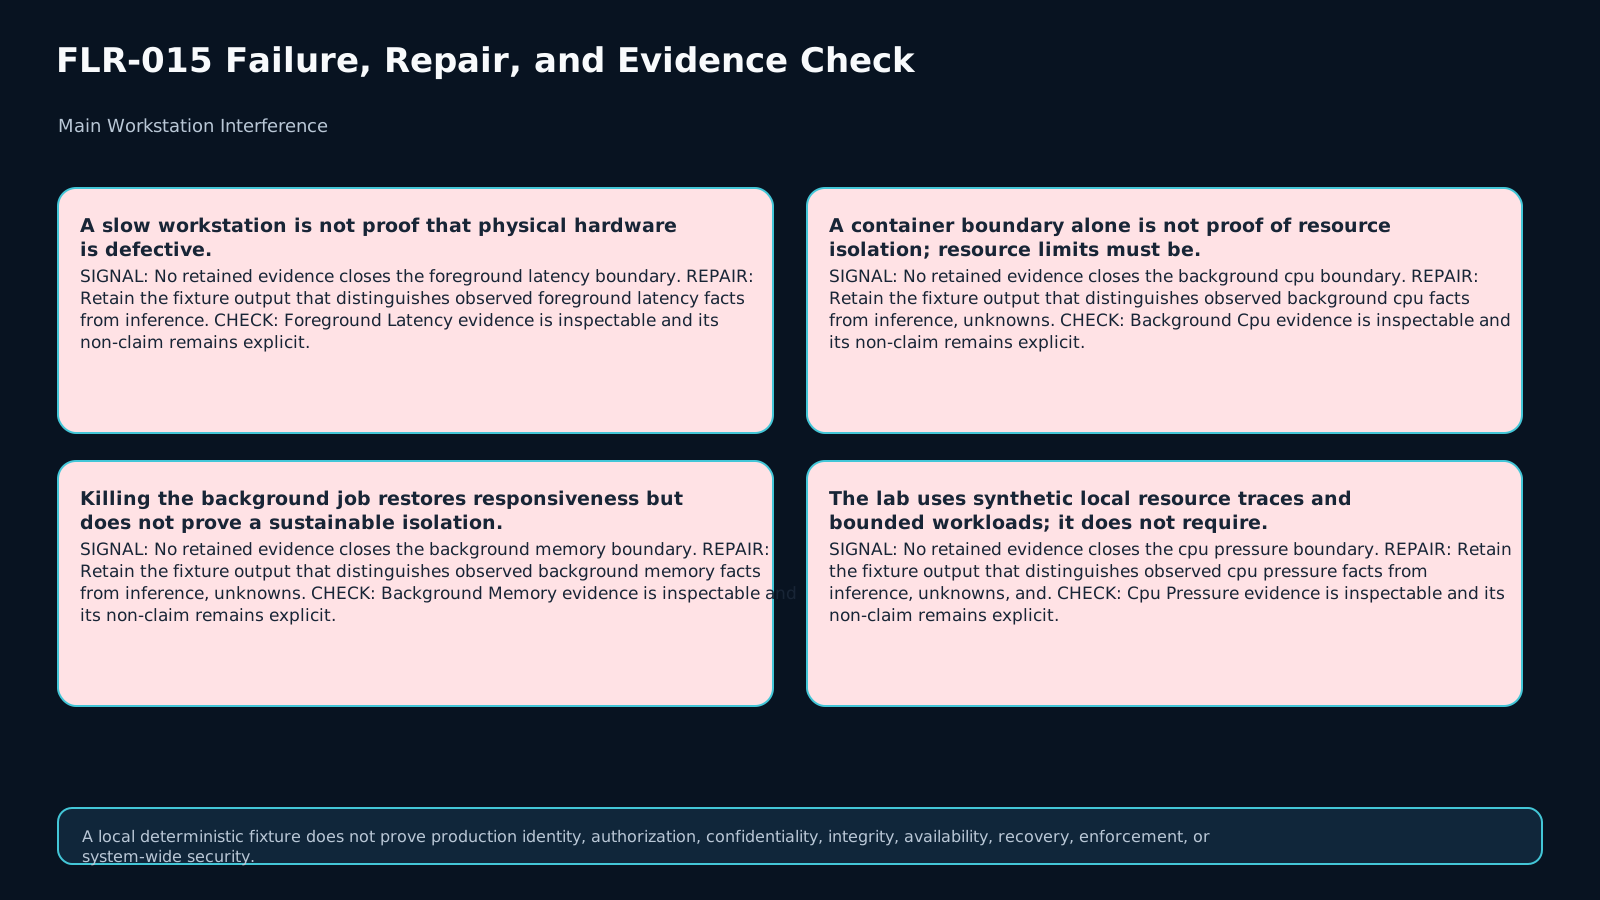
Docker بهطور پیشفرض resource constraint سختی برای container نمیگذارد و workload میتواند از CPU و memory میزبان تا حدی که scheduler/kernel اجازه میدهد استفاده کند. بنابراین «داخل container است» proof ایزولهبودن نیست؛ باید limit واقعی مثل CPU quota یا memory boundary تنظیم و سپس اثر آن مشاهده شود.
4. CPU saturation را با interference یکی نگیرید
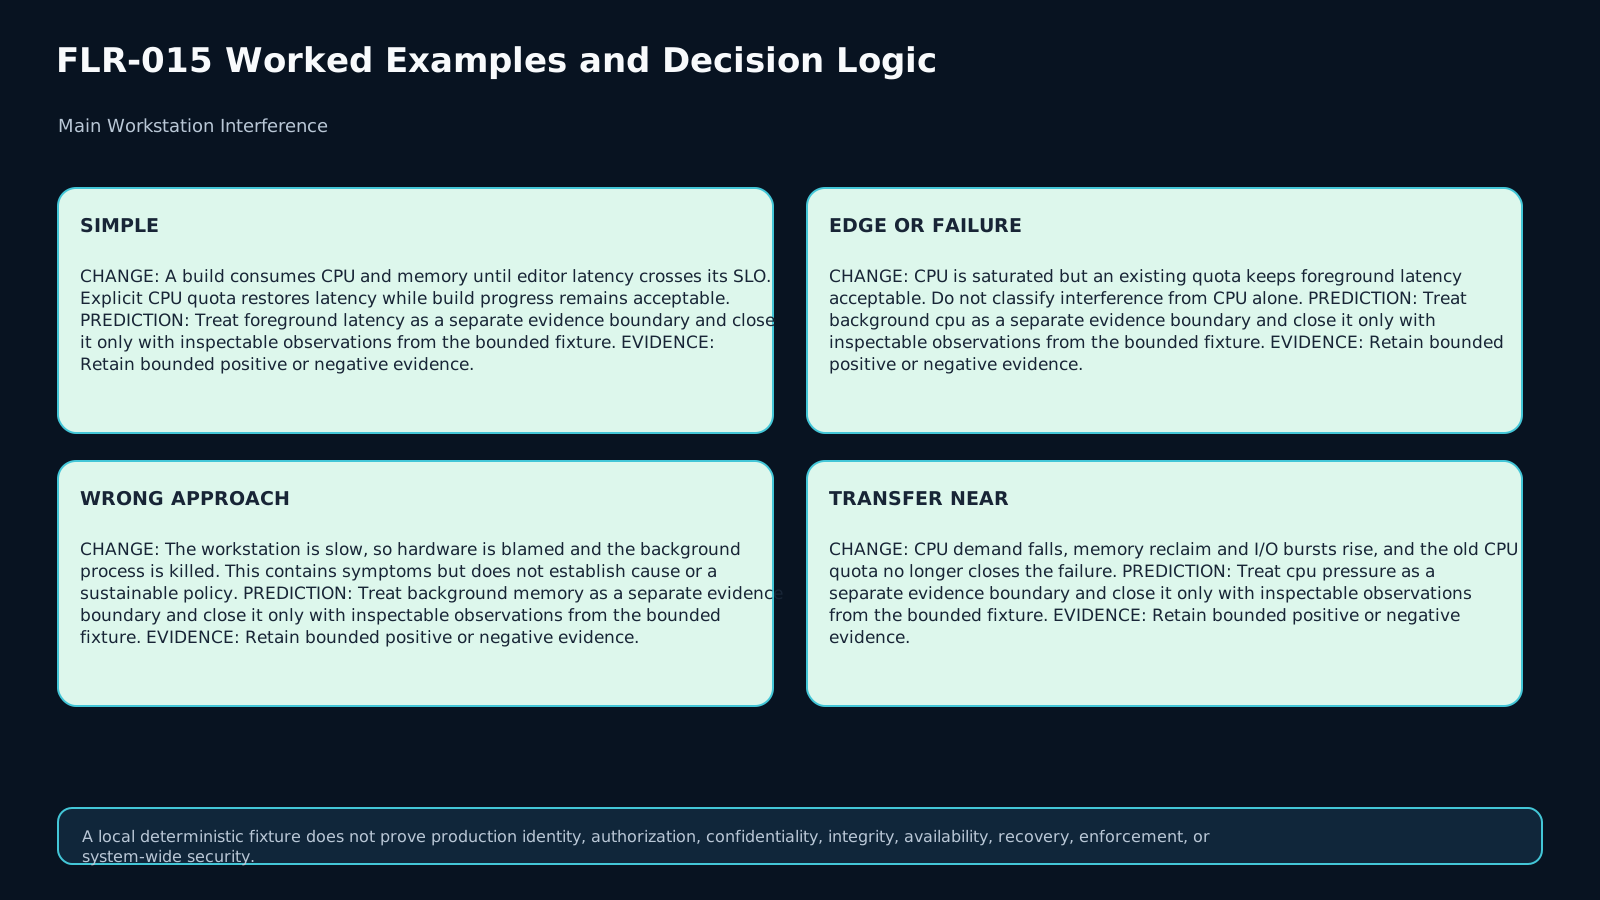
CPU بالا میتواند کاملاً سالم باشد. اگر foreground latency هنوز زیر SLO است و background progress هم قابلقبول است، صرف 95% CPU دلیل failure نیست. برای CPU_INTERFERENCE باید هم نقض responsiveness و هم evidence متناسبِ CPU pressure/contention وجود داشته باشد.
5. memory pressure semantics مهمتر از مصرف خام است
در cgroup v2، memory.high یک مرز throttling/reclaim است و memory.max یک hard limit نهاییتر. مصرف بالای memory بدون pressure الزاماً failure نیست؛ اما latency بالا همراه با reclaim/pressure یا limit event میتواند به MEMORY_INTERFERENCE اشاره کند. memory signal را از CPU signal جدا نگه دارید.
6. I/O burst میتواند علت را عوض کند
یک workload ممکن است CPU کمی مصرف کند اما با write burst، indexing یا swap/reclaim I/O باعث stall تعاملی شود. اگر transfer fixture CPU پایین دارد ولی I/O pressure بالا رفته، تکرار CPU quota قبلی بدون بررسی I/O یک overfit است. classifier باید dominant pressure را از evidence جدید بسازد.
7. limit event با root cause یکی نیست
Throttling، memory-high event یا حتی OOM event observation مهمی است، اما خودش بهتنهایی causal proof کامل نیست. باید ببینید قبل و بعد از event، foreground latency، pressure و background progress چه تغییری کردهاند. یک limit ممکن است containment بدهد ولی هنوز policy نامناسب باشد.
8. Workstation Resource Isolation & Responsiveness Record v1
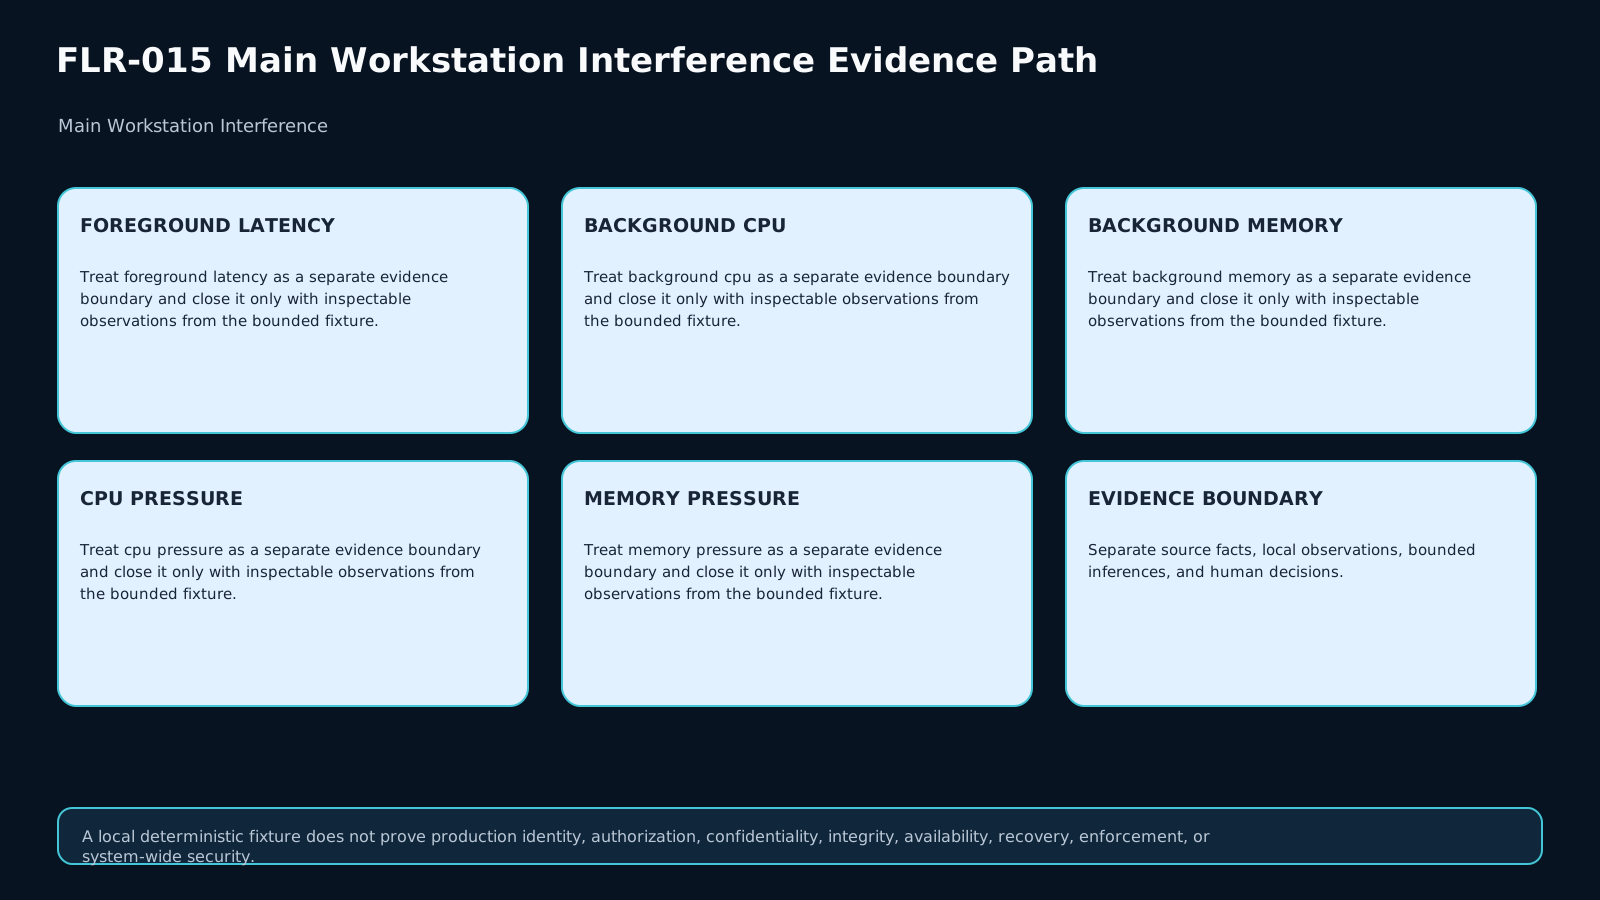
Artifact اصلی درس این فیلدها را نگه میدارد: foreground latency، background CPU، background memory، CPU/memory/I/O pressure، limit configuration، throttle/OOM event، background progress، host responsiveness، negative control و closure replay. هر تصمیم باید به observation یا authority وصل شود و UNKNOWN صریح بماند.
9. isolation policy باید bounded باشد
Policy خوب فقط workstation را responsive نمیکند؛ باید background job هم حداقل progress اعلامشده را حفظ کند. اگر limit بیشازحد سخت editor را نجات دهد ولی build عملاً متوقف شود، closure معتبر نیست و state باید OVERCONSTRAINED یا REPAIR_POLICY باقی بماند.
10. negative control جلوی تشخیص تکسیگنالی را میگیرد
یک fixture عمداً CPU را بالا میبرد اما با quota فعال، foreground latency زیر SLO میماند. نتیجه درست این نیست که «CPU بالا پس interference». negative control نشان میدهد classification باید joint evidence داشته باشد: latency violation + pressure/limit evidence + اثر mitigation.
11. containment با closure فرق دارد
Kill کردن background process میتواند workstation را فوراً responsive کند، اما فقط containment است. Closure باید همان workload یا یک replay bounded را تحت policy مشخص اجرا کند و نشان دهد foreground SLO و background progress هر دو برقرارند و failure به شکل پایدار برنمیگردد.
12. classificationهای Lab
Lab این outcomeها را استفاده میکند: NO_FOREGROUND_INTERFERENCE، CPU_INTERFERENCE، MEMORY_INTERFERENCE، IO_INTERFERENCE، MIXED_INTERFERENCE و INTERFERENCE_UNRESOLVED. اگر foreground SLO نقض نشده باشد، resource usage بالا بهتنهایی failure را باز نمیکند. اگر SLO نقض شود ولی pressure evidence کافی نباشد، classification باید unresolved بماند.
13. closure oracle دو معیار دارد
پس از policy change، evaluator حداقل دو چیز را میسنجد: post_limit_foreground_latency <= SLO و post_limit_background_progress >= declared minimum. علاوه بر آن OOM جدید نباید رخ دهد. این طراحی مانع میشود mitigationای که فقط یک طرف مسئله را بهتر کرده، PASS بگیرد.
14. Lab: هشت fixture و 64 assertion
هشت fixture شامل baseline سالم، CPU interference، CPU-high negative control، memory-pressure failure، I/O transfer failure، mixed pressure، policy بیشازحد سخت و closure موفق هستند. evaluator برای هر case هشت خروجی مستقل میدهد و test مدیریتی دقیقاً 64 assertion را بررسی میکند.
15. Exit checklist و transfer
قبل از خروج باید بتوانید نشان دهید: foreground SLO چیست، background resource evidence کدام است، dominant pressure چگونه تعیین شد، containment کدام است، background progress چه حدی دارد و closure با چه replay مستقلی ثابت شد. در transfer، CPU demand کمتر میشود اما memory reclaim و I/O burst بالا میرود؛ policy باید از evidence جدید ساخته شود، نه از پاسخ fixture قبلی.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
Q1 retrieval
Why does putting a heavy task in a container not automatically isolate the workstation?
Q2 application
Background CPU is 96% but foreground latency remains under the SLO. Is this CPU interference?
Q3 diagnosis
Foreground latency is high, CPU demand is moderate, memory pressure is high and reclaim events occur. Which boundary should be investigated first?
Q4 decision
A strict limit restores foreground latency but background progress falls below its declared minimum. Is closure achieved?
Q5 transfer
The transfer fixture lowers CPU but adds memory reclaim and I/O bursts. What must change?
ملاکهای ارزیابی (rubric)
A sufficient response must preserve the owned failure boundary and use evidence rather than a single utilization signal.
- Boundary and attribution — critical: distinguishes foreground responsiveness from background workload resource evidence.
- Pressure discrimination — critical: separates CPU, memory and I/O pressure and keeps unsupported cause claims OPEN.
- Bounded containment — critical: chooses explicit resource limits or scheduling rather than relying on container presence or process termination alone.
- Closure — critical: foreground latency meets its SLO, background progress meets its minimum, and no new OOM failure appears under replay.
- Transfer — critical: changed-context policy is rebuilt from new evidence rather than copied from the baseline.
Any missing critical dimension is insufficient even if the prose is confident.
منابع و تازگی
مطالعهٔ موارد (case studies)
تصاویر درس
فایلهای آزمایشگاه
Use only the supplied synthetic fixtures. Implement evaluate(case) in starter.py so that classification follows foreground latency plus per-workload CPU/memory/I/O pressure evidence rather than raw utilization alone.
Your result must expose eight fields: classification, latency_state, dominant_pressure, containment, closure_state, host_responsiveness, background_progress_state, and next_action.
The fixture set includes a high-CPU negative control, a changed-context memory/I/O case, an over-constrained policy, and successful closure. Do not run destructive stress tests on a real workstation.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)