امنیت، هویت، استقرار و تابآوری · فصل ۹ — Resource، Provider، Cost و Organizational Failure · 126
Artifact Loss/Corruption
failure را بعد از وقوع و بهصورت موردی تحلیل میکند و هنوز detection، containment و repair path از قبل طراحی نشده است. موضوع جاری: «Artifact Loss/Corruption». میتواند failure family «Artifact Loss/Corruption» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
خلاصهٔ درس
failure را بعد از وقوع و بهصورت موردی تحلیل میکند و هنوز detection، containment و repair path از قبل طراحی نشده است. موضوع جاری: «Artifact Loss/Corruption».
میتواند failure family «Artifact Loss/Corruption» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
خروجی این درس
میتواند failure family «Artifact Loss/Corruption» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
1. اسم فایل هویت artifact نیست
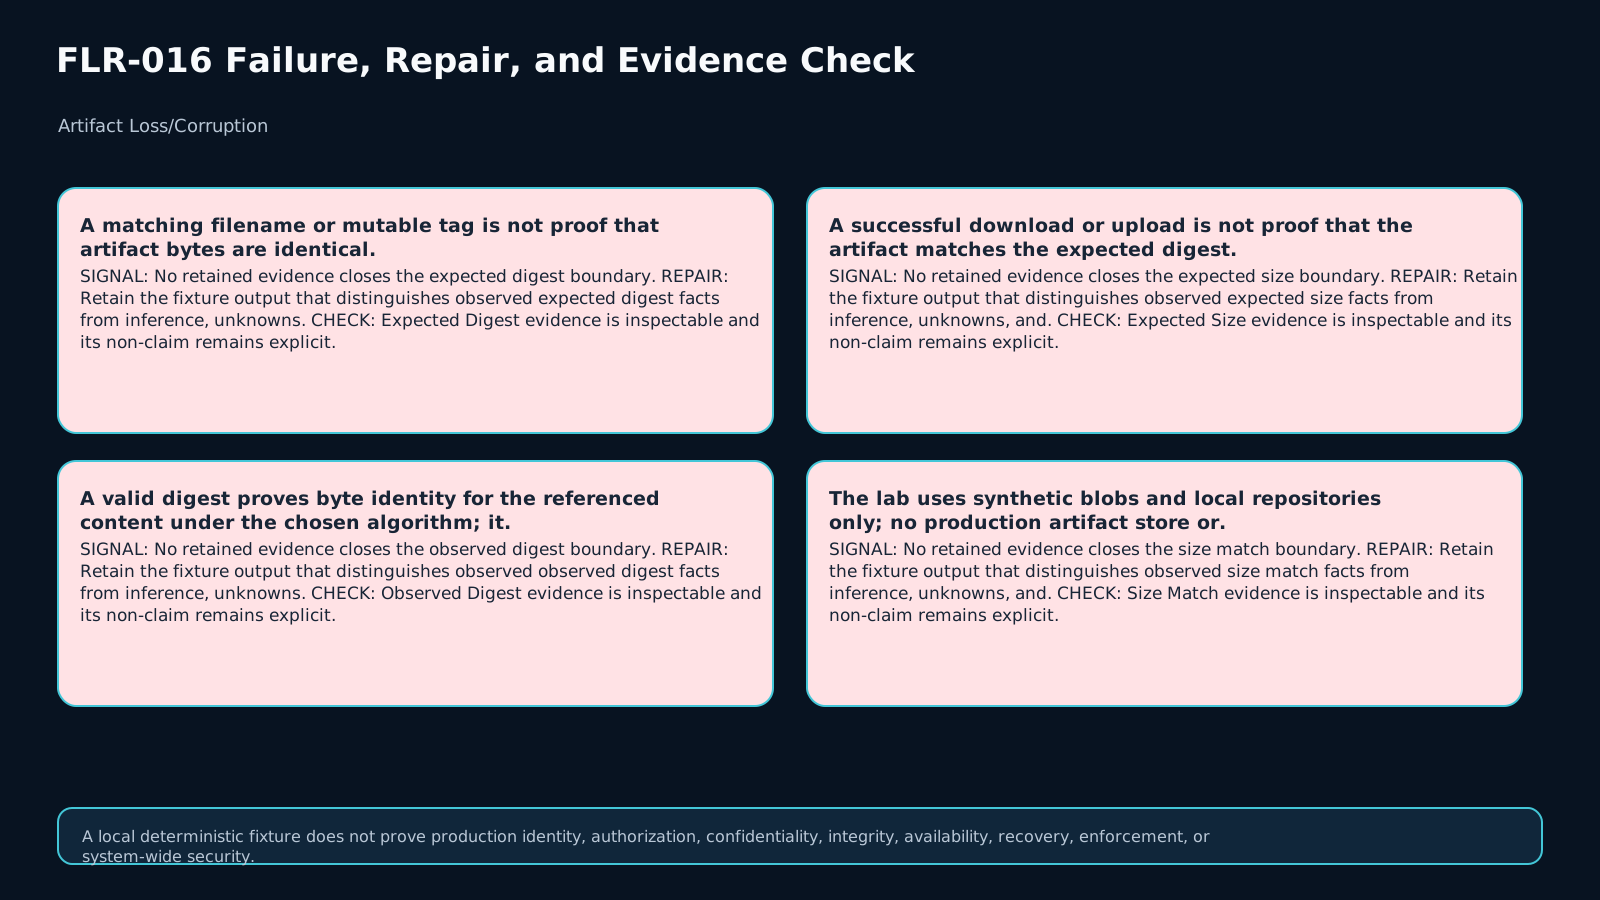
یک build artifact ممکن است با همان filename، tag یا version string قبلی وجود داشته باشد ولی bytes آن عوض شده باشد. بنابراین diagnosis را از expected immutable identity شروع کنید: digest مورد انتظار، size مورد انتظار، locator/reference و provenance شناختهشده. نام و tag فقط locator یا label هستند، نه proof هویت.
2. سه محور را مستقل نگه دارید
برای هر artifact سه سؤال جدا بپرسید: آیا قابل دسترسی است؟ آیا bytes با identity مورد انتظار match هستند؟ آیا provenance مورد انتظار برای این bytes وجود دارد؟ پاسخ مثبت به یکی، دو محور دیگر را ثابت نمیکند. این تفکیک جلوی false recovery را میگیرد.
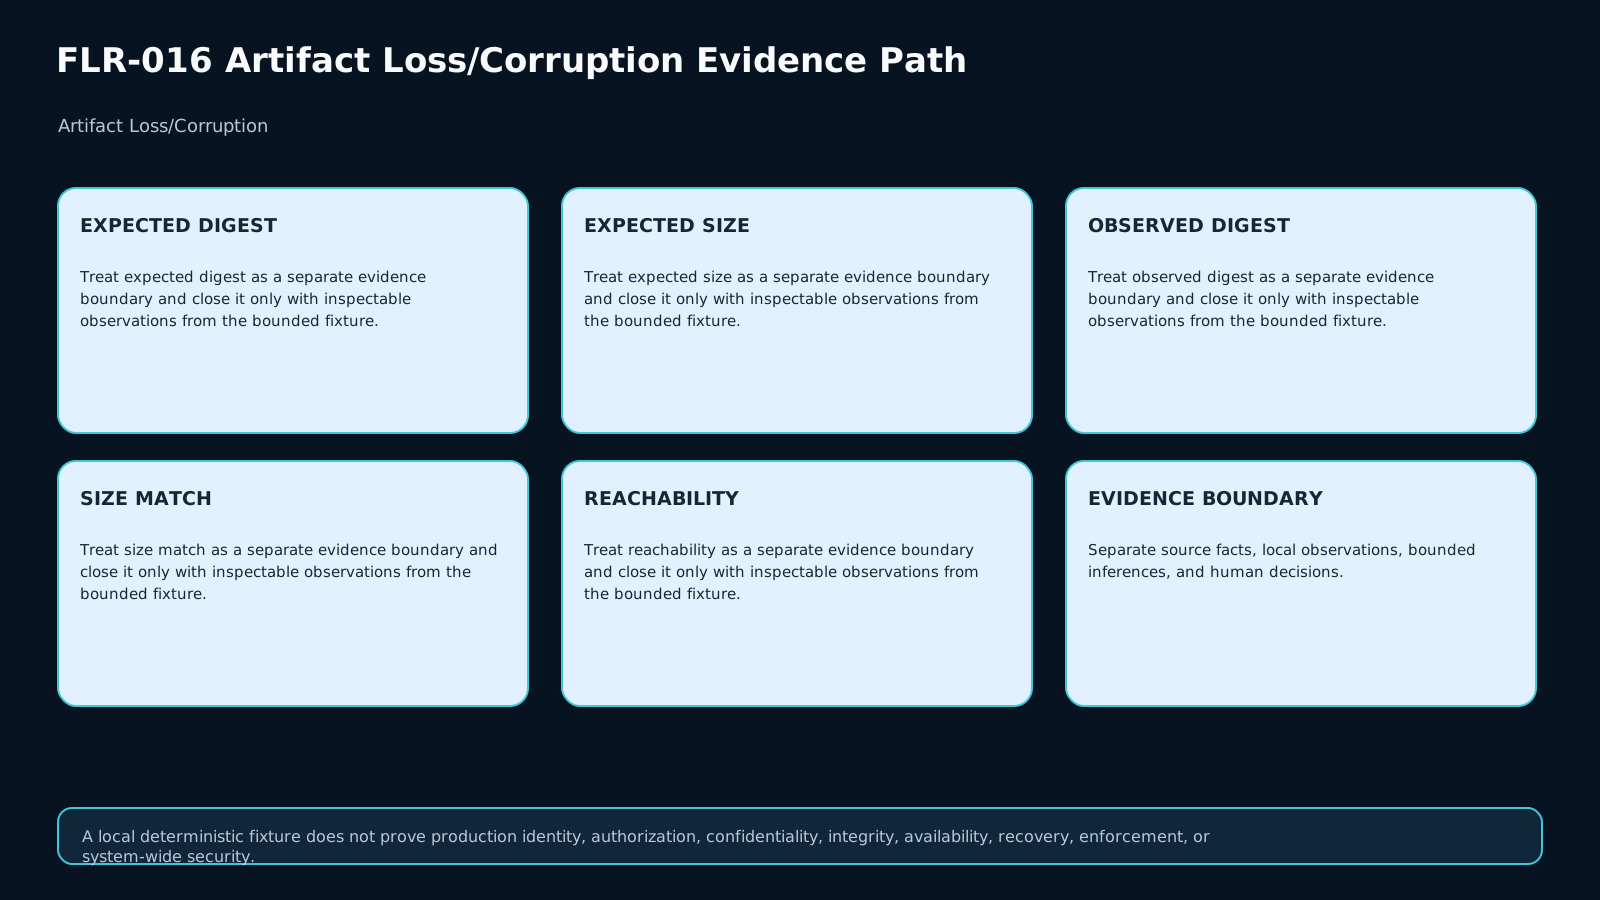
3. Expected digest و size را قبل از recovery قفل کنید
اگر expected digest یا size معلوم نیست، مقایسهٔ بعدی authority ندارد. OCI Content Descriptor دقیقاً digest و size را بهعنوان ویژگیهای required محتوای referenced نگه میدارد و توصیه میکند content بازیابیشده پیش از اعتماد با آنها verify شود. در این درس، sha256 identity اصلی fixture است؛ الگوریتم دیگر فقط اگر authority همان را اعلام کند قابل استفاده است.
4. Reachability را از integrity جدا کنید
Artifact میتواند missing/unreachable باشد اما هیچ evidenceی از corruption نداشته باشیم؛ برعکس میتواند کاملاً reachable باشد ولی digest اشتباه داشته باشد. 404، نبود فایل یا شکستن tag مسیر reachability را توصیف میکند؛ digest/size مسیر byte integrity را.
5. Size mismatch یک signal اولیه است، نه کل تشخیص
اگر observed size با expected size فرق دارد، content نباید trusted شود. این حالت معمولاً truncation، partial upload یا replacement را محتمل میکند، ولی classification نهایی باید digest و context را هم ببیند. Size match هم کافی نیست: دو payload میتوانند هماندازه و byte-different باشند.
6. Digest mismatch را قرنطینه کنید
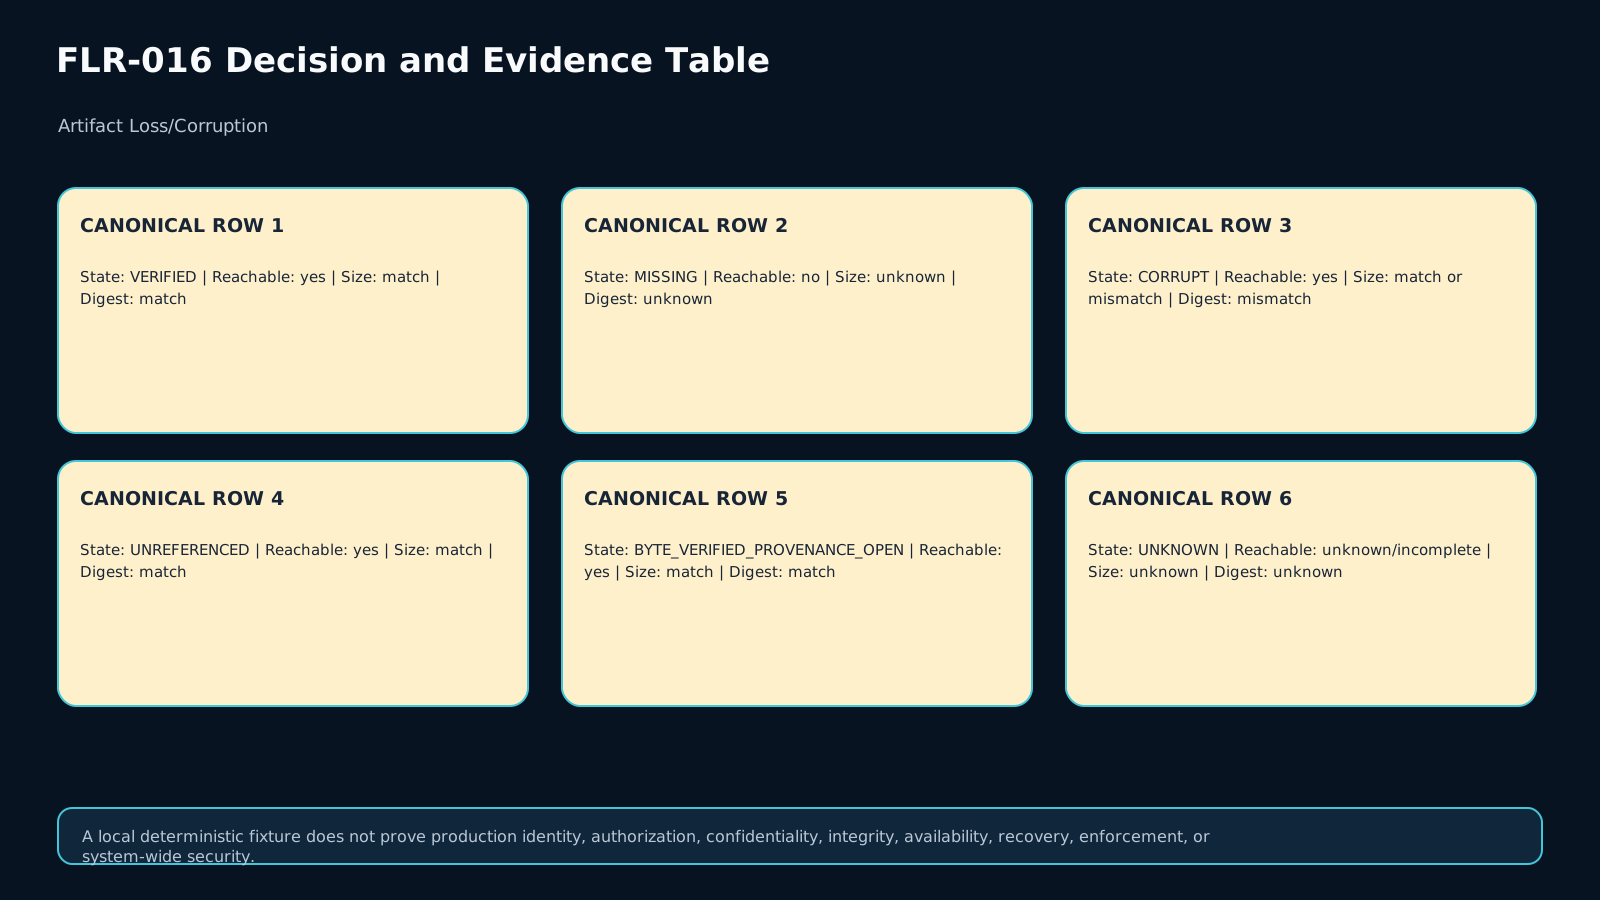
وقتی artifact reachable است ولی digest محاسبهشده با expected digest فرق دارد، state اصلی این درس CORRUPT است و artifact باید از release path خارج شود. نام درست، tag درست، upload success یا حتی size match نباید quarantine را دور بزند. recovery فقط از source مورد اعتماد یا rebuild قابلردیابی انجام میشود.
7. Unreferenced با missing فرق دارد
گاهی bytes صحیح هنوز در store وجود دارند و digest/size match میشوند، اما mutable tag یا release reference دیگر به آنها اشاره نمیکند. این حالت UNREFERENCED است، نه MISSING و نه CORRUPT. repair مناسب معمولاً restore/rebind reference و سپس reverification است، نه دانلود یک فایل همنام از منبع ناشناخته.
8. Byte integrity با provenance یکی نیست
ممکن است digest و size دقیقاً match باشند اما provenance link، build attestation یا chain-of-custody مورد انتظار حذف شده باشد. در این حالت bytes میتوانند BYTE_VERIFIED باشند ولی release همچنان blocked بماند. Digest نمیگوید artifact از source revision و build recipe موردنظر ساخته شده یا execution آن امن است.
9. Git fsck یک concrete integrity oracle است
در Git object database، git fsck connectivity و validity objectها را بررسی میکند و میتواند missing <type> <object> یا hash mismatch <object> گزارش دهد. این یک مثال رسمی از جداکردن missing/reachability از integrity failure است؛ اما universal verifier برای همه artifact storeها نیست.
10. Recovery source باید trusted و مشخص باشد
برای MISSING یا CORRUPT، recovery نباید با «هر نسخهای که پیدا شد» انجام شود. Record باید trusted recovery source را مشخص کند: snapshot شناختهشده، rebuild از source revision/recipe قفلشده، یا replicaای که identity مستقل آن verify شده است. اگر source اعتمادپذیر نداریم، state BLOCK_AND_ESCALATE باقی میماند.
11. Artifact Integrity, Reachability & Recovery Record v1
Artifact اصلی این درس ۱۲ بُعد دارد: expected digest، expected size، observed digest، size match، reachability، reference state، provenance state، integrity classification، trusted recovery source، quarantine state، reverification و release state. هر cell باید observation، authority، inference یا UNKNOWN باشد؛ UNKNOWN بهصورت خودکار به PASS تبدیل نمیشود.
12. Classification را از evidence بسازید
Outcomeهای اصلی Lab عبارتاند از VERIFIED، MISSING، CORRUPT، UNREFERENCED، BYTE_VERIFIED_PROVENANCE_OPEN و UNKNOWN. اول reachability و expected identity را تثبیت کنید، بعد size/digest، سپس reference و provenance را بررسی کنید. Classification نباید صرفاً از filename، tag یا یک message ساخته شود.
13. Containment با closure فرق دارد
Quarantine کردن blob خراب containment است؛ restore کردن یک copy هم هنوز closure نیست. Closure وقتی معتبر است که recovered bytes دوباره independently با expected size/digest verify شوند، reference state موردنیاز درست باشد و provenance requirement نیز یا restore شده باشد یا صریحاً OPEN بماند. Release قبل از این gate ممنوع است.
14. Lab: هشت fixture و 64 assertion
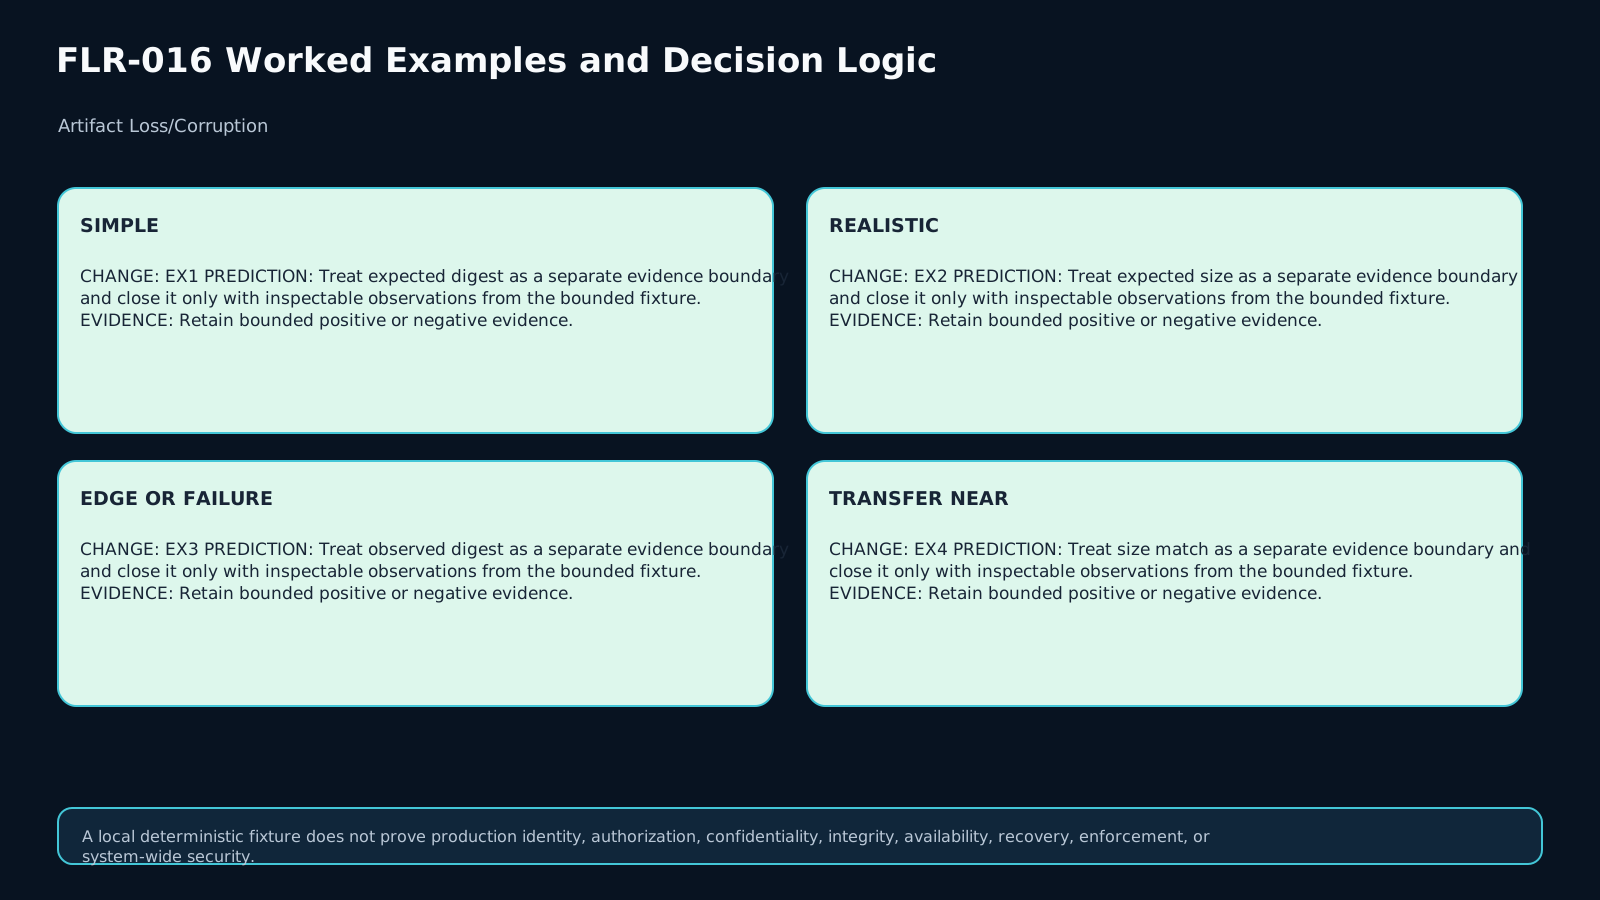
Lab کاملاً local و synthetic است. هشت fixture شامل baseline verified، blob مفقود، same-name digest mismatch، blob صحیح ولی unreferenced، payload truncated، bytes صحیح با provenance گمشده، transfer با تغییر یک بایت و transfer با حذف provenance است. evaluator برای هر case هشت field خروجی میدهد و تست مدیریتی در مجموع 64 assertion را بررسی میکند.
15. Exit checklist و انتقال
قبل از خروج باید بتوانید توضیح دهید expected identity از کجا آمده، reachability و integrity چرا مستقلاند، چه artifactی quarantine میشود، trusted recovery source چیست و closure با چه reverification مستقلی ثابت میشود. در transfer، همه filenameها و tagها حفظ میشوند اما یک payload یک بایت عوض میشود و provenance payload دیگری حذف میشود؛ record باید بدون اتکا به ظاهر نامها از نو ساخته شود.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
Q1 retrieval
Why is a matching filename or mutable tag not proof of artifact identity?
Q2 application
A blob is reachable, has the expected size, but its sha256 differs. How should it be classified?
Q3 diagnosis
A blob has matching digest and size but the release tag no longer points to it. Is it missing?
Q4 decision
Why can matching digest/size still be insufficient for release?
Q5 transfer
All names/tags stay the same, one payload changes by one byte, and another loses provenance. What changes?
ملاکهای ارزیابی (rubric)
A sufficient response anchors every decision to expected immutable identity, keeps reachability, byte integrity, reference state, and provenance separate, preserves UNKNOWN when evidence is absent, quarantines mismatches, identifies a trusted recovery source, and distinguishes containment from closure. Closure requires an independent post-recovery size/digest check plus any required reference/provenance evidence. Transfer must classify the one-byte mutation and provenance removal from fresh evidence rather than trusting unchanged filenames or tags.
منابع و تازگی
مطالعهٔ موارد (case studies)
تصاویر درس
فایلهای آزمایشگاه
Implement the bounded evaluator in starter.py for the eight supplied synthetic cases. No network calls, credentials, production artifact stores, or destructive deletion are required. Keep reachability, byte integrity, reference state, and provenance independent. A matching filename/tag is not byte identity; a successful read is not digest verification; and a matching digest does not prove provenance. Quarantine mismatches, use only declared trusted recovery sources, and require an independent post-recovery verification before release.
Run python run_checks.py to verify fixture shape before implementing the evaluator.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)