امنیت، هویت، استقرار و تابآوری · فصل ۹ — Resource، Provider، Cost و Organizational Failure · 124
GPU Overload/OOM
failure را بعد از وقوع و بهصورت موردی تحلیل میکند و هنوز detection، containment و repair path از قبل طراحی نشده است. موضوع جاری: «GPU Overload/OOM». میتواند failure family «GPU Overload/OOM» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
خلاصهٔ درس
failure را بعد از وقوع و بهصورت موردی تحلیل میکند و هنوز detection، containment و repair path از قبل طراحی نشده است. موضوع جاری: «GPU Overload/OOM».
میتواند failure family «GPU Overload/OOM» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
خروجی این درس
میتواند failure family «GPU Overload/OOM» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
پیشنیازها
1. کندی GPU یا utilization بالا، بهتنهایی OOM را ثابت نمیکند
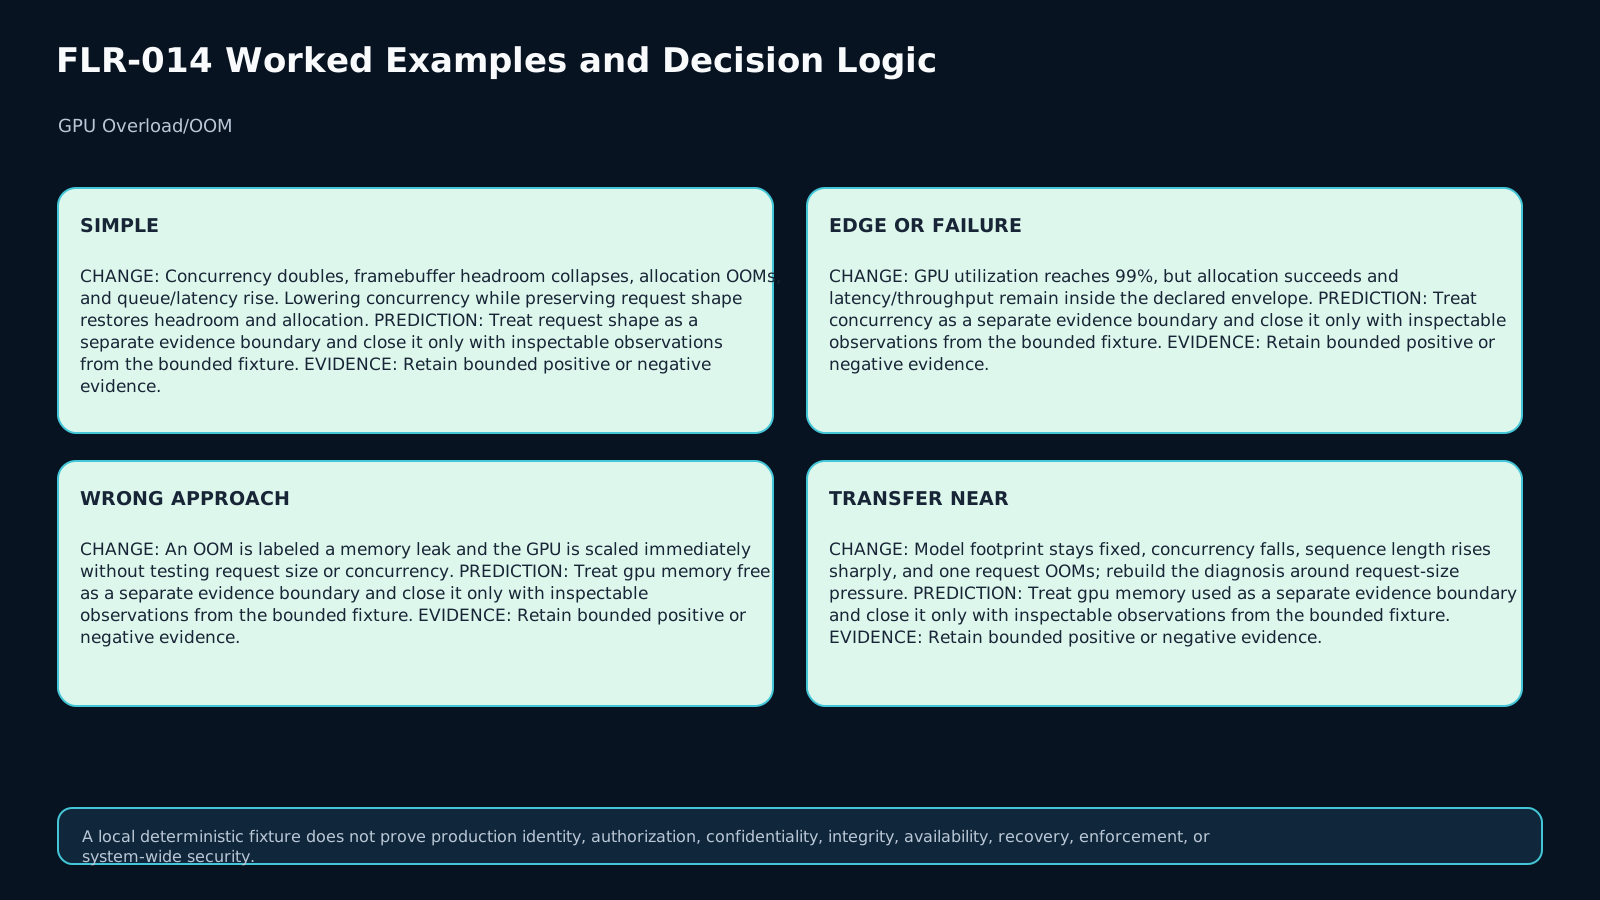
در یک workload مبتنی بر GPU ممکن است utilization به ۹۹٪ برسد و سیستم هنوز سالم کار کند. برعکس، یک درخواست بزرگ یا جهش concurrency میتواند allocation را شکست دهد حتی وقتی نمودار utilization بهتنهایی علت را روشن نمیکند. نقطه شروع این درس، تشخیص بر اساس allocation result، حافظه framebuffer، شکل درخواست، concurrency و رفتار latency/throughput است؛ نه تفسیر یک نمودار منفرد.
2. مرز شواهد را قبل از درمان مشخص کنید
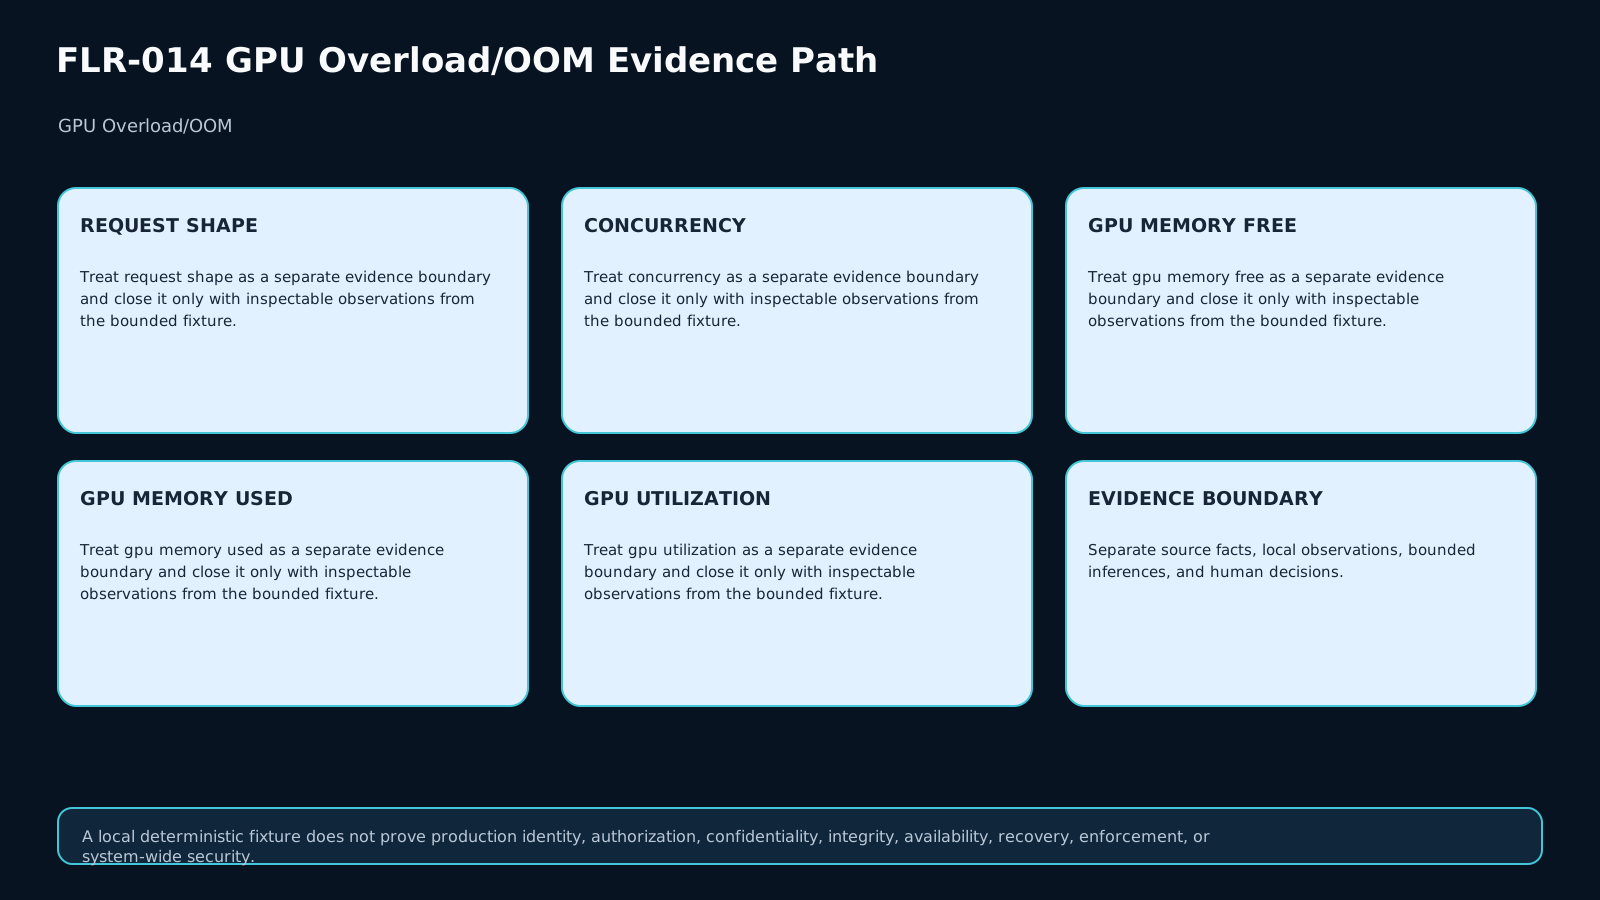
برای هر run حداقل اینها را ثبت کنید: model footprint، batch یا request shape، sequence length، concurrency، framebuffer total/used/free، GPU utilization، allocation result، queue depth، latency و throughput. سپس هر گزاره را به یکی از چهار حالت وصل کنید: مشاهده مستقیم، سند معتبر، استنباط، یا UNKNOWN. اگر یکی از ابعاد تعیینکننده غایب است، علت را قطعی نکنید.
3. GPU utilization بالا با کمبود حافظه یکی نیست
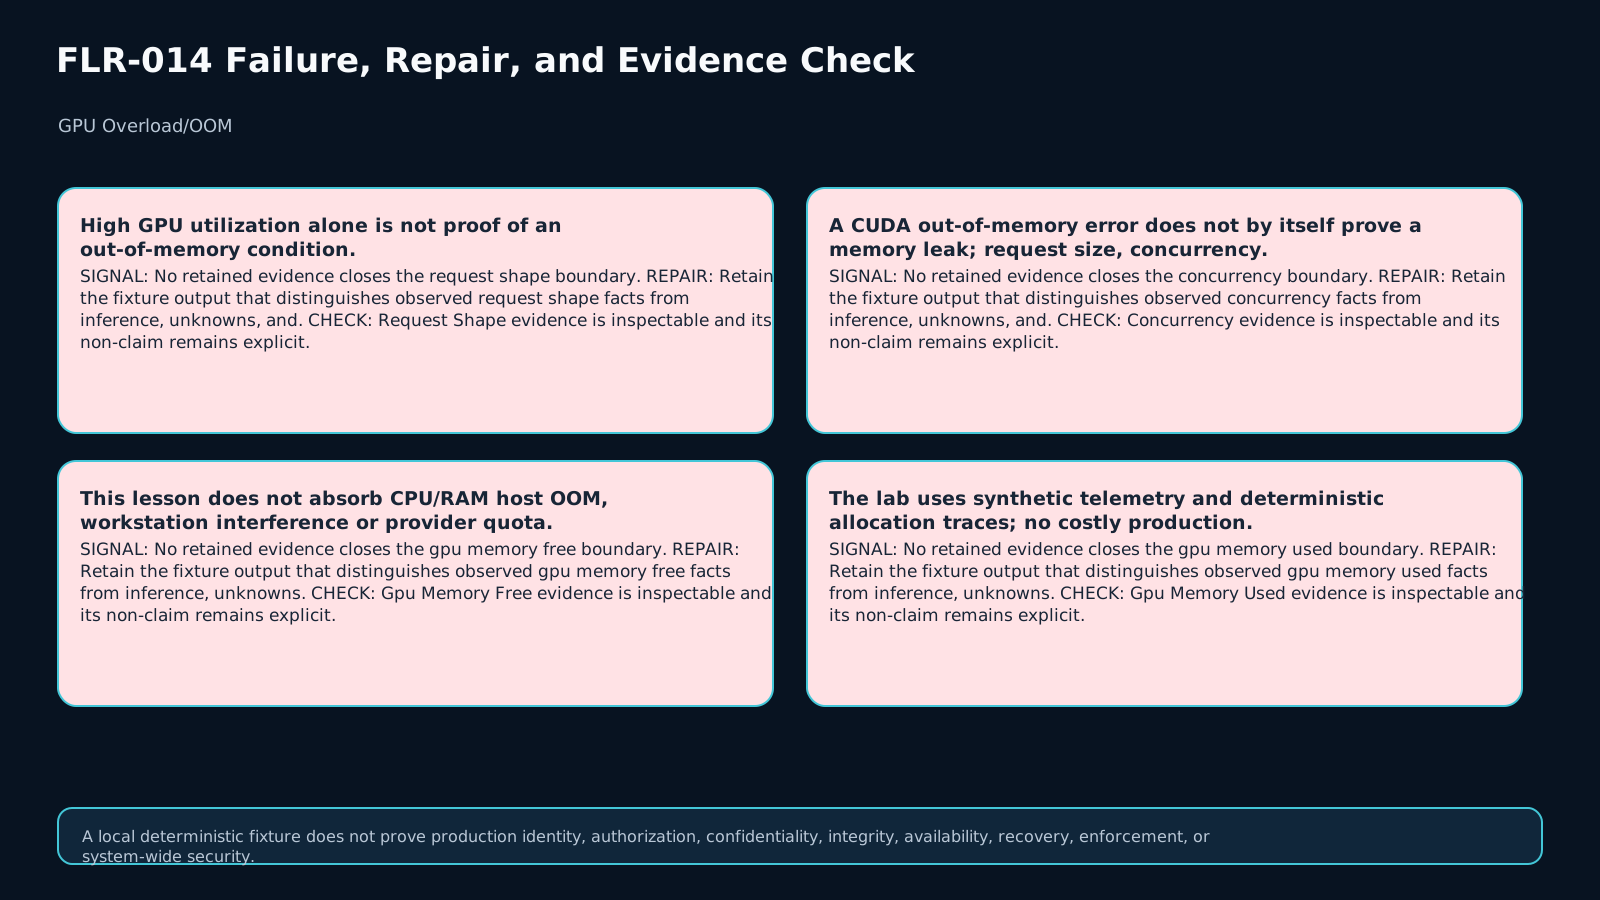
Utilization نشان میدهد GPU چهقدر درگیر کار است، نه اینکه allocation حافظه حتماً شکست خورده است. یک negative control میتواند utilization بسیار بالا، allocation موفق و latency داخل SLO داشته باشد. بنابراین «GPU نزدیک ۱۰۰٪ است» فقط یک سیگنال ظرفیت/محاسبه است و بهتنهایی مجوز scale کردن یا اعلام OOM نیست.
4. framebuffer headroom را جدا از compute saturation ببینید
Telemetry انویدیا memory free/used/total و GPU utilization را بهصورت سیگنالهای جدا ارائه میکند. headroom کم، وقتی با allocation failure و تغییر load همراستا میشود، evidence قویتری برای pressure حافظه است. اما حتی framebuffer کم نیز بهتنهایی causal proof کامل نیست؛ باید request shape و concurrency را هم کنار آن دید.
5. cudaErrorMemoryAllocation مرز خطا را میگوید، نه root cause برنامه را
در CUDA Runtime، cudaErrorMemoryAllocation یعنی API نتوانسته حافظه یا منابع کافی برای عملیات درخواستی تخصیص دهد. این خطا نمیگوید علت حتماً memory leak است. oversized request، concurrency burst، allocator state، fragmentation hypothesis یا footprint ثابت مدل میتوانند مسیرهای متفاوتی به یک allocation failure بسازند.
6. request shape و concurrency دو اهرم متفاوت فشار حافظهاند
اگر footprint مدل ثابت باشد، افزایش sequence length یا batch size میتواند حافظه هر درخواست را بالا ببرد؛ افزایش concurrency نیز میتواند چند allocation را همزمان روی همان ظرفیت سوار کند. برای تشخیص، این دو را جدا تغییر دهید. اگر با کاهش concurrency خطا بسته میشود ولی request shape ثابت است، فرضیه concurrency قویتر میشود؛ اگر در concurrency پایین یک درخواست بسیار بزرگ OOM میشود، مرز request-size جدیتر است.
7. queue، latency و throughput نشان میدهند مشکل فقط «حافظه» نیست
Queue depth و latency بالا میتواند از compute saturation، admission نامناسب یا bottleneck خارج از GPU هم بیاید. اگر GPU utilization متوسط است، allocation موفق است و queue همچنان رشد میکند، این درس نباید مشکل را به زور GPU OOM نامگذاری کند. در چنین حالتی classification باید NON_GPU_BOTTLENECK یا GPU_CAPACITY_UNRESOLVED بماند تا evidence جدید برسد.
8. GPU Capacity Failure Diagnosis & Recovery Record v1
Artifact اصلی درس یک رکورد قابل ممیزی است: request shape، concurrency، framebuffer headroom، utilization، allocation result، queue، latency، throughput، capacity hypothesis، negative control، containment action، closure probe و residual risk. هدف رکورد این نیست که همه چیز را قطعی کند؛ هدف این است که معلوم باشد دقیقاً چه چیزی ثابت شده، چه چیزی رد شده و چه چیزی هنوز باز است.
9. حداقل دو توضیح رقیب بسازید
وقتی OOM یا stall میبینید، فقط یک توضیح ننویسید. مثلاً «concurrency memory pressure» را در کنار «oversized request» یا «compute saturation بدون OOM» قرار دهید. سپس یک contrast probe طراحی کنید که فقط یک مرز را عوض کند. تشخیص خوب، یک alternative را با evidence منفی رد میکند؛ تشخیص ضعیف، همان علامت اول را به علت تبدیل میکند.
10. negative control جلوی تشخیص تکسیگنالی را میگیرد
یک fixture با utilization ۹۹٪، allocation موفق و performance داخل envelope عمداً وجود دارد. اگر classifier آن را OOM یا failure ظرفیت اعلام کند، منطق بیشازحد به utilization وابسته است. negative control باید نشان دهد signal بالا میتواند در حالت سالم هم دیده شود و تصمیم نیاز به joint evidence دارد.
11. containment باید محدود، قابل برگشت و متناسب با evidence باشد
برای concurrency pressure میتوان admission یا concurrency cap را امتحان کرد. برای oversized request میتوان request budget، sequence length یا batch را محدود کرد. برای compute saturation بدون OOM، queue/batching/capacity review مطرح است. Batching همیشه درمان نیست و ممکن است memory demand را بالا ببرد؛ بنابراین هر تغییر باید bounded باشد و با telemetry بعد از تغییر سنجیده شود.
12. containment با recovery closure فرق دارد
یک درخواست سبز بعد از تغییر تنظیمات کافی نیست. Closure زمانی معتبر است که changed-load rerun نشان دهد allocation موفق است، memory headroom به محدوده اعلامشده برگشته، latency داخل SLO است، throughput از حداقل پایینتر نیفتاده و failure در replay برنمیگردد. اگر فقط symptom حذف شده اما performance یا headroom هنوز نامعتبر است، state باید باز بماند.
13. classificationهای Lab
Lab از این outcomeها استفاده میکند: CAPACITY_HEALTHY، HIGH_UTILIZATION_NO_FAILURE، CONCURRENCY_MEMORY_PRESSURE، REQUEST_SIZE_MEMORY_PRESSURE، COMPUTE_SATURATION_NO_OOM، NON_GPU_BOTTLENECK و GPU_CAPACITY_UNRESOLVED. هیچکدام از روی utilization تنها انتخاب نمیشوند. allocation failure، headroom، request/concurrency identity و performance باید با هم خوانده شوند.
14. Lab: هشت fixture و 64 assertion
هشت fixture شامل baseline سالم، high-util negative control، concurrency OOM باز، concurrency OOM بستهشده، single oversized request، compute saturation بدون OOM، bottleneck خارج از GPU و یک OOM مبهم هستند. evaluator برای هر case هشت خروجی مستقل میدهد و test مدیریتی دقیقاً ۶۴ assertion را بررسی میکند. Lab کاملاً synthetic است و به GPU واقعی نیاز ندارد.
15. Exit checklist و transfer
قبل از خروج باید بتوانید بگویید: allocation failure دقیقاً کجا دیده شد، framebuffer headroom چه بود، request shape و concurrency چه نقشی داشتند، کدام alternative رد شد، containment چه بود و closure با چه changed-load rerun ثابت شد. در transfer، footprint مدل ثابت میماند اما sequence length بالا و concurrency پایین میآید؛ اگر مرز غالب از concurrency به request-size منتقل شد، diagnosis و containment نیز باید عوض شوند.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
Q1 retrieval
Why is 99% GPU utilization not enough to diagnose OOM?
Q2 application
Concurrency doubles, framebuffer free memory collapses, and allocation returns OOM. What evidence should be changed first to test concurrency pressure?
Q3 diagnosis
A single long request OOMs at concurrency 1 while the same model handles shorter requests. Which boundary becomes more plausible?
Q4 decision
After a concurrency cap, allocation succeeds but throughput falls below the declared minimum. Is recovery closed?
Q5 transfer
GPU utilization is moderate, allocation succeeds, but queue and latency rise sharply. What should the GPU-OOM classifier do?
ملاکهای ارزیابی (rubric)
A sufficient response preserves the GPU-capacity boundary and does not convert a single utilization or error signal into a complete root cause.
- Boundary and evidence — critical: ties the classification to allocation, memory headroom, request shape/concurrency, and performance evidence.
- Discrimination — critical: rejects at least one plausible alternative or keeps the case explicitly unresolved.
- Bounded containment — critical: selects admission, request, batching/queue, or capacity actions that match the observed boundary and remain reversible.
- Closure — critical: changed-load replay succeeds on allocation, declared headroom, latency SLO, and minimum throughput.
- Transfer — critical: changed request/concurrency evidence produces a fresh diagnosis rather than a copied label.
Any missing critical dimension is insufficient even when the narrative sounds confident.
منابع و تازگی
مطالعهٔ موارد (case studies)
تصاویر درس
فایلهای آزمایشگاه
Use the eight synthetic cases to implement an evidence-bounded evaluate(case) function. Do not infer OOM from utilization alone. Your output should distinguish allocation state, memory headroom, dominant boundary, containment, closure, performance, and next action.
A strong solution keeps ambiguous OOM cases unresolved, recognizes the high-utilization negative control, and changes its diagnosis when sequence length rises while concurrency falls. No external GPU or network access is required.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)