امنیت، هویت، استقرار و تابآوری · فصل ۶ — Chaos، Feature Flags، Rollout و ADR · 104
Chaos/Failure Testing
میتواند سرویس را اجرا کند اما lifecycle، health، rollout، observability و recovery را بهصورت سیستماتیک مدیریت نمیکند. موضوع جاری: «Chaos/Failure Testing». میتواند برای «Chaos/Failure Testing» run/release model و signals/recovery checks لازم را برای یک سرویس محدود طراحی کند.
خلاصهٔ درس
میتواند سرویس را اجرا کند اما lifecycle، health، rollout، observability و recovery را بهصورت سیستماتیک مدیریت نمیکند. موضوع جاری: «Chaos/Failure Testing».
میتواند برای «Chaos/Failure Testing» run/release model و signals/recovery checks لازم را برای یک سرویس محدود طراحی کند.
خروجی این درس
میتواند برای «Chaos/Failure Testing» run/release model و signals/recovery checks لازم را برای یک سرویس محدود طراحی کند.
پیشنیازها
1. مسئله و خروجی قابل اثبات
شکستن عمدی یک سیستم، بهتنهایی «آزمایش تابآوری» نیست. آزمایش قابل دفاع از یک فرضیهٔ ابطالپذیر دربارهٔ Steady State شروع میشود، دامنه و Blast Radius را محدود میکند، یک fault مشخص را روی target مشخص اعمال میکند، Guardrail و Stop Condition دارد و در پایان با شواهد بازیابی تصمیم میگیرد که ادعا پشتیبانی شده، رد شده یا هنوز باز است. خروجی این درس Controlled Failure Experiment Record v1 است.
سناریو کاملاً محلی و مصنوعی است. هیچ production system، ترافیک واقعی کاربر، credential واقعی یا external target در Lab وجود ندارد.
2. مرز درس و پیشنیاز
پیشنیاز سخت این درس OPS-008 است. اینجا outcome مربوط به Incident Response/Postmortem یا rollout/canary را جذب نمیکنیم. هدف فقط طراحی و تفسیر یک failure experiment محدود است. یک آزمایش موفق، اثبات «تابآوری کلی سیستم» نیست؛ فقط دربارهٔ همان hypothesis، همان scope و همان مشاهدهها شواهد میدهد.
3. مدل ذهنی: از baseline تا claim
زنجیرهٔ صحیح چنین است:
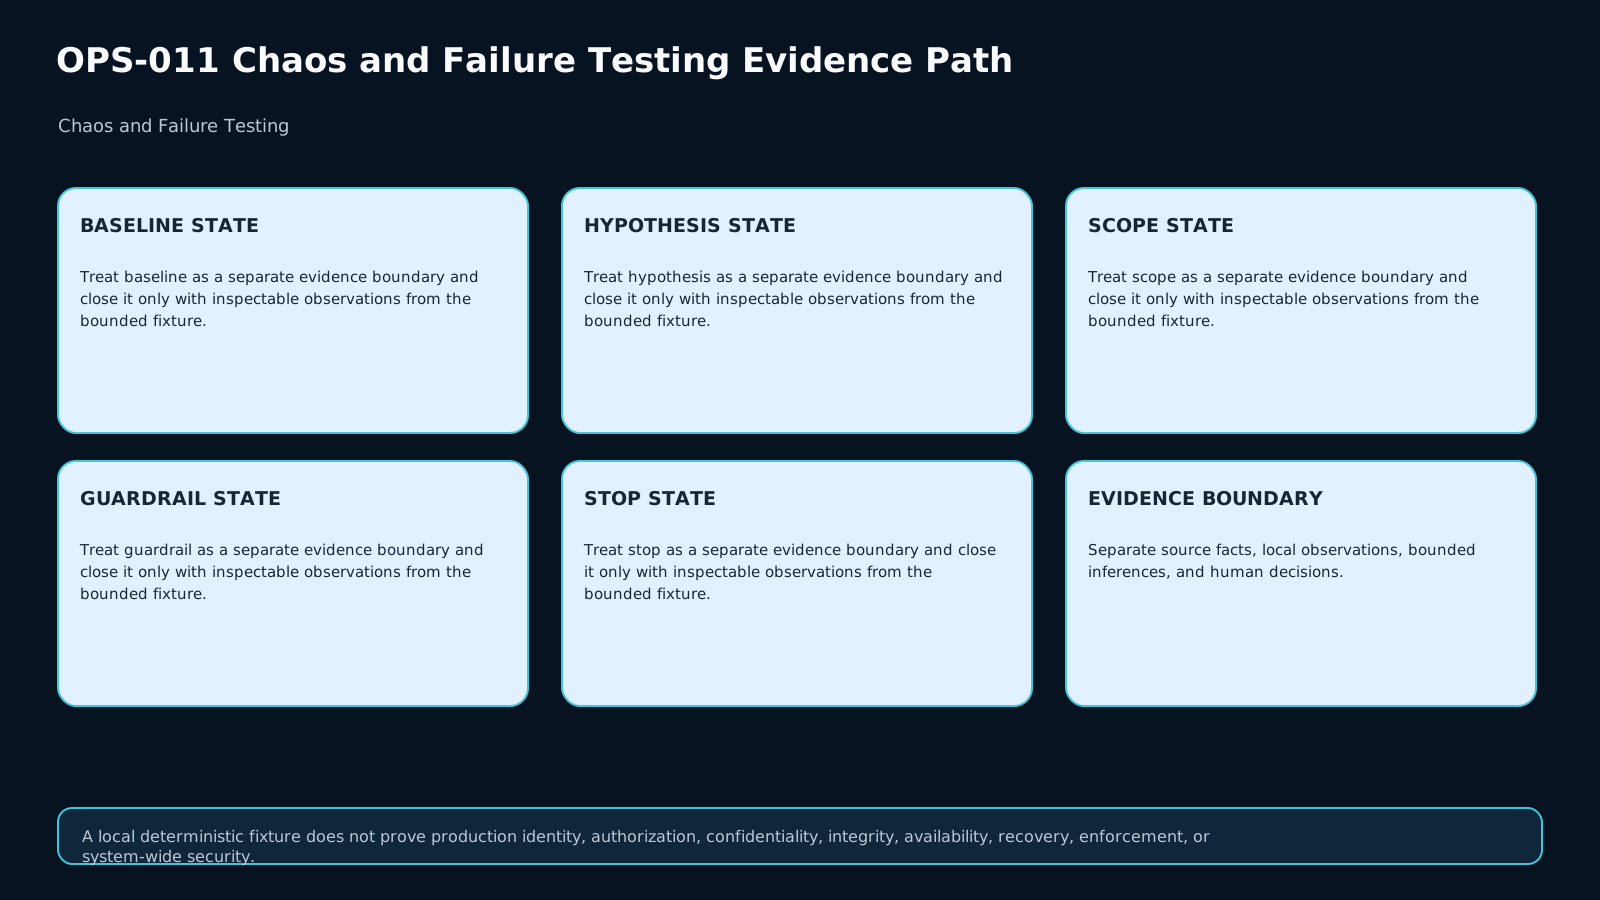
Steady-state baseline → falsifiable hypothesis → bounded target/fault → guardrail monitoring → continue/stop → rollback/recovery check → supported/refuted/open claim → next experiment
هر پیکان یک مرز شواهد است. اگر baseline نداریم، hypothesis قابل آزمون نیست. اگر target مبهم است، blast radius قابل دفاع نیست. اگر recovery فقط با «process is alive» سنجیده شود، وضعیت سرویس هنوز اثبات نشده است.
4. Steady State و فرضیهٔ ابطالپذیر
Steady State توصیف «رفتار قابل قبول قبل از fault» است، نه یک احساس کلی دربارهٔ سالمبودن سیستم. در fixture این درس میتواند ترکیبی از success rate، latency و queue depth باشد. فرضیه باید شکلی داشته باشد که بتوان آن را رد کرد؛ مثلاً: «اگر dependency delay برای 20 ثانیه افزایش یابد، success rate بالای 98% میماند و queue depth از 40 عبور نمیکند.»
فرضیهای مثل «سیستم مقاوم است» قابل اندازهگیری و ابطال نیست و قبل از اجرا باید بازنویسی شود.
5. Scope، Target و Blast Radius
Scope پاسخ میدهد کدام محیط و کدام service graph درون آزمایش است. Target دقیقاً مشخص میکند fault روی چه جزء مصنوعی اعمال میشود. Blast Radius بیشترین دامنهٔ اثر مجاز است. در این درس blast radius همیشه به fixture محلی محدود است.
AWS Well-Architected روی scope روشن، rollback و stop conditions تأکید میکند. این درس از همان اصل استفاده میکند اما thresholdهای واقعی سازمانی اختراع نمیکند؛ همهٔ thresholdها مخصوص fixture هستند.
6. Action، Target و Stop Condition را یکی نکن
در AWS FIS، Actions، Targets و Stop Conditions اجزای جداگانهٔ experiment template هستند. این تفکیک برای مدل ذهنی مهم است: fault action چیزی است که تغییر میدهیم؛ target جایی است که تغییر روی آن اعمال میشود؛ stop condition مرزی است که میگوید ادامهدادن قابل قبول نیست.
در Lab هیچ AWS resource واقعی وجود ندارد؛ فقط همین تفکیک مفهومی روی دادهٔ مصنوعی تمرین میشود.
7. Guardrail و Stop Branch
Guardrail سیگنالی است که باید هنگام آزمایش تحت نظر بماند. Stop Condition threshold یا وضعیت از پیش اعلامشدهای است که با عبور از آن آزمایش باید متوقف شود. تصمیم stop نباید بعد از مشاهدهٔ نتیجه و برای «زیباتر کردن» نتیجه ساخته شود.
اگر guardrail عبور کند، ادامهدادن آزمایش فقط برای جمعکردن دادهٔ بیشتر یک خطای روششناختی است. رکورد باید دلیل abort و وضعیت rollback/recovery را ثبت کند.
8. Observability و Recovery Evidence
بازیابی با بازگشت به Steady State اثبات میشود، نه صرفاً با بالا بودن process. اگر process دوباره running باشد ولی latency هنوز خارج از محدوده یا queue depth رو به رشد باشد، recovery UNPROVEN است.
اگر یکی از signalهای لازم اصلاً مشاهده نشود، نتیجه باید OPEN/INCONCLUSIVE بماند. نبود داده را نمیتوان با حدس یا summary سبز جایگزین کرد.
9. مثال هدایتشده
Baseline: success=99.6%، p95 latency=85ms، queue=12. Hypothesis میگوید با dependency delay محدود، success بالای 98% و queue زیر 40 باقی میماند. Fault فقط dependency-B را هدف میگیرد. Guardrail روی success و queue تنظیم شده است.
اگر در اجرا success=99.0% و queue=31 بماند و پس از حذف fault هر سه signal به baseline window برگردند، hypothesis فقط در همین scope SUPPORTED_BOUNDED است. جملهٔ «سیستم resilient است» فراتر از شواهد است.
10. Failure Probe: عبور از Stop Threshold
در یک fixture دیگر، dependency delay باعث queue=57 میشود در حالی که stop threshold=45 است. تصمیم صحیح STOP_REQUIRED است. اگر fault حذف شود اما queue فقط تا 49 پایین بیاید، recovery هنوز اثبات نشده است.
این probe یک shortcut رایج را رد میکند: «اگر process crash نکرد، آزمایش را ادامه بده.» معیار، guardrail و Steady State است؛ نه صرفاً process liveness.
11. Control Condition، Repeatability و Unknowns
یک control condition کمک میکند تغییر observed را به fault نسبت دهیم. Snapshot قبل از اجرا، fault duration، target selector و signal window باید ثبت شوند تا آزمایش قابل تکرار باشد. بااینحال repeatability به معنی حذف همهٔ unknownها نیست.
Unknownها را صریح نگه دارید: interactionهای production، traffic واقعی، dependencyهای خارج از fixture و observability ناقص خارج از ادعای این آزمایش هستند.
12. Controlled Failure Experiment Record v1
هر row حداقل این فیلدها را دارد: Hypothesis، Steady-State Signal، Fault، Target، Blast Radius، Guardrail، Stop Condition، Observation، Recovery Evidence، Supported/Refuted/Open و Next Experiment.
سه نوع داده را جدا کنید: Direct Evidence، Inference/Decision و Unknown. اگر یک decision به policy سازمانی نیاز دارد که در fixture وجود ندارد، آن را OPEN نگه دارید.
13. تمرین انتقال
service graph دوم topology متفاوتی دارد: fault location، steady-state signal و threshold فرق میکنند. hypothesis قبلی را کپی نکنید. از observationهای graph جدید شروع کنید و رکورد را از نو بسازید. انتقال زمانی پذیرفته است که نتیجه مستقل از اعداد و شناسههای مثال اول باشد.
14. ارزیابی و معیار قبولی
باید بتوانید: نقش steady state، hypothesis، blast radius و stop condition را تفکیک کنید؛ قبل از fault رکورد را بسازید؛ recovery جعلی بر اساس process liveness را رد کنید؛ از guardrail بین continue/stop/rollback/defer تصمیم بگیرید؛ و برای graph دوم experiment جدید طراحی کنید.
سه خطای مسدودکننده: ادعای عملیاتی بدون شواهد، happy-path-only evidence و نبود transfer مستقل.
15. منابع، تازگی و محدودیت ادعا
این درس بر راهنمای رسمی AWS Well-Architected، AWS Prescriptive Guidance و AWS FIS تکیه دارد. در بازبینی 19 سپتامبر 2026، AWS همچنان controlled experiments، hypothesis/stop conditions، start-small و scope-of-impact را توصیه میکند؛ AWS FIS نیز Actions، Targets و Stop Conditions را جدا مدل میکند و stop condition را با CloudWatch alarm تعریف میکند.
Controlled Failure Experiment Record v1 یک artifact آموزشی MAKNOW است و سند الزامی AWS نیست. بازبینی منابع تا 17 اکتبر 2026 مقرر شده است. هیچ نتیجهای از fixture محلی به production survivability تعمیم داده نمیشود.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
OPS-011-S1 retrieval
Define steady state, hypothesis, blast radius, and stop condition, and distinguish their roles.
OPS-011-S2 application
Construct Controlled Failure Experiment Record v1 before running the synthetic fault.
OPS-011-S3 diagnosis
Explain why process liveness alone is insufficient recovery evidence.
OPS-011-S4 decision
From guardrail observations, choose continue, stop, rollback/verify, or defer.
OPS-011-S5 transfer
Design a new bounded experiment for the changed service graph without copying the first hypothesis or threshold.
ملاکهای ارزیابی (rubric)
- Experiment design integrity — critical: hypothesis, fault, target, blast radius, guardrail, and stop condition are distinct and traceable.
- Safety boundary — critical: synthetic scope never expands beyond the declared local fixture.
- Recovery evidence — critical: recovery is supported by steady-state signals, not process survival alone.
- Learning transfer — critical: changed-context experiment uses a new hypothesis and preserves bounded claims.
Blocking failure: unsupported operational conclusion, happy-path-only evidence, collapsed scope/stop boundary, or copied transfer conclusion.
منابع و تازگی
مطالعهٔ موارد (case studies)
فایلهای آزمایشگاه
This exercise uses synthetic local evidence only. No production system, credential, customer data, live endpoint, cloud resource, or external target is required.
- Run
python run_checks.pyto verify fixture structure. - Implement
analyze_experiment(case)instarter.py. - Return these eight keys:
baseline_state,hypothesis_state,scope_state,guardrail_state,stop_state,observability_state,recovery_state,experiment_decision. - Keep baseline, hypothesis, target/scope, guardrail, stop branch, observability, and recovery evidence separate.
- Crossing a stop threshold requires a stop decision even if the synthetic process remains alive.
- Missing required signals keeps the resilience claim open.
- Recovery requires steady-state evidence; liveness alone is insufficient.
- Rebuild the transfer case from graph-B evidence; do not copy graph-A thresholds or hypothesis.
The structural checker never reveals expected classifications.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)