امنیت، هویت، استقرار و تابآوری · فصل ۵ — Telemetry، SLO و Incident Response · 103
Incident Response و Postmortem
میتواند سرویس را اجرا کند اما lifecycle، health، rollout، observability و recovery را بهصورت سیستماتیک مدیریت نمیکند. موضوع جاری: «Incident Response و Postmortem». میتواند برای «Incident Response و Postmortem» run/release model و signals/recovery checks لازم را برای یک سرویس محدود طراحی کند.
خلاصهٔ درس
میتواند سرویس را اجرا کند اما lifecycle، health، rollout، observability و recovery را بهصورت سیستماتیک مدیریت نمیکند. موضوع جاری: «Incident Response و Postmortem».
میتواند برای «Incident Response و Postmortem» run/release model و signals/recovery checks لازم را برای یک سرویس محدود طراحی کند.
خروجی این درس
میتواند برای «Incident Response و Postmortem» run/release model و signals/recovery checks لازم را برای یک سرویس محدود طراحی کند.
1. مسئله و خروجی قابل اثبات
در یک رخداد عملیاتی، سریعترین روایت لزوماً درستترین روایت نیست. هشدار، تغییر اخیر، نمودارهای قرمز و فشار برای بازگردانی سرویس میتوانند تیم را به این خطا بیندازند که «همبستگی زمانی» را با «علت» یکی بگیرد. خروجی این درس یک Incident Response and Learning Record v1 است: رکوردی که impact، شواهد مستقیم، فرضیهها، اقدامات، وضعیت فعلی سرویس، عدمقطعیت علّی و پیگیریهای پس از رخداد را از هم جدا نگه میدارد.
هدف محدود است: بتوانی یک رخداد کاملاً مصنوعی و محلی را از detection تا stabilization و learning پیش ببری، بدون اینکه بازیابی سرویس را معادل اثبات علت بدانی یا یک روایت پسینی را جایگزین evidence کنی.
2. مرز درس و پیشنیاز
این درس مالک incident response و postmortem است. SLO/Error Budget/RPO/RTO متعلق به OPS-009 است و Chaos/Failure Testing متعلق به OPS-011. اینجا از آنها فقط به اندازهای استفاده میکنیم که impact و recovery را بفهمیم؛ outcome آن درسها را جذب نمیکنیم.
هیچ production system، endpoint زنده، credential واقعی، داده مشتری یا اقدام خارجی در Lab وجود ندارد. تمام ورودیها fixture محلی و ساختگیاند.
3. مدل ذهنی: Response با Learning یکی نیست
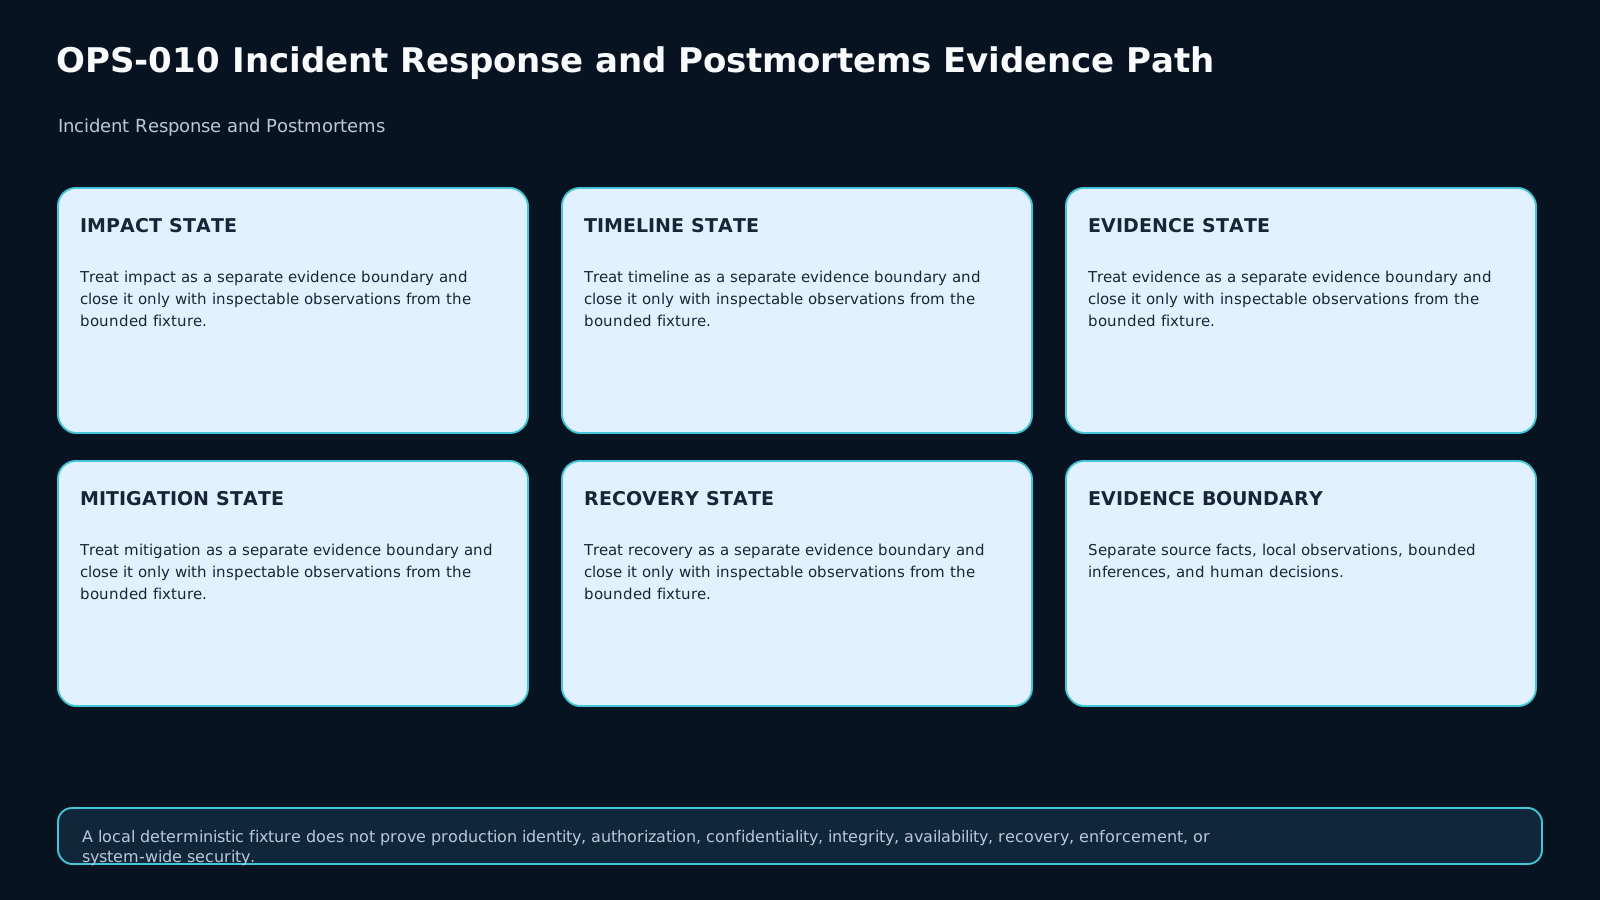
سه خروجی را جدا کن: کاهش impact، تأیید recovery و یادگیری علّی. ممکن است mitigation درست باشد حتی وقتی علت هنوز باز است. ممکن است سرویس process-level زنده باشد ولی recovery کاربر اثبات نشده باشد. و ممکن است postmortem خوب چند contributing factor داشته باشد نه یک «root cause» ساده.
رکورد خوب باید بتواند پاسخ دهد: چه چیزی مشاهده شد؟ چه چیزی استنباط شد؟ چه اقدامی با چه ریسکی انجام شد؟ چه چیزی واقعاً recovery را ثابت کرد؟ کدام ادعا هنوز open است؟
4. Impact را قبل از علت تثبیت کن
Impact یک ادعای عملیاتی است: چه کاربری، چه قابلیت، چه بازه زمانی و چه شدت اختلالی متاثر شده است. در دقیقههای اول، «علت» ممکن است نامعلوم باشد اما impact باید با شواهدی مثل error-rate، failed checkout count یا latency window محدود شود.
عبارت «سایت خراب است» evidence کافی نیست. رکورد باید مشخص کند کدام signal و کدام بازه، impact را پشتیبانی میکند و چه چیزهایی هنوز ناشناختهاند.
5. Timeline: مشاهده، inference و ordering uncertainty
Timeline فقط لیست timestamp نیست. هر ردیف باید نوع evidence داشته باشد: alert، log، trace، change event، operator action یا stakeholder update. اگر دو سیستم clock دقیق مشترک ندارند، ordering را با قطعیت جعلی ننویس.
مثلاً «config change در 10:02» و «error spike در حدود 10:02–10:03» ممکن است همبسته باشند، اما تا وقتی trace یا آزمایش محدود پشتیبان نداریم، جمله «config change علت بود» inference است.
6. Triage Hypothesis را ابطالپذیر نگه دار
فرضیه triage برای هدایت probe است، نه برای قفلکردن داستان. بنویس چه مشاهدهای آن را تقویت میکند و چه مشاهدهای آن را رد میکند. اگر شواهد مخالف ظاهر شد، hypothesis باید عوض شود؛ timeline نباید برای حفظ داستان قبلی بازنویسی شود.
یک hypothesis خوب مانند این است: «اگر تغییر routing عامل اصلی باشد، rollback محدود باید error-rate مسیر A را در پنجره بعدی کاهش دهد، بدون تغییر در مسیر B.»
7. Mitigation با Root-Cause Closure فرق دارد
در incident response اولویت میتواند کاهش impact باشد. rollback محدود، traffic shift یا disable کردن یک مسیر مصنوعی ممکن است تصمیم درست باشد حتی وقتی causal analysis ناقص است. اما mitigation باید bounded باشد: scope، ریسک، rollback path و expected evidence مشخص باشد.
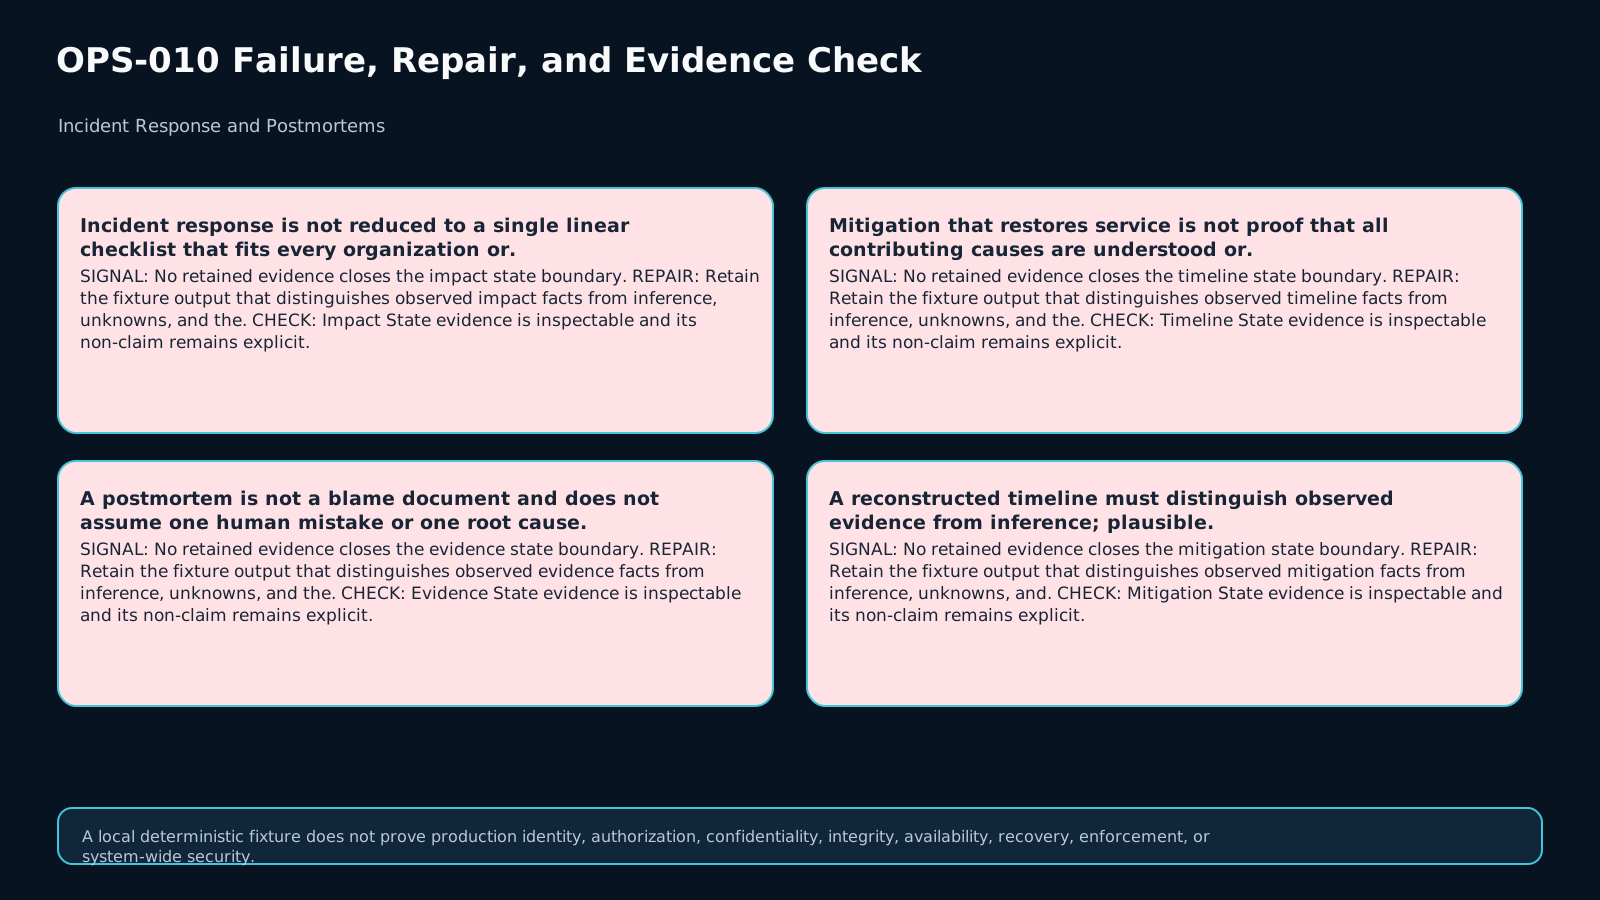
وقتی mitigation موفق شد فقط بنویس «impact کاهش یافت». از عبارت «علت برطرف شد» استفاده نکن مگر evidence علّی کافی وجود داشته باشد.
8. Recovery را مستقل تأیید کن
Recovery باید با signal مرتبط با تجربه سرویس تأیید شود، نه فقط process liveness. برای fixture این درس، recovery میتواند ترکیبی از error-rate بازگشته به baseline، موفقیت transaction مصنوعی و پایدارماندن در یک observation window باشد.
اگر telemetry ناقص است، state درست RECOVERY_UNPROVEN است. نبود evidence مجوز confidence ساختگی نیست.
9. ارتباطات: Known / Suspected / Next Update
Stakeholder update باید سه سطح را از هم جدا کند: Known، Suspected و Next action / next update. این قالب از انتشار causal claim زودرس جلوگیری میکند. همچنین impact و current service state باید واضحتر از جزئیات فنی حدسی باشند.
نمونه: «Known: checkout failure rate elevated. Suspected: recent routing config correlated but unproven. Action: bounded rollback on route A. Next update after recovery verification window.»
10. Postmortem بدون سرزنش
Blameless به معنی حذف accountability نیست. معنی آن این است که تحلیل روی شرایط سیستم، اطلاعات در دسترس، guardrailها، interfaceها، runbookها و تصمیمهای قابل بازبینی متمرکز شود، نه برچسبزدن به فرد.
جمله «مهندس X config اشتباه زد» را به پرسش سیستمی تبدیل کن: «چه شرایطی اجازه داد تغییر با validation ناکافی به این مسیر برسد، و چه signal یا review میتوانست آن را زودتر آشکار کند؟»
11. Contributing Causes و Causal Uncertainty
رخدادها میتوانند چند contributing condition داشته باشند: change risk، observability gap، timeout interaction یا runbook ambiguity. forcing یک علت واحد معمولاً information loss ایجاد میکند.
در رکورد، هر contributing factor را با evidence و confidence محدود بنویس. چیزی که فقط plausible است باید OPEN بماند. Service restoration یک «مشاهده» است؛ causal closure یک «ادعای تحلیلی» جداگانه است.
12. Incident Response and Learning Record v1
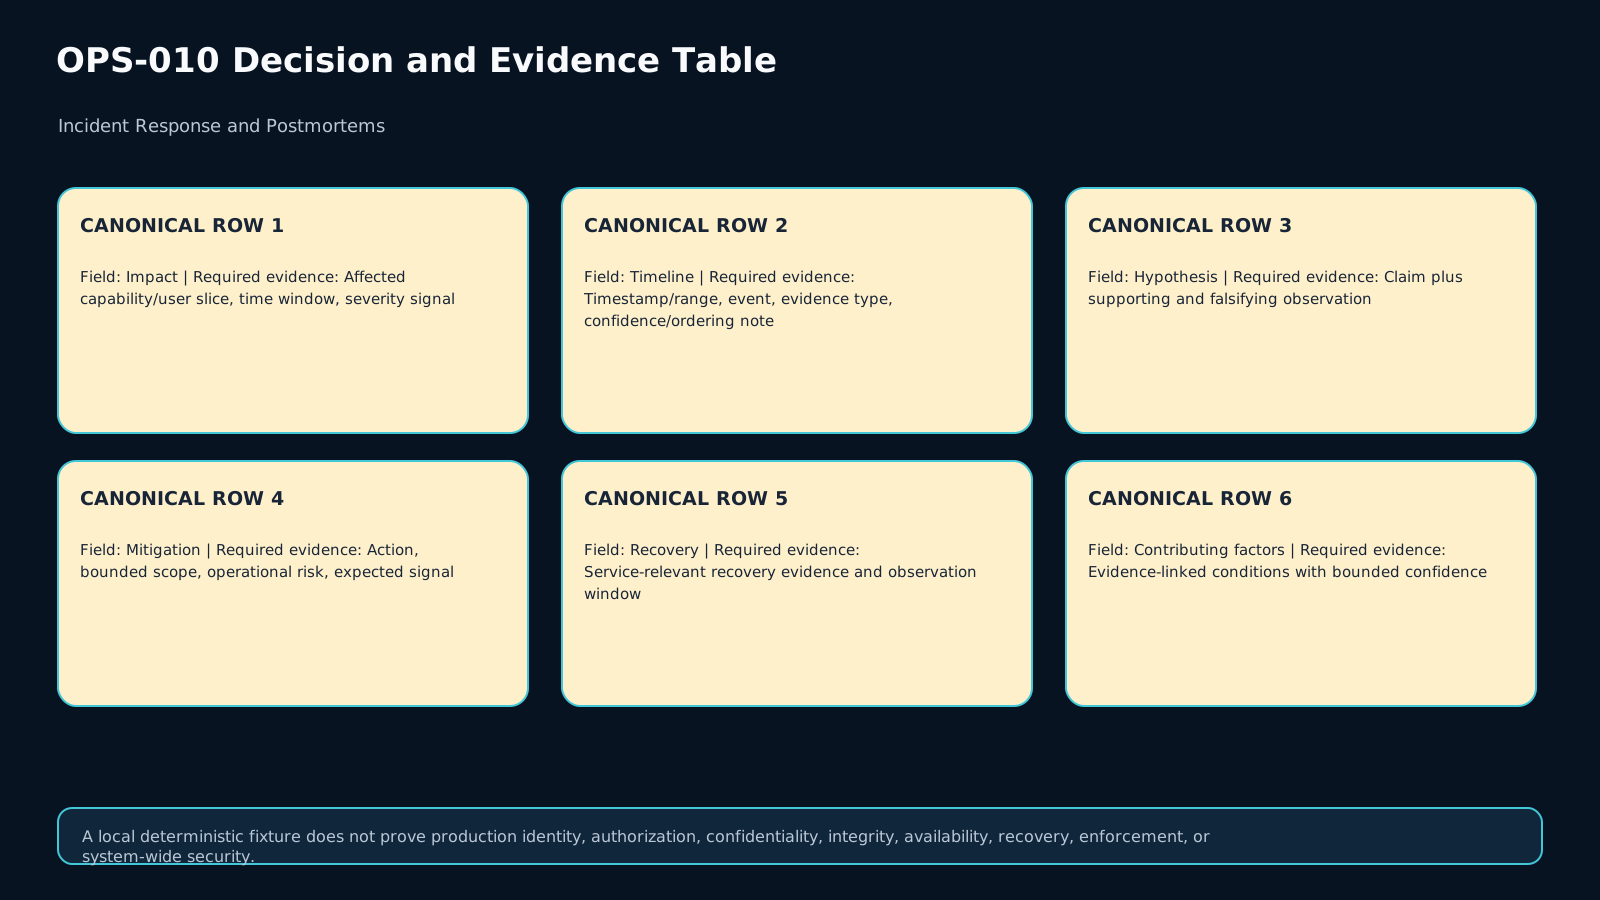
Artifact شامل این بخشهاست: incident_id، impact، detection signal، timeline rows، hypotheses، mitigation decision و risk، stakeholder updates، recovery evidence، contributing factors، causal unknowns، postmortem trigger، follow-up actions، owner، evidence-of-done و recurrence sensor.
این artifact یک synthesis آموزشی MAKNOW است؛ NIST یا Google چنین فرم اجباری مشخصی تحمیل نمیکنند. ارزش آن در traceability است: هر تصمیم باید بتواند به evidence برگردد.
13. Failure Probe و تمرین انتقال
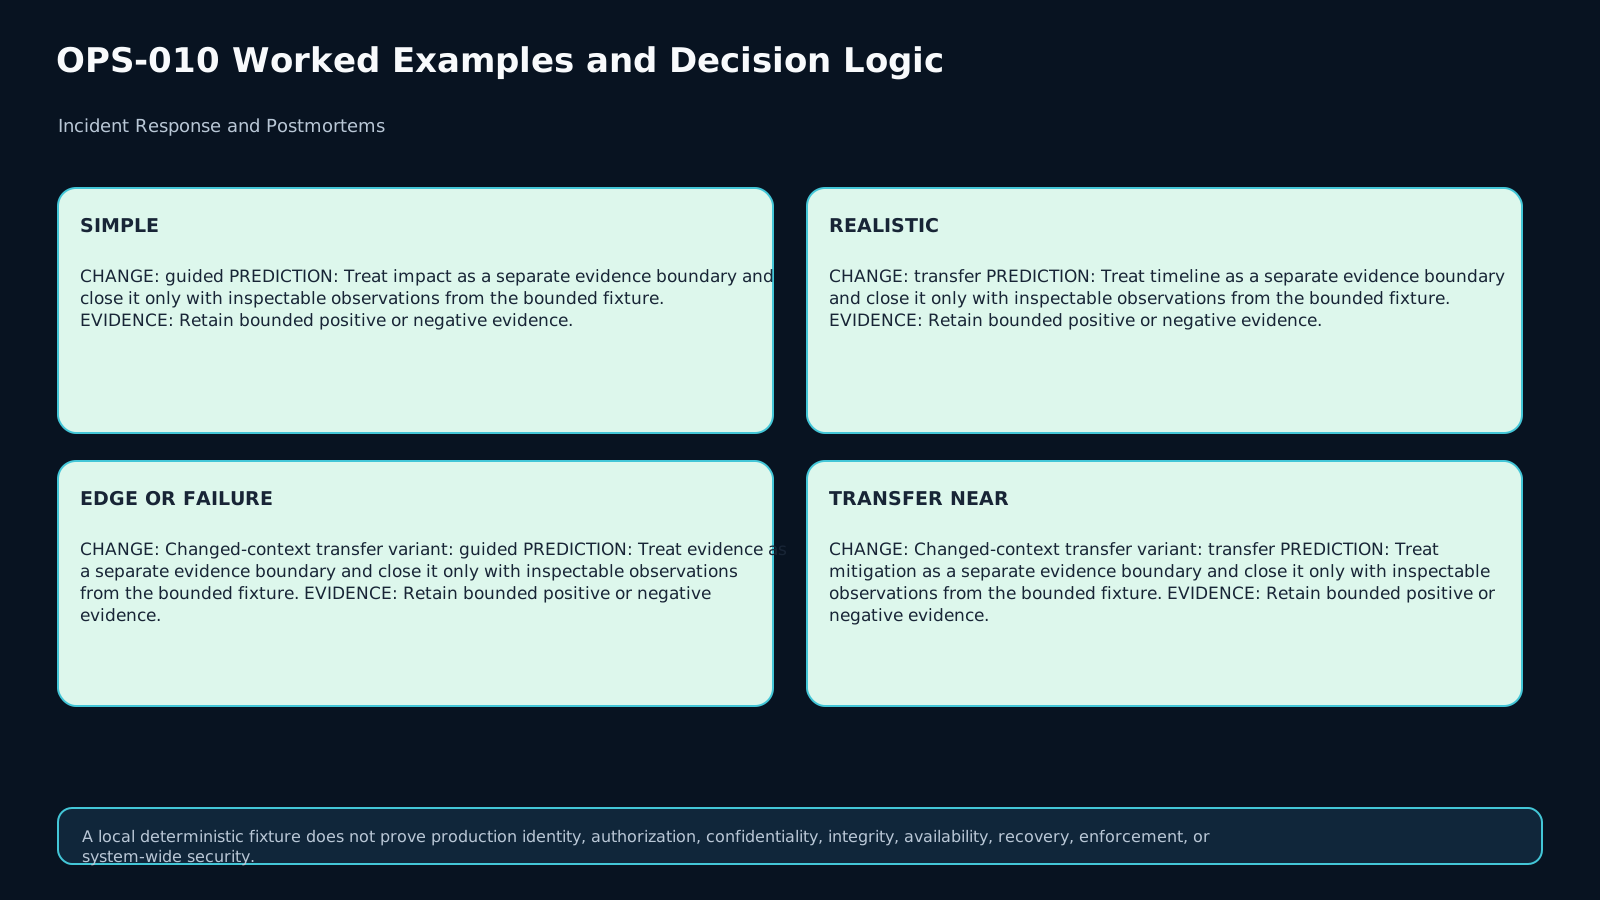
در case اول، یک change event عمداً نزدیک error spike قرار گرفته تا shortcut «latest change = cause» را تحریک کند. باید با evidence مخالف آن shortcut را رد یا محدود کنی. سپس case انتقالی change متفاوت، telemetry ناقص و محدودیت ارتباطی دارد؛ causal story قبلی قابل کپی نیست.
قبولی transfer یعنی رکورد جدید از raw fixture بازسازی شود و unknowns جدید صریح بمانند.
14. ارزیابی و معیار قبولی
چهار بعد critical هستند: timeline evidence، تمایز mitigation/recovery/cause، blameless causal learning و follow-up closure. پاسخ blocking باید نشان دهد mitigation bounded است، recovery مستقل verify شده یا صریحاً unproven مانده، و action item دارای owner، evidence-of-done و recurrence sensor است.
اگر نتیجه فقط «مشکل حل شد» باشد، assessment رد است؛ چون نه current state را ثابت میکند، نه علت را، نه کاهش recurrence risk را.
15. منابع، تازگی و محدودیت ادعا
NIST SP 800-61 Rev.3 در آوریل 2025 نهایی شد و incident response را در چارچوب گستردهتر cybersecurity risk management و CSF 2.0 قرار میدهد. Google SRE postmortem را learning artifact میداند و بر blamelessness، contributing causes، impact، mitigation/response و action items تأکید میکند.
این درس از این منابع برای boundary و principles استفاده میکند، نه برای ادعای یک runbook جهانی. منبعها در 2026-09-19 بازبینی شدهاند و تغییر material در authority یا fixture نیازمند requalification نسخه جدید است.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
OPS-010-S1 retrieval
Reconstruct the incident timeline and mark at least one uncertain ordering explicitly.
OPS-010-S2 application
Choose and defend a bounded mitigation from current evidence without claiming root-cause closure.
OPS-010-S3 diagnosis
Separate recovery verification from contributing-cause analysis and preserve causal unknowns.
OPS-010-S4 decision
Rewrite a blameful postmortem statement into a system/evidence statement.
OPS-010-S5 transfer
Create two follow-up actions with owner, evidence-of-done, and recurrence sensor for the changed incident.
ملاکهای ارزیابی (rubric)
| Dimension | Critical | Sufficient evidence |
|---|---|---|
| Incident evidence timeline | Yes | Impact, direct observations, hypotheses and actions are separated; uncertain ordering is visible. |
| Mitigation/recovery distinction | Yes | Mitigation risk is bounded and recovery is independently verified or explicitly unproven. |
| Blameless causal learning | Yes | Contributing conditions are evidence-linked without forced single-cause or person-blame claims. |
| Follow-up closure | Yes | Each accepted action has an owner, evidence-of-done, and recurrence sensor. |
Blocking failure: unsupported causal closure, happy-path-only recovery claim, missing changed-context independence, or invented organization policy.
منابع و تازگی
مطالعهٔ موارد (case studies)
تصاویر درس
فایلهای آزمایشگاه
This lab contains eight fully synthetic incident records. No network access, credential, production system, customer data, or external target is required.
Task: inspect each case and classify the incident record across impact, timeline, evidence/inference separation, mitigation, recovery, causal learning, follow-up closure, and final decision. Use starter.py for your own record logic and run_checks.py for learner-visible structural checks.
Do not treat a recent change as proven cause from timestamp proximity. A successful mitigation may reduce impact while the causal explanation remains open. Recovery requires service-relevant evidence. Follow-up work is only closed when ownership and verifiable completion/recurrence signals exist.
The transfer fixture changes the initiating condition and evidence gaps; rebuild the record rather than carrying a previous causal story.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)