امنیت، هویت، استقرار و تابآوری · فصل ۵ — Telemetry، SLO و Incident Response · 102
SLO، Error Budget، RPO و RTO
میتواند سرویس را اجرا کند اما lifecycle، health، rollout، observability و recovery را بهصورت سیستماتیک مدیریت نمیکند. موضوع جاری: «SLO, Error Budget, RPO و RTO». میتواند برای «SLO, Error Budget, RPO و RTO» run/release model و signals/recovery checks لازم را برای یک سرویس محدود طراحی کند.
خلاصهٔ درس
میتواند سرویس را اجرا کند اما lifecycle، health، rollout، observability و recovery را بهصورت سیستماتیک مدیریت نمیکند. موضوع جاری: «SLO, Error Budget, RPO و RTO».
میتواند برای «SLO, Error Budget, RPO و RTO» run/release model و signals/recovery checks لازم را برای یک سرویس محدود طراحی کند.
خروجی این درس
میتواند برای «SLO, Error Budget, RPO و RTO» run/release model و signals/recovery checks لازم را برای یک سرویس محدود طراحی کند.
پیشنیازها
1. مسئله: چهار واژه، چهار سؤال متفاوت
وقتی یک تیم میگوید «سرویس باید 99.9 درصد قابلاعتماد باشد» ممکن است چهار موضوع را در یک عدد مخلوط کرده باشد: چه تجربهای برای کاربر مهم است، هدف قابلیتاعتماد در چه بازهای سنجیده میشود، چه مقدار عدمقابلیتاعتماد قابلقبول است، و پس از یک اختلال بزرگ چه مدت قطعی یا چه مقدار از دسترفتن داده قابلتحمل است. این درس این چهار سؤال را از هم جدا میکند.
خروجی مالک درس Service Reliability Objective Record v1 است. این رکورد باید شواهد مشاهدهشده، محاسبات، تصمیم سیاستی و شکافهای اثبات را جدا نگه دارد. داشتن یک عدد زیبا بهتنهایی PASS نیست.
2. SLI از تجربه کاربر شروع میشود
SLI یک اندازهگیری کمی از سطح سرویس است. برای سرویس checkout، «نسبت درخواستهای موفقِ تکمیل خرید به کل تلاشهای معتبر خرید» میتواند به تجربه کاربر نزدیکتر از CPU utilization باشد. CPU ممکن است برای تشخیص مفید باشد، اما لزوماً outcome کاربر نیست.
قبل از هر target، سه چیز را بنویس: good event چیست، total event چیست، و population/window دقیقاً کدام است. تغییر denominator میتواند معنای همان درصد را عوض کند.
3. SLO یعنی target روی SLI، نه وضعیت فعلی
SLO مقدار یا دامنه هدف برای SLI در یک window مشخص است. اگر داده فعلی 99.93% است، این عدد خودبهخود target صحیح نیست. target باید با نیاز کاربر، ریسک، هزینه، معماری و ظرفیت تحویل سازگار باشد.
در این درس هیچ «عدد استاندارد جهانی» مثل 99.9% تحمیل نمیشود. target یک تصمیم قابلتوضیح است، نه حقیقت طبیعی سیستم.
4. Good/Total و window را صریح کن
برای SLIهای event-based، فرم ساده زیر مفید است:
SLI = good_events / total_events
فرض کنید در یک window بیستوهشتروزه 2,000,000 تلاش معتبر خرید وجود دارد و 1,997,600 مورد مطابق تعریف good بودهاند. observed SLI برابر 99.88% است. این مشاهده است؛ هنوز policy یا recovery objective نیست.
5. Error Budget از SLO مشتق میشود
اگر SLO برابر 99.90% باشد، سهم مجاز bad event برابر 1 - 0.999 = 0.001 است. برای 2,000,000 event، بودجه بدی برابر 2,000 event میشود. اگر 2,400 bad event مشاهده شده باشد، budget مصرفشده 120% است.
محاسبه بودجه و تصمیم «حالا چه کنیم؟» دو چیز جدا هستند. arithmetic از SLO و population میآید؛ action از error-budget policy مصوب میآید.
6. Error-budget policy را جعل نکن
Google SRE توضیح میدهد که error budget وقتی عملیاتی میشود که policy صریح تعیین کند با exhaustion چه واکنشی رخ دهد. در این درس اگر fixture policy ندهد، خروجی باید POLICY_OPEN بماند؛ نمیتوانیم خودمان release freeze یا threshold سازمانی اختراع کنیم.
این تفکیک مهم است: «بودجه تمام شده» یک نتیجه محاسباتی است؛ «release را متوقف کن» یک تصمیم governance است که باید authority داشته باشد.
7. RTO چیست؟
RTO حداکثر مدت قطعی قابلقبول برای یک اختلال بزرگ است؛ یعنی کسبوکار چه مدت میتواند بدون capability موردنظر بماند پیش از آنکه impact غیرقابلقبول شود. RTO از business-impact scenario و risk appetite میآید، نه از SLO درصدی.
اگر brief میگوید قطع checkout بیش از 60 دقیقه باعث از دسترفتن غیرقابلقبول سفارش و تعهد قراردادی میشود، میتوان RTO=60m را بهعنوان objective ثبت کرد. اما این هنوز ثابت نمیکند معماری واقعاً در 60 دقیقه recover میشود.
8. RPO چیست؟
RPO بیشترین بازه قابلقبول از دادهای است که ممکن است در recovery از دست برود یا به نقطه قدیمیتری بازگردانده شود. اگر business brief حداکثر 5 دقیقه از سفارشهای ثبتشده را قابلتحمل بداند، RPO=5m یک objective است.
RPO با backup interval، replication semantics، consistency و restore behavior ارتباط معماری دارد. ولی مقدار objective را صرفاً از تکنولوژی موجود استخراج نمیکنیم.
9. SLO/Error Budget با RTO/RPO یکی نیست
SLO میپرسد «در window عادی، تجربه کاربر با چه سطحی از reliability باید ارائه شود؟» Error budget میپرسد «طبق همان target چه مقدار bad event مجاز است؟» RTO میپرسد «در disaster چقدر زمان برای بازیابی داریم؟» RPO میپرسد «حداکثر چه مقدار عقبرفت داده قابلقبول است؟»
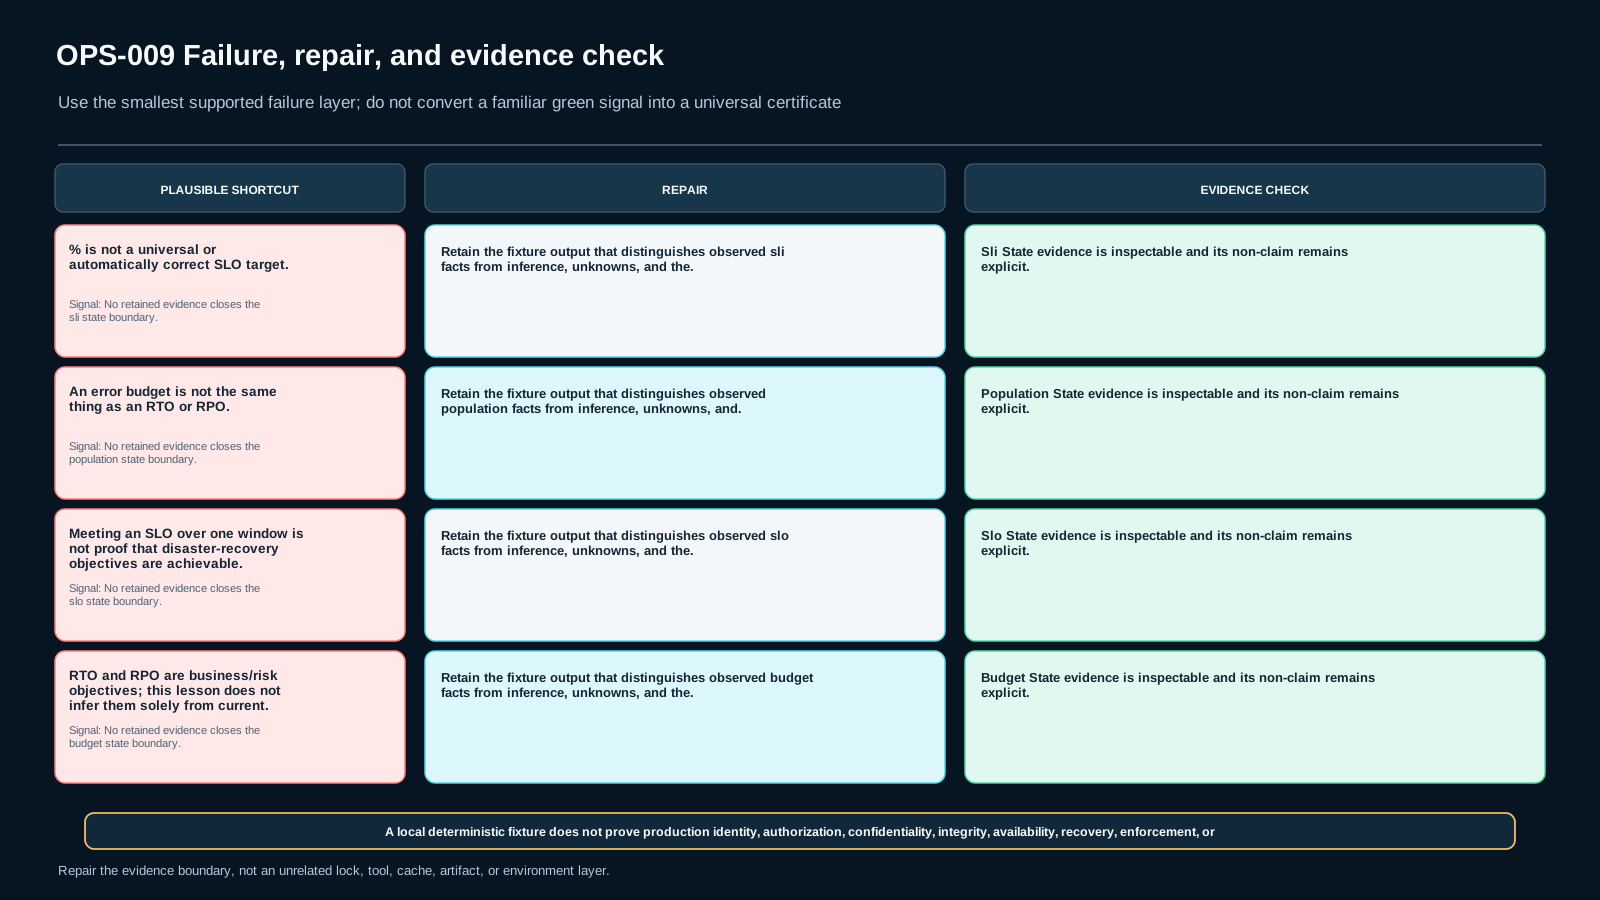
ممکن است سرویسی SLO ماهانه را پاس کند ولی هیچ تست DR معتبری برای RTO/RPO نداشته باشد. در آن حالت recovery capability باید UNVERIFIED بماند.
10. هدف بازیابی با capability اثباتشده فرق دارد
داشتن RTO=30m به معنی recovery in 30m نیست. برای اثبات capability به شواهدی مثل restore/failover exercise، timestamp شروع و پایان، validation رفتار کاربر، بررسی integrity داده و نتیجه تکرارپذیر نیاز است.
همین قاعده برای RPO برقرار است: وجود backup job سبز بهتنهایی ثابت نمیکند restore point قابلاستفاده و within-RPO است.
11. Tradeoff را ثبت کن
سختترکردن SLO، کوتاهترکردن RTO یا کوچکترکردن RPO معمولاً هزینه معماری، عملیات، ظرفیت، replication و testing را تغییر میدهد. بنابراین target بهتر، target «بزرگتر/کوچکتر» نیست؛ target بهتر آنی است که با impact و evidence توجیه شده باشد.
در artifact، assumption و cost implication را کنار target بنویس تا بعداً عدد به dogma تبدیل نشود.
12. Service Reliability Objective Record v1
رکورد شامل این ستونهاست: user journey، SLI definition، good/total population، window، SLO target، observed SLI، error-budget fraction، allowed bad events، observed bad events، budget consumed، policy state، business-impact statement، RTO، RPO، recovery evidence، assumptions، unknowns و decision state.
این قالب، synthesis آموزشی MAKNOW است؛ قالب اجباری Google نیست. ارزش آن در traceability و جلوگیری از collapse مفاهیم است.
13. Lab: کیس هدایتشده و negative probe
Lab هشت fixture محلی دارد. بعضی fixtureها SLI کاربرمحور و denominator کامل دارند؛ بعضی metric آسان ولی نامربوط، policy گمشده، RTO/RPO بدون business authority یا ادعای recovery بدون test evidence دارند.
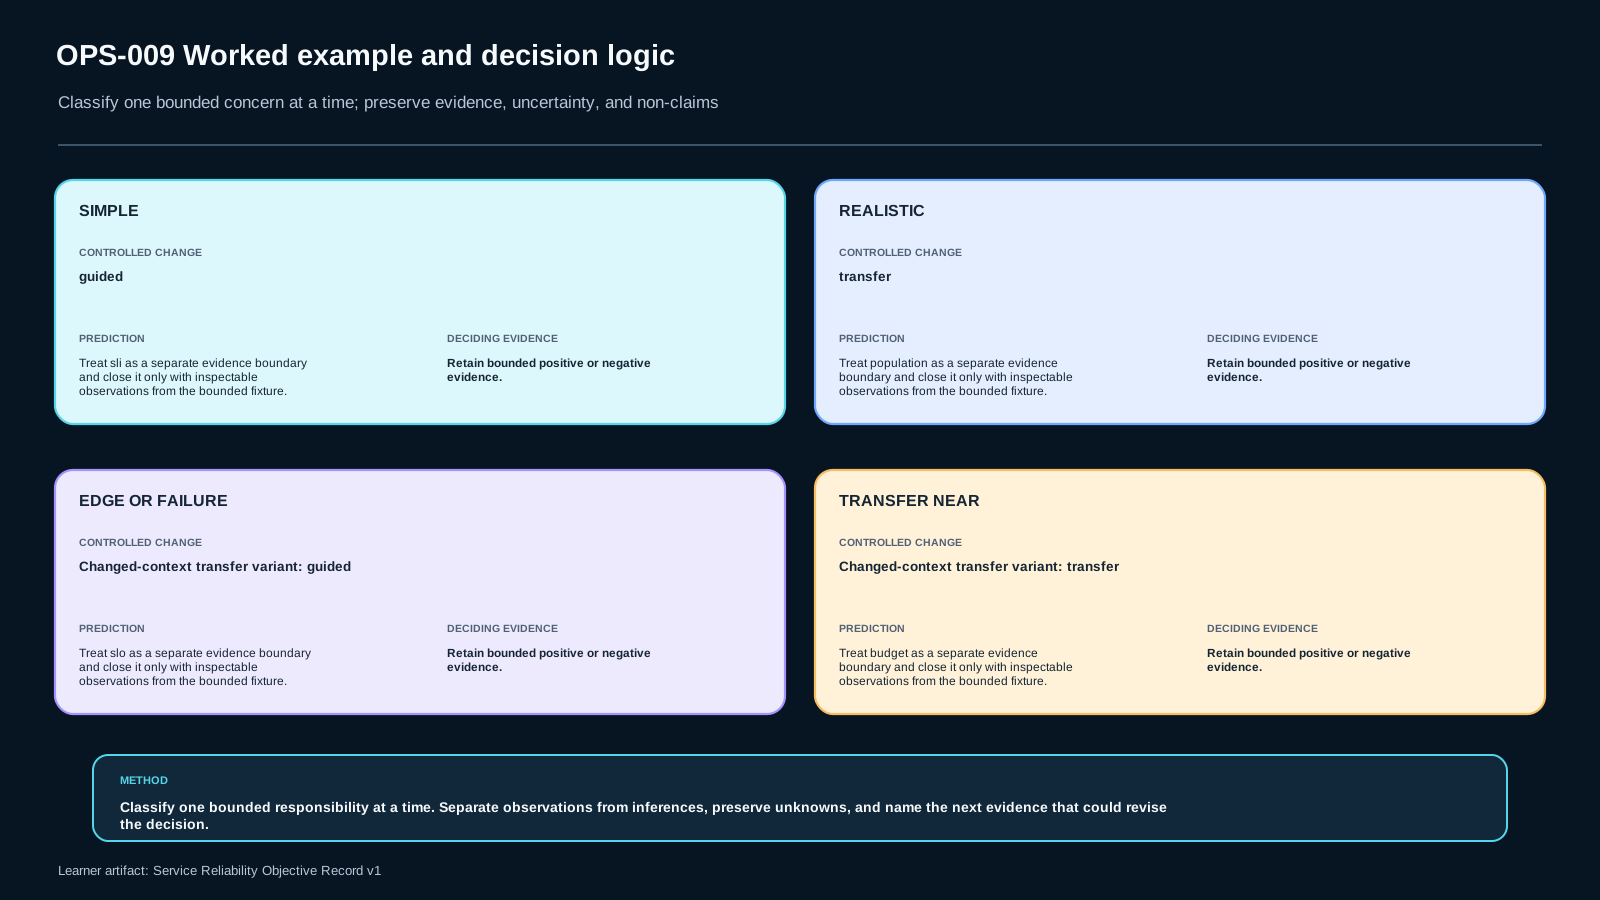
هدف hidden oracle این نیست که یک عدد خاص را حفظ کنید؛ هدف این است که در هر fixture هشت بُعد را مستقل طبقهبندی کنید و shortcutها را رد کنید.
14. Transfer و معیار پذیرش
در transfer، سرویس دوم user journey، traffic، criticality و recovery constraint متفاوت دارد. targetهای کیس اول قابلکپی نیستند. PASS زمانی است که SLI/window/target تازه توجیه شوند، budget arithmetic صحیح باشد، policy جعل نشود، و RTO/RPO از business impact با evidence gap روشن مشتق شوند.
چهار بُعد blocking عبارتاند از: تعریف SLI/SLO، محاسبه budget، جداسازی RTO/RPO، و transfer مبتنی بر tradeoff.
15. منابع، freshness و مرز ادعا
Google SRE، SLI را اندازهگیری کمی و SLO را target روی آن تعریف میکند و توصیه میکند از آنچه کاربر اهمیت میدهد شروع شود. Google SRE همچنین error budget را از SLO مشتق میکند و برای استفاده عملیاتی، policy صریح را لازم میداند. راهنمای Google Cloud، RTO را حداکثر downtime قابلقبول و RPO را بیشترین سن/بازه داده قابلقبول برای recovery توضیح میدهد.
این منابع در 2026-09-19 بازبینی شدند. هیچ target، policy یا recovery capability سازمانی از آنها اختراع نمیشود؛ هر مورد بدون authority یا test evidence باید OPEN بماند.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
OPS-009-S1 retrieval
Choose a user-centered SLI for the supplied service and reject one easy-to-measure but misleading metric.
OPS-009-S2 application
Calculate allowed bad events and budget consumption for the declared SLO, population, and window.
OPS-009-S3 diagnosis
Explain why error budget, RTO, and RPO answer different operational questions.
OPS-009-S4 decision
Derive RTO/RPO from a supplied business-impact tier and list the evidence needed to validate capability.
OPS-009-S5 transfer
Defend a new target set for a changed service without copying the first service targets.
ملاکهای ارزیابی (rubric)
| Dimension | Critical | Sufficient evidence |
|---|---|---|
| SLI/SLO definition | Yes | User need, good/total population, window and target are explicit and internally consistent. |
| Budget arithmetic | Yes | Allowed and consumed unreliability are calculated correctly and separated from policy. |
| RTO/RPO separation | Yes | Recovery time and data-loss objectives come from business impact, not from the SLO percentage. |
| Tradeoff transfer | Yes | Changed criticality/workload produces newly justified targets without copying the first case. |
Blocking failure: invented organization policy, unsupported universal target, treating SLO success as DR proof, or claiming RTO/RPO capability without recovery evidence.
منابع و تازگی
مطالعهٔ موارد (case studies)
تصاویر درس
فایلهای آزمایشگاه
Everything is local and synthetic. No account, network target, credential, or production service is used.
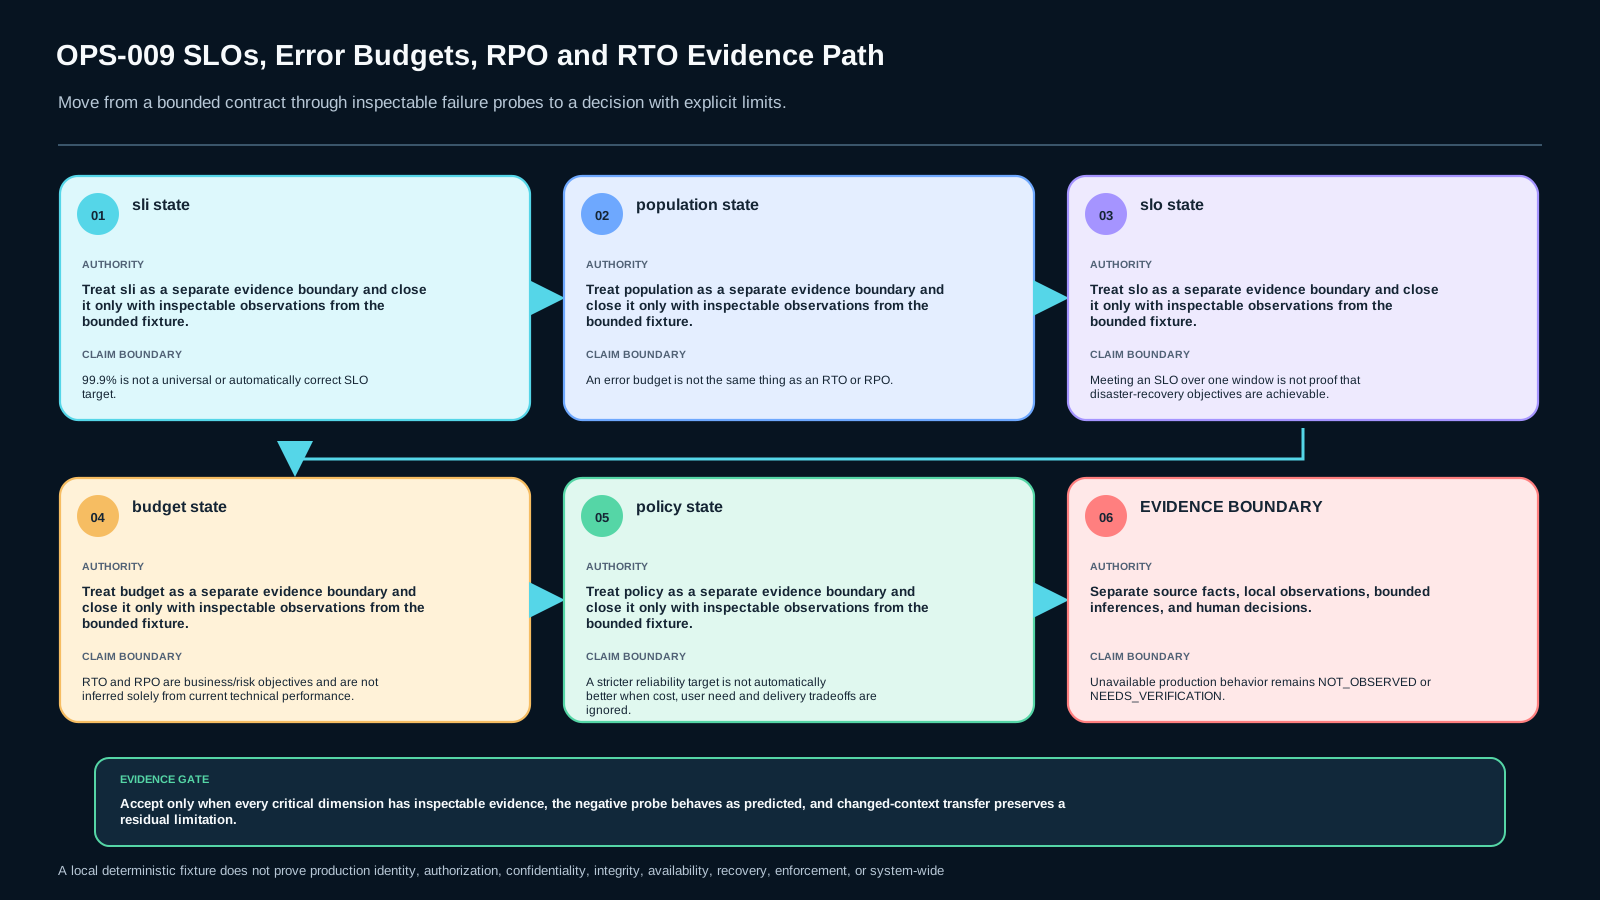
For each case, produce eight states: sli_state, population_state, slo_state, budget_state, policy_state, rto_state, rpo_state, and objective_decision.
Rules:
- Reject an easy metric that does not represent the supplied user journey.
- Do not calculate a ratio budget without a valid total-event denominator.
- Do not promote current performance or an unauthorised number to an SLO.
- Keep error-budget arithmetic separate from policy.
- Keep RTO/RPO separate from SLO/error budget.
- An objective is not proof of recovery capability; use exercise evidence.
- Rebuild targets for the changed transfer service.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)