امنیت، هویت، استقرار و تابآوری · فصل ۹ — Resource، Provider، Cost و Organizational Failure · 128
Cost Runaway
failure را بعد از وقوع و بهصورت موردی تحلیل میکند و هنوز detection، containment و repair path از قبل طراحی نشده است. موضوع جاری: «Cost Runaway». میتواند failure family «Cost Runaway» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
خلاصهٔ درس
failure را بعد از وقوع و بهصورت موردی تحلیل میکند و هنوز detection، containment و repair path از قبل طراحی نشده است. موضوع جاری: «Cost Runaway».
میتواند failure family «Cost Runaway» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
خروجی این درس
میتواند failure family «Cost Runaway» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
1. افزایش هزینه را با runaway یکی نگیرید
Cost Runaway یعنی نرخ هزینه یا هزینهٔ واحد از مرز مورد انتظار خارج شود و اگر مهار نشود، هزینه با سرعتی نامتناسب با خروجی مفید رشد کند. افزایش کل هزینه ممکن است کاملاً منطقی باشد؛ مثلاً وقتی ترافیک دو برابر شده و هزینهٔ واحد ثابت مانده است. تشخیص باید از workload، spend rate، unit cost و context با هم ساخته شود، نه از یک نمودار صورتحساب.
2. Baseline را قبل از anomaly بسازید
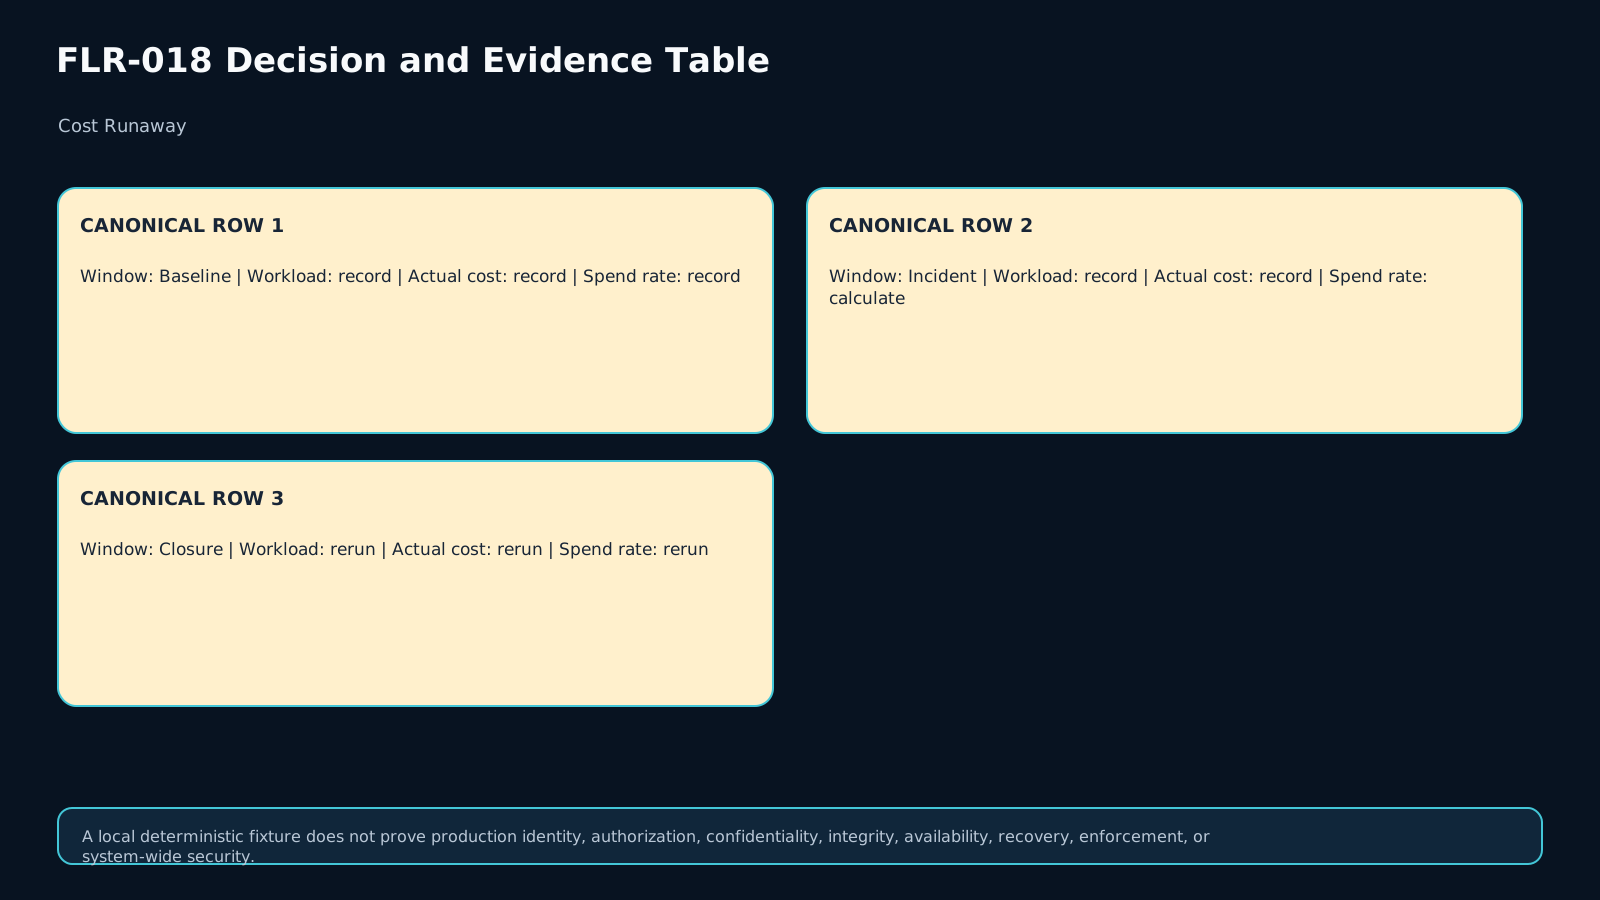
برای هر window، حداقل حجم workload، هزینه واقعی، نرخ هزینه، هزینهٔ واحد، eventهای برنامهریزیشده و forecast را ثبت کنید. بدون baseline نمیدانید افزایش ۳۰ درصدی یک anomaly است یا اثر طبیعی release، campaign، batch job یا رشد مشتری. UNKNOWN را بهجای حدس نگه دارید اگر داده تاریخی یا billing data کافی نیست.
3. Spend rate و total spend دو سیگنال متفاوتاند
Total spend میگوید تا این لحظه چقدر خرج شده؛ spend rate نشان میدهد هزینه با چه سرعتی در حال انباشت است. یک workload میتواند هنوز زیر budget ماهانه باشد ولی run rate آن نشان دهد تا چند ساعت دیگر از مرز عبور میکند. برای containment سریع، run rate اغلب زودتر از total spend هشدار عملیاتی میدهد.
4. Unit cost برای جداکردن رشد سالم از اتلاف حیاتی است
cost/request، cost/job یا هر unit economics مناسب را کنار حجم workload ببینید. اگر requests دو برابر و cost هم تقریباً دو برابر شود، افزایش ممکن است expected growth باشد. اگر workload ثابت است ولی cost سه برابر شده، retry amplification، premium tier، egress یا resource drift را بررسی کنید.
5. Usage driver را با evidence مشخص کنید
Driver را از روی label یا حدس انتخاب نکنید. retry count، provider calls، instance tier، autoscaling events، egress bytes، batch schedule و allocation metadata را به همان window هزینه bind کنید. اگر دو driver همزمان تغییر کردهاند، record باید هر دو را نگه دارد و سهم هرکدام را اگر قابل اثبات نیست UNKNOWN اعلام کند.
6. Anomaly یعنی deviation از expected behavior، نه هر افزایش
FinOps anomaly management بر مقایسه با normal/expected spend تأکید دارد. بنابراین تغییر planned مثل launch یا batch schedule ممکن است هزینه را شدیداً بالا ببرد ولی anomaly عملیاتی نباشد. برعکس، flat traffic با retry loop میتواند حتی بدون جهش بزرگ total spend یک efficiency regression جدی باشد.
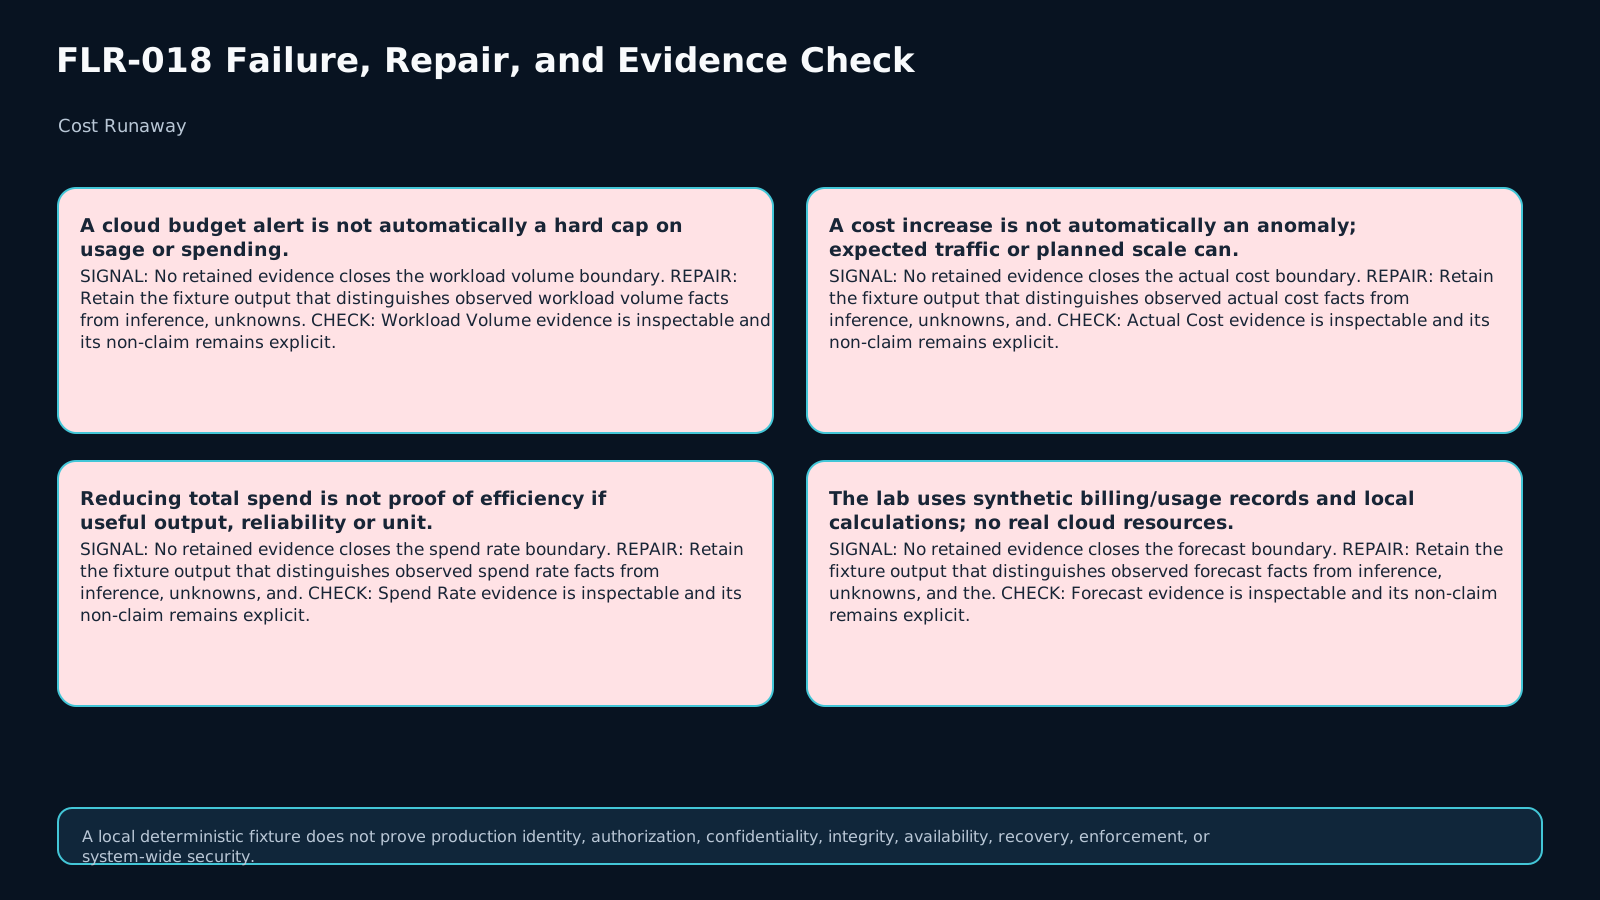
7. Budget alert را hard cap فرض نکنید
Alerts-only budget در Google Cloud صرفاً اطلاعرسانی و trigger برای action است و بهخودیخود usage را متوقف نمیکند. در ۲۰۲۶ Google برای برخی سرویسهای eligible، Spend Cap Budget را در Preview ارائه میکند؛ آن هم scope، latency و محدودیتهای خاص دارد. پس در record دقیقاً بنویسید guardrail شما alert، programmatic action، quota، admission control یا enforced cap است.
8. Guardrail باید workload-aware و reversible باشد
مهار هزینه نباید کورکورانه service را نابود کند. برای workload حیاتی ممکن است rate limit، admission control، کاهش parallelism، disable کردن premium tier یا قطع retry loop از shutdown کامل بهتر باشد. Guardrail را با availability floor و business impact همان workload طراحی کنید.
9. Containment با recovery فرق دارد
Containment یعنی رشد نامطلوب هزینه متوقف یا bounded شده است. Recovery یعنی علت هزینه اصلاح شده و workload به حالت قابل قبول برگشته است. Closure فقط وقتی مجاز است که rerun نشان دهد spend rate و unit cost به محدوده اعلامشده برگشتهاند و service impact هم از مرز مجاز عبور نکرده است.
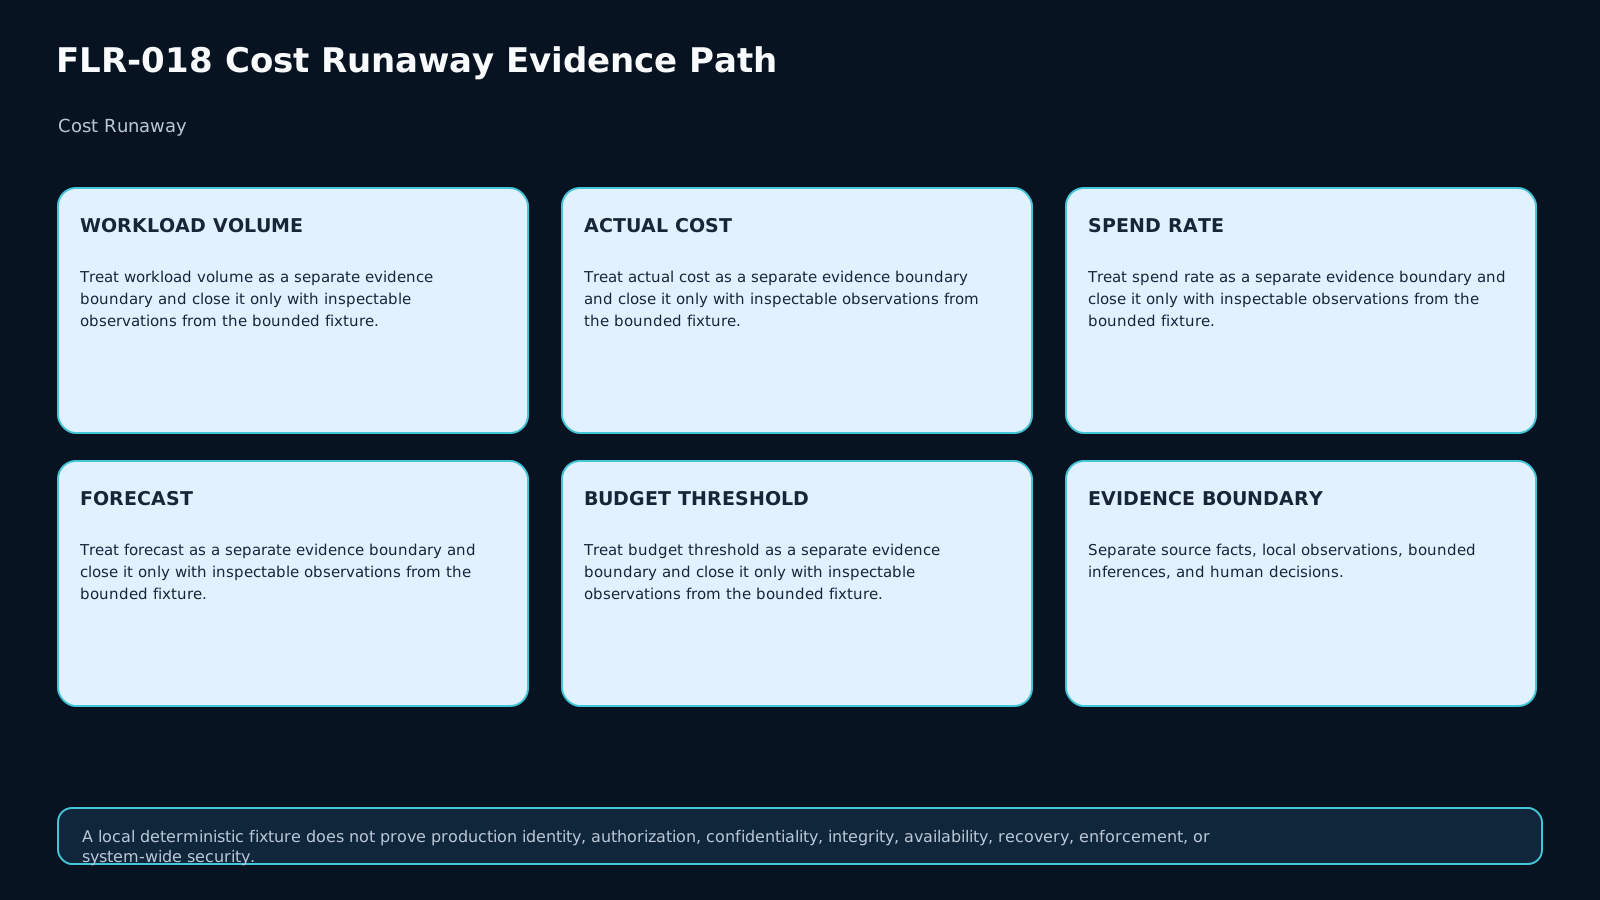
10. Forecast و budget هر دو context هستند، نه oracle
Forecast میتواند با data ناقص یا event جدید اشتباه شود؛ budget نیز policy target است، نه اثبات anomaly. record باید actual، forecast، threshold و evidence مربوط به expected event را کنار هم نگه دارد. اختلاف actual و forecast فقط یک signal است و هنوز نیاز به driver analysis دارد.
11. Cost reduction بهتنهایی proof نیست
اگر shutdown هزینه را ۹۰٪ کم کند ولی SLA یا useful output را بشکند، recovery موفق نیست. Closure باید حداقل یک شاخص خروجی مفید یا availability را کنار cost metric نگه دارد. هدف «کمترین هزینه به هر قیمت» نیست؛ هدف بازگرداندن unit economics و spend behavior به bound اعلامشده است.
12. Cost Runaway Detection, Guardrail & Recovery Record v1
Artifact اصلی ۱۳ بُعد دارد: workload volume، actual cost، spend rate، forecast، budget threshold، unit cost، usage driver، expected-growth baseline، anomaly classification، guardrail action، service impact، closure window و residual cost risk. هر بُعد باید observation، authority/policy، inference یا UNKNOWN برچسب داشته باشد.
13. Classification را از چند signal بسازید
چهار outcome اصلی این درس عبارتاند از EXPECTED_GROWTH_OR_SHIFT، COST_ANOMALY، EFFICIENCY_REGRESSION و UNKNOWN. Expected growth وقتی معتبر است که workload/output و cost تقریباً همجهت رشد کنند و unit cost در bound بماند. Efficiency regression زمانی محتمل است که cost per useful unit بدتر شود؛ Cost anomaly زمانی که spend behavior نسبت به baseline غیرمنتظره و driver شواهددار باشد.
14. Lab: هشت fixture و 64 assertion
Lab کاملاً local و synthetic است. هشت fixture شامل retry amplification، رشد طبیعی workload، flat traffic با retry، alert-only budget، hard stop که availability را میشکند، billing evidence ناقص، transfer با batch+egressِ expected و transfer با egress-driven efficiency regression است. evaluator برای هر case هشت field تولید میکند و oracle در مجموع 64 assertion را میسنجد.
15. Exit checklist و انتقال
قبل از خروج باید بتوانید توضیح دهید چرا spend increase انتخابشده anomaly است یا نیست، کدام usage driver با evidence پشتیبانی میشود، budget control دقیقاً چه semanticsی دارد، guardrail چه service impactی ایجاد میکند و closure با کدام rerun ثابت میشود. در transfer، retry loop حذف شده ولی batch و egress بالا رفتهاند؛ classification باید از evidence جدید بازسازی شود، نه از diagnosis قبلی کپی شود.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
Q1 retrieval
Why is a higher cloud bill not automatically Cost Runaway?
Q2 application
Requests double and total cost doubles while cost/request stays stable. What is the default classification?
Q3 diagnosis
Traffic is flat but provider calls triple because retries loop. What evidence points to runaway?
Q4 decision
Why is an alerts-only budget not enough to claim containment?
Q5 transfer
Retries disappear, scheduled batch traffic starts, egress rises, and unit cost worsens materially. How should the old diagnosis be used?
ملاکهای ارزیابی (rubric)
A sufficient response establishes a workload/cost baseline, distinguishes total spend from spend rate, calculates or bounds unit cost, identifies usage drivers from evidence, preserves UNKNOWN when billing data is incomplete, and separates alerts from enforced controls. Closure requires a repeatable rerun showing the abnormal driver is contained or removed, spend rate/unit cost return to declared bounds, and useful workload or service impact remains inside the stated floor. Transfer must be rebuilt from the changed batch/egress evidence rather than copying the original retry diagnosis.
منابع و تازگی
مطالعهٔ موارد (case studies)
تصاویر درس
فایلهای آزمایشگاه
Implement the bounded evaluator in starter.py for the eight supplied synthetic cases. No network calls or real cloud resources are needed. Keep workload growth, actual cost, spend rate, unit cost, expected-event evidence, retry/premium/egress drivers, budget-control semantics, and service impact as separate evidence dimensions. A higher bill alone is never enough to classify Cost Runaway. An alerts-only budget is detection evidence, not proof of containment. Preserve UNKNOWN when billing evidence is incomplete, and do not claim closure when the chosen guardrail violates the declared availability floor.
Run python run_checks.py to verify fixture shape before implementing the evaluator.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)