داده، SQL، قراردادها و ماشین حالت · فصل ۴ — Full-text، Vector و Hybrid Retrieval · 68
pgvector و Hybrid Retrieval
داده را ذخیره یا query میکند اما constraint، consistency، compatibility و recovery را به یک contract مهندسی تبدیل نمیکند. موضوع جاری: «pgvector و Hybrid Retrieval». میتواند «pgvector و Hybrid Retrieval» را برای یک domain محدود مدل کند و constraint، compatibility یا recovery evidence لازم را مشخص کند.
خلاصهٔ درس
داده را ذخیره یا query میکند اما constraint، consistency، compatibility و recovery را به یک contract مهندسی تبدیل نمیکند. موضوع جاری: «pgvector و Hybrid Retrieval».
میتواند «pgvector و Hybrid Retrieval» را برای یک domain محدود مدل کند و constraint، compatibility یا recovery evidence لازم را مشخص کند.
خروجی این درس
میتواند «pgvector و Hybrid Retrieval» را برای یک domain محدود مدل کند و constraint، compatibility یا recovery evidence لازم را مشخص کند.
پیشنیازها
1) مسئله قبل از syntax
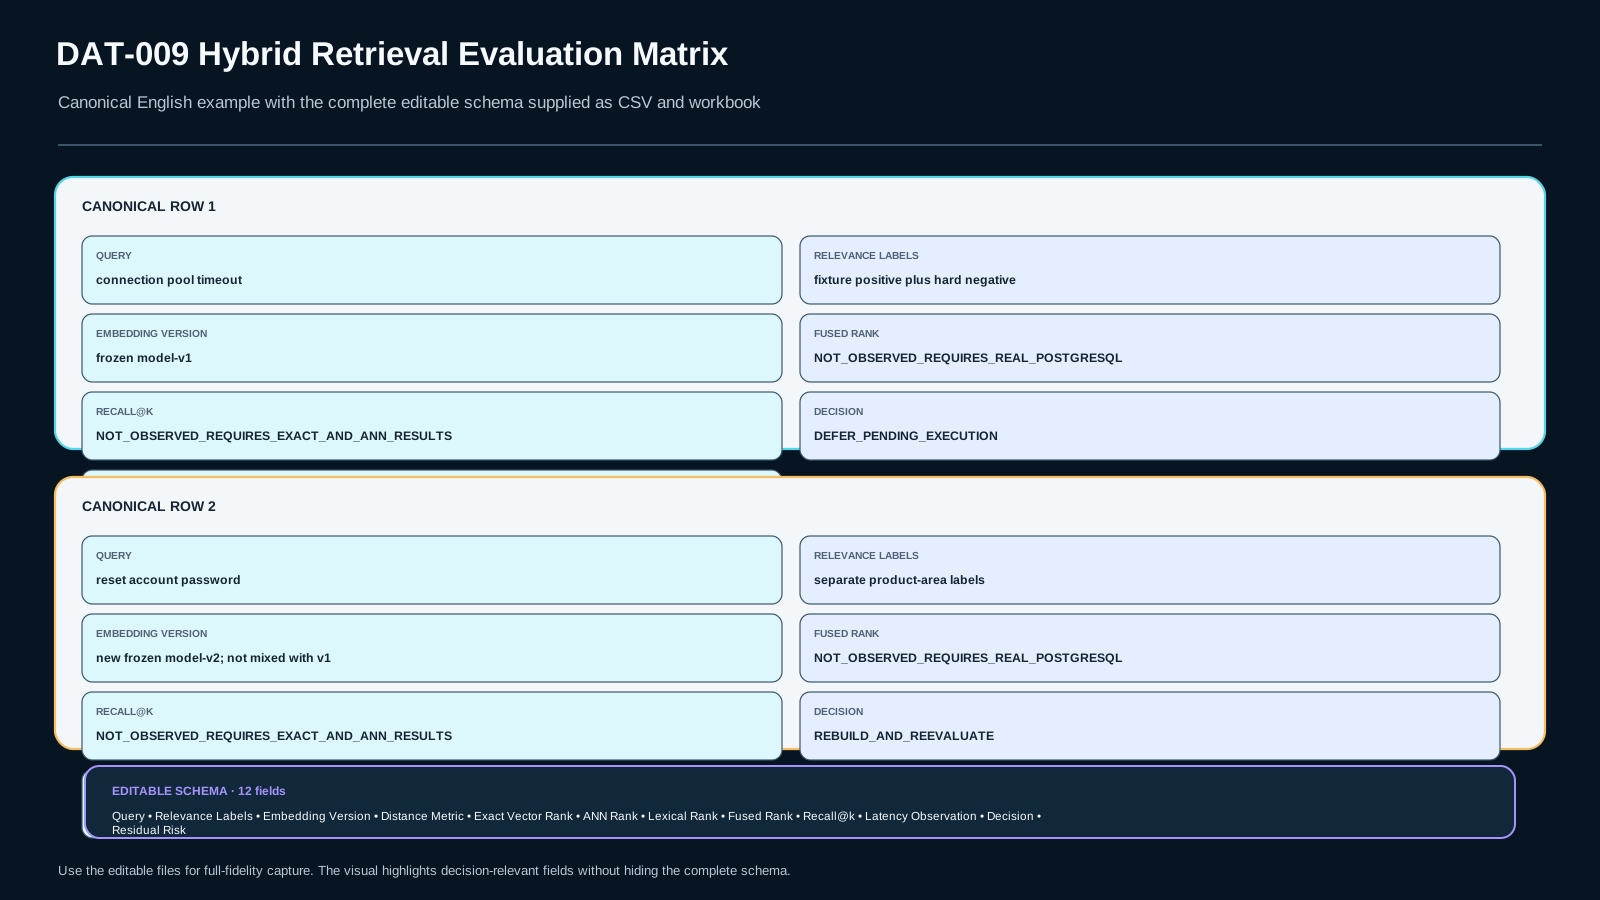
یک سیستم Hybrid Retrieval میتواند ظاهراً عالی کار کند ولی evidence ضعیفی داشته باشد. ممکن است vector search یک سند «معنادار» برگرداند، ANN سریع باشد و مسیر lexical هم عبارت دقیق را پیدا کند؛ اما هیچکدام بهتنهایی relevance را ثابت نمیکنند. در این درس retrieval را یک contract صریح میگیریم. خروجی نهایی Hybrid Retrieval Evaluation Record v1 است؛ جدولی که Query، Relevance Labels، Embedding Version، Distance Metric، Exact Vector Rank، ANN Rank، Lexical Rank، Fused Rank، Recall@k، Latency Observation، Decision و Residual Risk را جدا ثبت میکند. هدف محدود است: یک pipeline محلی PostgreSQL بسازیم، exact و approximate vector retrieval را مقایسه کنیم، baseline متنی DAT-008 را نگه داریم، fusion را شفاف انجام دهیم و دقیقاً بگوییم این شواهد چه چیزی را ثابت نمیکنند.
2) جهت مسیر و مرز درس
DAT-008 پیشنیاز سخت این درس است، چون Full-text Search آن مسیر lexical ما را میسازد. این درس مالک pgvector و مرز ارزیابی Hybrid Retrieval است؛ آموزش embedding model، فراخوانی API برای embedding، ادعای relevance عمومی و موضوع JSON Schema درس DAT-012 را جذب نمیکند. در مسیر Foundation، جدول evidence و یک failure probe راهنماییشده داریم. در مسیر Repair فقط assumption خراب را جدا میکنیم و دوباره میسنجیم. در مسیر Experienced میتوان syntax را فشرده کرد، اما exact baseline، negative evidence، relevance labels و transfer مستقل حذف نمیشوند. هیچ مسیری اجازه ندارد intuition را جای observed evidence بنشاند.
3) مدل ذهنی: قبل از fusion کانالها را مستقل نگه دار
زنجیره را اینطور ببین:
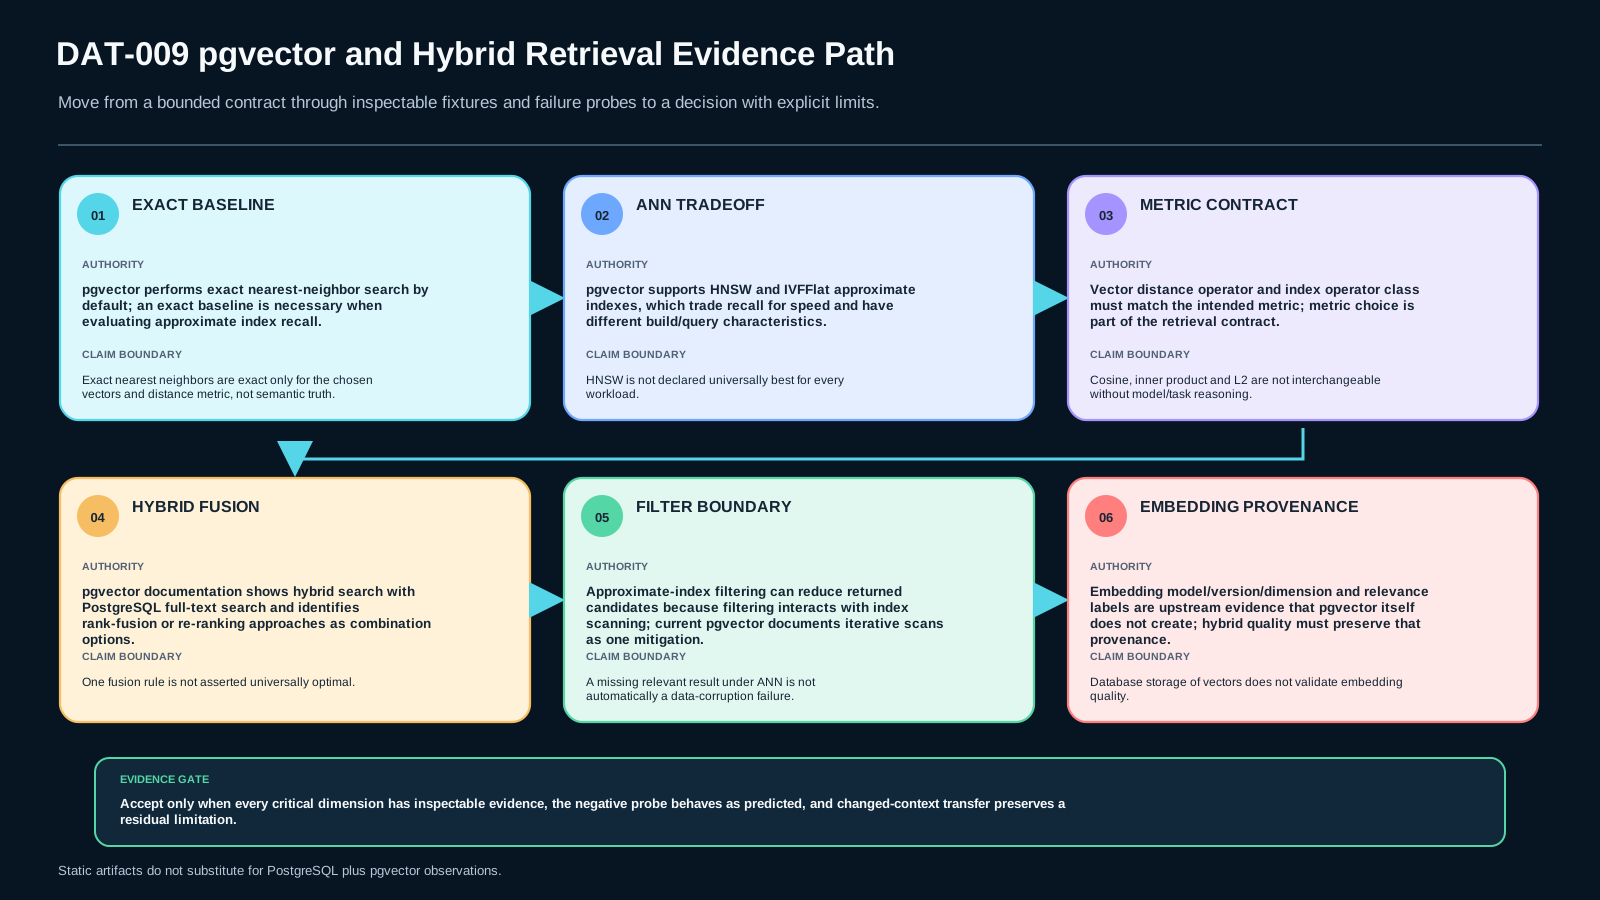
labelled query → frozen query vector + embedding_version → exact vector baseline → ANN candidate path → lexical FTS baseline → explicit rank fusion → recall/rank/latency comparison → filter/version probes → bounded decision
exact vector baseline مرجع مقایسه برای recall مسیر ANN است. کانال lexical باید قبل و بعد از fusion قابل مشاهده بماند. fusion یک لایهی تصمیم است، نه proof اینکه ورودیها درستاند. fixture برچسبدار authority مربوط به relevance judgment است؛ PostgreSQL و pgvector database/search observation میدهند. این دو authority یکی نیستند. اگر این جداسازی را نگه نداریم، یک distance کم، یک نتیجهی سریع یا توافق دو رتبه بهسادگی تبدیل به ادعای نادرست «semantic truth» میشود.
4) لایه Foundation: exact search، ANN، metric و provenance
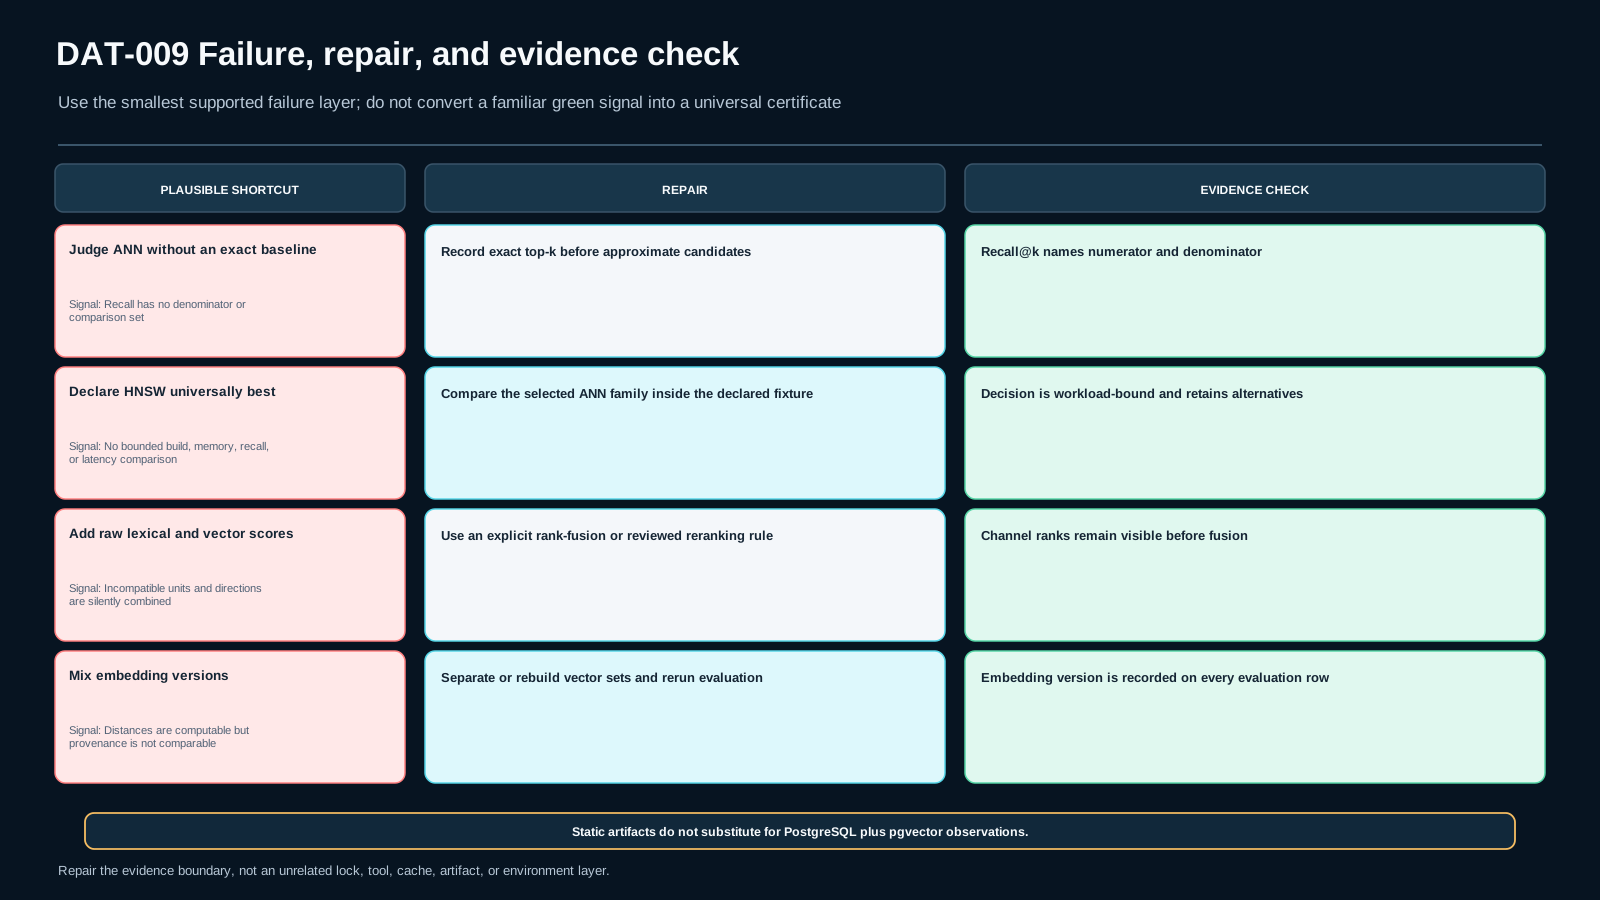
مستندات فعلی pgvector میگویند nearest-neighbor search بهصورت پیشفرض exact است. approximate index اختیاری است و بخشی از recall را با speed معامله میکند. دو خانوادهی ANN مورد استفاده در این درس HNSW و IVFFlat هستند. بنابراین اولین قانون evaluation روشن است: قبل از قضاوت دربارهی ANN، top-k exact را ثبت کن. بدون این baseline، جملهی «ANN خوب بود» فقط یک برداشت است.
Distance Metric نیز بخشی از retrieval contract است. pgvector برای L2، inner product و cosine operator و operator classهای متفاوت دارد. query مبتنی بر cosine باید با contract همان metric ارزیابی شود؛ مقایسهی L2 contract دیگری است. حتی metricی که از نظر SQL صحیح است، ممکن است برای embedding model یا task مناسب نباشد. starter عمداً metric را حل نمیکند و learner باید operator، index operator class و embedding version را کنار هم ثبت کند.
Embedding provenance شواهد upstream است. pgvector vector را ذخیره و query میکند، اما ثابت نمیکند دو vector با یک model/version ساخته شدهاند یا relevance label معتبر است. fixture baseline یک embedding_version frozen دارد. mix کردن نسخهها فقط بهعنوان failure probe کنترلشده انجام میشود.
5) توضیح عمیق: HNSW، IVFFlat، filtering و trade-off قابل اندازهگیری
HNSW یک graph چندلایه میسازد. مستندات فعلی pgvector آن را از نظر speed/recall معمولاً قویتر از IVFFlat معرفی میکنند، ولی build کندتر و memory بیشتری دارد. IVFFlat vectorها را به list تقسیم میکند، برای training مناسب به data نیاز دارد و lists و probes از کنترلهای مهم آن هستند. این توضیح vendor نقطهی شروع است، نه قانون «HNSW همیشه بهتر است». تصمیم باید روی fixture محدود خودمان evidence داشته باشد.
filtering با ANN نیز مرز مهمی دارد. وقتی query شرط category دارد، ممکن است فیلتر بعد از candidate scan اعمال شود و تعداد نتیجهی واجد شرط کمتر شود. pgvector فعلی iterative index scan را بهعنوان یکی از راههای scan بیشتر candidateها مستند میکند. به همین دلیل Evidence Record یک ردیف filter-boundary دارد: restrictive category query را با exact filtered baseline مقایسه میکنیم و candidate loss را ثبت میکنیم. نبودن یک سند در ANN زیر filter الزاماً data corruption نیست؛ یک observation برای diagnosis است.
Latency هم باید محدود تفسیر شود. fixture کوچک برای یادگیری behavior و اثبات مسیر evidence مناسب است، نه برای capacity planning. اگر timing واقعی داریم آن را همراه environment ثبت میکنیم؛ یک timing محلی نباید به ادعای production performance تبدیل شود.
6) مثال کامل: vector، lexical و fused rank را قابل بازرسی نگه دار
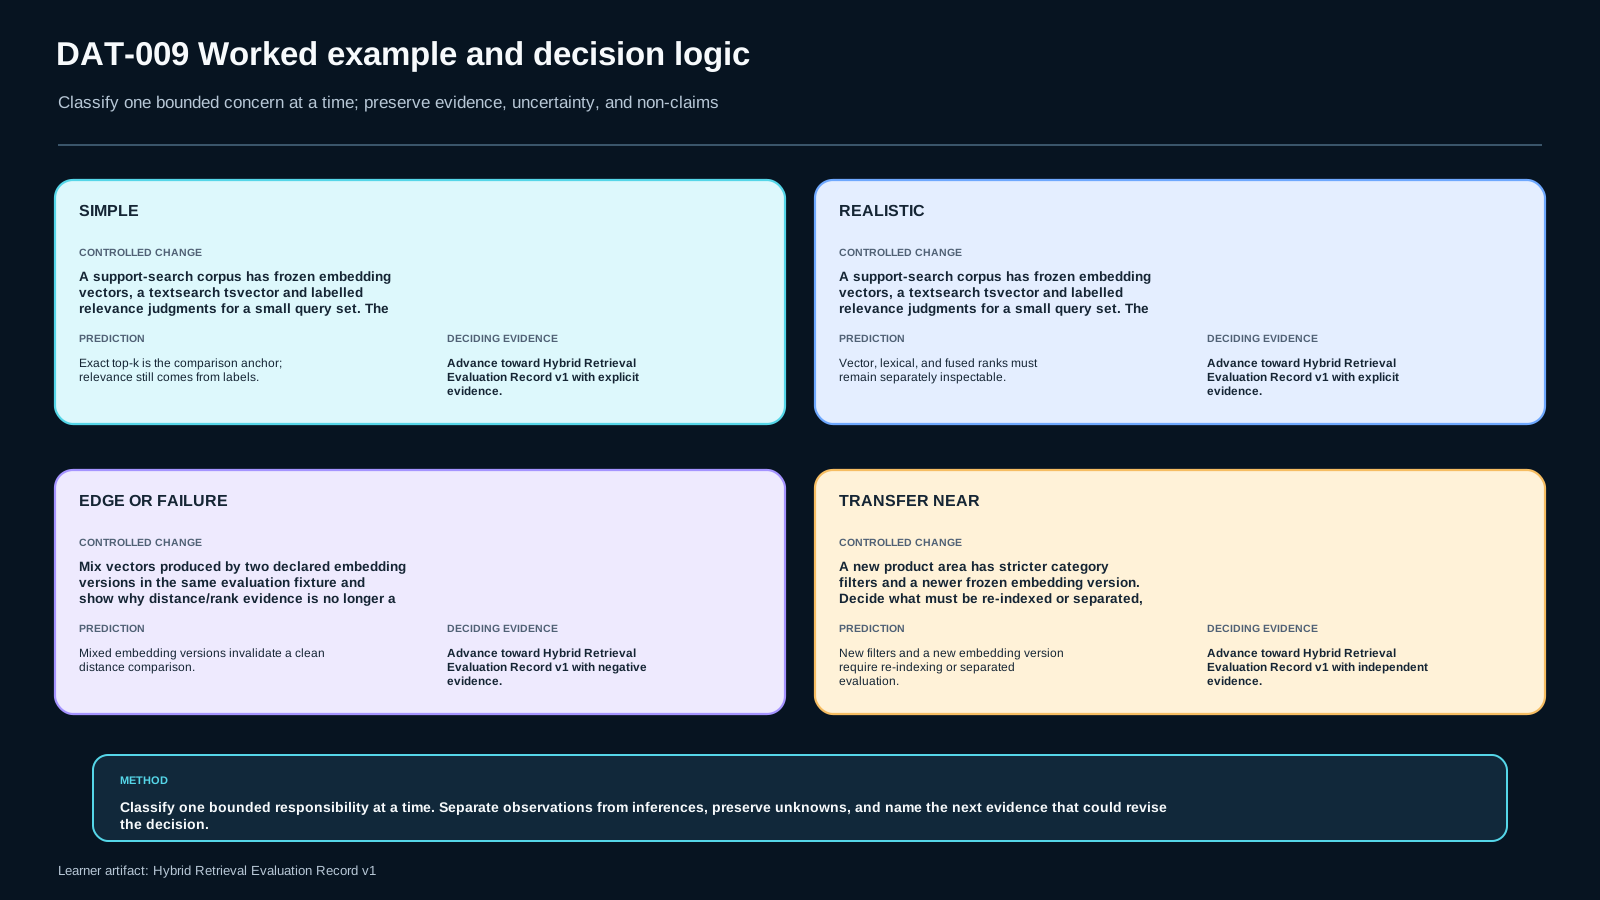
فرض کن query پشتیبانی «connection pool timeout» است. ابتدا label و frozen query vector را از fixture میخوانیم. embedding version و distance metric انتخابشده را ثبت میکنیم. سپس exact vector top-k را اجرا و ID و distance را نگه میداریم. بعد یک مسیر ANN با HNSW یا IVFFlat اجرا میکنیم و observed recall@k را نسبت به exact vector result محاسبه میکنیم. جدا از آن، PostgreSQL FTS baseline درس DAT-008 را اجرا میکنیم و lexical rank positionها را نگه میداریم.
fusion فقط وقتی مجاز است که هر دو کانال قابل دیدن باشند. Reciprocal Rank Fusion یکی از گزینههای مستند است، اما این درس آن را universally optimal نمیداند. اگر RRF انتخاب شد، parameter دقیق و فرمول مورد استفاده باید ثبت شود و fusion روی rank انجام شود، نه با جمع خام scoreهایی که scale و جهت یکسان ندارند. سپس fused list با relevance labels مقایسه میشود. تصمیم relevance متعلق به fixture ارزیابی است، نه فرمول.
تناقضها را حذف نکن. اگر ANN سندی را که exact پیدا کرده miss کرد، miss و recall@k را ثبت کن. اگر lexical یک عبارت token-exact را پیدا کرد ولی vector آن را پایین گذاشت، تفاوت را نگه دار. اگر fusion برای یک query بهتر و برای دیگری بدتر شد، هر دو را ثبت کن. هدف، decision قابل audit است نه یک لیست زیبا.
7) Failure modeهای اجباری و negative evidence
افت recall در ANN: مقدار hnsw.ef_search یا ivfflat.probes را در fixture محلی تغییر بده و top-k ANN را با exact top-k مقایسه کن. قبل از اجرا prediction بنویس. بعد فقط observed result را ثبت کن؛ مستندات tendency را توضیح میدهند ولی تضمین نمیکنند tiny fixture همیشه همان الگو را نشان دهد.
Restrictive filter: یک category filter محدودکننده روی ANN بگذار و خروجی را با exact filtered baseline مقایسه کن. اگر candidate loss دیدی، یک iterative-scan setting را امتحان کن یا bounded restriction ثبت کن. ادعا نکن iterative scan در هر limitی complete result تضمین میکند.
Embedding-version break: در یک mutation کنترلشده، دو embedding_version را در یک evaluation set مخلوط کن. ممکن است distance عددی همچنان محاسبه شود، اما comparability contract شکسته است. تا وقتی provenance حل نشده، comparison را clean evidence قبول نکن.
جمع خام scoreها: lexical score و vector distance/similarity را مستقیم جمع کن و مشکل scale/direction را آشکار کن. از این failure برای توجیه explicit rank fusion یا reranking استفاده کن، نه برای مخفیکردن normalization assumption.
8) مسیر Experienced: syntax را حذف کن، evidence را نه
اگر CREATE EXTENSION vector، operatorهای vector، HNSW، IVFFlat و PostgreSQL FTS را میشناسی، setup را سریع رد کن. اما چهار obligation باقی است: exact baseline، ANN-vs-exact comparison، lexical evidence قبل از fusion و provenance/residual-risk statement. پاسخ «HNSW سریعتر است پس HNSW» از پاسخ مبتدیای که recall/latency محدود را ثبت میکند ضعیفتر است.
برای fusion هم همین قانون برقرار است. شناخت RRF یا cross-encoder به معنی بستهشدن تصمیم نیست. توضیح بده چرا combination method انتخابشده با evidence همین lab سازگار است، یک alternative معقول نام ببر و فراموش نکن relevance label بیرون از pgvector تعریف شده است.
9) Alternativeها و trade-offها را شفاف نگه دار
Exact vector search یک baseline معتبر است و برای subset کوچک یا filter محدود حتی میتواند انتخاب عملی باقی بماند. HNSW و IVFFlat دو alternative با trade-off متفاوت در build، memory و query behavior هستند. lexical-only در domainهای token-exact ممکن است کافی باشد؛ vector-only در مسئلهای با semantic similarity پررنگ ممکن است مناسب باشد؛ Hybrid Retrieval فقط وقتی توجیه دارد که objective محدود از هر دو کانال سود ببرد و complexity اضافهشده واقعاً ارزیابی شود.
RRF تنها fusion method نیست. cross-encoder یا reranking دیگر ممکن است در سیستم دیگری مناسب باشد، اما آنها runtime و model evidence جدید میخواهند و خارج از lab محلی هستند. این درس آن مرز را صریح مینویسد و evidence خارجی جعل نمیکند. tuning پارامترهای ANN هم در اینجا instructional است و جای performance engineering در production را نمیگیرد.
10) تمرین هدایتشده و مستقل
قبل از SQL یک retrieval objective بنویس. نمونه: «برای corpus frozen پشتیبانی و query set برچسبدار، exact vector، یک ANN candidate path و lexical baseline DAT-008 را مقایسه میکنم؛ fusion فقط بعد از حفظ rankهای هر کانال انجام میشود و recall@k و latency observation محدود ثبت میشود.» یک non-goal هم اضافه کن: «این fixture کیفیت عمومی search را ثابت نمیکند.»
starter عمداً Distance Metric، ANN family، ANN parameter، fusion parameter/decision و acceptance decision را باز میگذارد. قبل از اجرای failure probe prediction بنویس. Evidence Record فقط باید output واقعی database یا labelهای صریح fixture را بگیرد. اگر psql در محیط اجرا نشده، neighborها، recall، rank یا timing را از روی حدس پر نکن.
برای transfer مستقل، product area جدید category filter سختتر و embedding version جدید دارد. مشخص کن کدام index یا vector set باید جدا یا rebuild شود، کدام exact/ANN comparison تاریخی دیگر comparable نیست، lexical baseline تا چه حد منتقل میشود و چه ردیفهای evaluation باید دوباره اجرا شوند. روش reasoning باید منتقل شود، نه نتیجهی قبلی.
11) Verification و Hybrid Retrieval Evaluation Record v1
برای هر query حداقل این ستونها لازم است: Query, Relevance Labels, Embedding Version, Distance Metric, Exact Vector Rank, ANN Rank, Lexical Rank, Fused Rank, Recall@k, Latency Observation, Decision, Residual Risk. یک observation_vs_judgment_note هم اضافه کن. Returned IDs، distance، rank position و timing واقعی database observation هستند. relevance labels authority مربوط به fixture هستند. Decision و residual risk judgment learner هستند.
یک evidence package قوی baseline مثبت، حداقل یک failure عمدی، repair یا bounded restriction، transfer context و یک residual limitation دارد. اگر PostgreSQL 18 + pgvector واقعی اجرا نشده، runtime status باید NOT_RUN بماند؛ exact/ANN neighbor، recall، lexical/fused rank یا timing نباید fabricate شود. static validation فقط ساختار candidate و contractهای safety/evidence را اثبات میکند.
12) Assessment و transfer
learner موفق باید توضیح دهد چرا exact search baseline ارزیابی ANN است؛ HNSW و IVFFlat را بدون universal claim مقایسه کند؛ metric و index operator class را سازگار نگه دارد؛ lexical و vector rank را قبل از fusion حفظ کند؛ observed recall@k را از top-kهای واقعی حساب کند؛ filter candidate loss را diagnosis کند؛ embedding-version break را تشخیص دهد؛ naive score addition را رد کند و یک bounded hybrid decision با residual uncertainty دفاع کند.
transfer blocking است: category constraint و embedding version عوض میشود. learner باید بگوید چه evidenceای دیگر comparable نیست و چه چیزهایی باید rerun شود. پاسخ در صورتی fail است که nearest vector را relevance truth بداند، ANN را perfect-recall فرض کند، یک fusion rule را universally optimal اعلام کند یا governance embedding model را به pgvector نسبت دهد.
13) منابع و freshness
source boundary عمداً فقط دو منبع دارد: PGVECTOR-README و PG18-FTS. تاریخ frozen retrieval برابر 2026-09-02 و earliest review due برابر 2026-10-17 است. در 2026-09-15 همان locatorهای رسمی دوباره بررسی شدند. pgvector همچنان exact search را default معرفی میکند، HNSW و IVFFlat را ANN index type میداند، filtering و iterative scan را توضیح میدهد و Hybrid Search را همراه PostgreSQL Full-text Search و گزینههایی مانند RRF یا cross-encoder ذکر میکند. مستندات PostgreSQL 18 نیز authority کانال lexical باقی مانده است. source جدیدی اضافه نشده و claim boundary توسعه پیدا نکرده است. با تغییر behavior نسخهای یا رسیدن review_due، claimهای متاثر باید دوباره بررسی شوند.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
DAT-009-S1 retrieval
State the bounded hybrid-retrieval contract, one non-goal, and why exact vector top-k is required before ANN recall claims.
DAT-009-S2 application
Using the disposable fixture, execute exact vector, one ANN path and the lexical baseline; preserve raw channel ranks and complete evidence rows using real observations only.
DAT-009-S3 diagnosis
Run one deliberate failure probe involving ANN recall, filtering, embedding-version provenance, or incompatible raw-score fusion; diagnose and repair or bound it.
DAT-009-S4 decision
Defend the chosen metric, ANN family and fusion method against one plausible alternative without claiming universal superiority.
DAT-009-S5 transfer
For stricter category filters and a newer embedding version, identify what must be separated/rebuilt and what evidence must be rerun before comparison.
ملاکهای ارزیابی (rubric)
Pass requires four critical dimensions: retrieval-contract correctness, evidence quality, scope discipline, and transfer independence. Evidence must preserve exact-vs-ANN comparison, metric/provenance contract, independent lexical and vector ranks before fusion, at least one negative probe, and a residual limitation. Any fabricated runtime result or universal quality claim fails the affected critical dimension.
منابع و تازگی
مطالعهٔ موارد (case studies)
فایلهای آزمایشگاه
- Copy
../sql/03_hybrid_workbench.template.sqlto03_hybrid_workbench.sql. - Copy
../sql/04_failure_probes.template.sqlto04_failure_probes.sql. - Replace every
__TODO___token without deleting theDAT009_evidence markers or metric/family/fusion metadata lines. - Run only through
../src/run_local_lab.pyagainst the explicitly confirmed disposable loopback database. - Use the runtime transcript/receipt to complete the evidence record. Static checks alone do not create retrieval evidence.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)