داده، SQL، قراردادها و ماشین حالت · فصل ۴ — Full-text، Vector و Hybrid Retrieval · 67
PostgreSQL Full-text Search
داده را ذخیره یا query میکند اما constraint، consistency، compatibility و recovery را به یک contract مهندسی تبدیل نمیکند. موضوع جاری: «PostgreSQL Full-text Search». میتواند «PostgreSQL Full-text Search» را برای یک domain محدود مدل کند و constraint، compatibility یا recovery evidence لازم را مشخص کند.
خلاصهٔ درس
داده را ذخیره یا query میکند اما constraint، consistency، compatibility و recovery را به یک contract مهندسی تبدیل نمیکند. موضوع جاری: «PostgreSQL Full-text Search».
میتواند «PostgreSQL Full-text Search» را برای یک domain محدود مدل کند و constraint، compatibility یا recovery evidence لازم را مشخص کند.
خروجی این درس
میتواند «PostgreSQL Full-text Search» را برای یک domain محدود مدل کند و constraint، compatibility یا recovery evidence لازم را مشخص کند.
پیشنیازها
1) مسئله قبل از syntax
جستوجوی متنی وقتی خطرناک میشود که «چند نتیجهی ظاهراً خوب» را با «سیستم جستوجوی قابل دفاع» یکی بگیریم. در این درس یک کاتالوگ مستندات کوچک با فیلدهای title و body داریم. خروجی مورد انتظار فقط یک query موفق نیست؛ باید PostgreSQL Full-text Search Evidence Record v1 را بسازیم و در آن configuration، سند جستوجوشونده، query parser، match، rank، شواهد index/plan، قضاوت relevance و یک محدودیت باقیمانده را از هم جدا نگه داریم. هدف، ساخت یک pipeline محدود و قابل falsify است؛ نه ادعای اینکه Full-text Search همان semantic search است یا هر مسئلهی جستوجویی را حل میکند.
2) جهت مسیر و مرز درس
پیشنیاز DAT-006 باید reasoning لازم برای قرارداد داده و شواهد را فراهم کرده باشد. این درس فقط retrieval متنی PostgreSQL را مالک است؛ درس بعدی DAT-009 به pgvector و Hybrid Retrieval میرود. بنابراین در اینجا vector embedding، ANN، fusion و semantic retrieval را وارد تصمیم نمیکنیم. سؤال اصلی این است: برای یک domain محدود، چه configuration و parser و weightingای انتخاب میکنیم، چه چیزی را PostgreSQL واقعاً مشاهده کرده، و کدام بخش هنوز judgment محصول است؟
3) مدل ذهنی: زنجیره را قطعهقطعه ببین
زنجیرهی کاری را اینطور نگه دار:
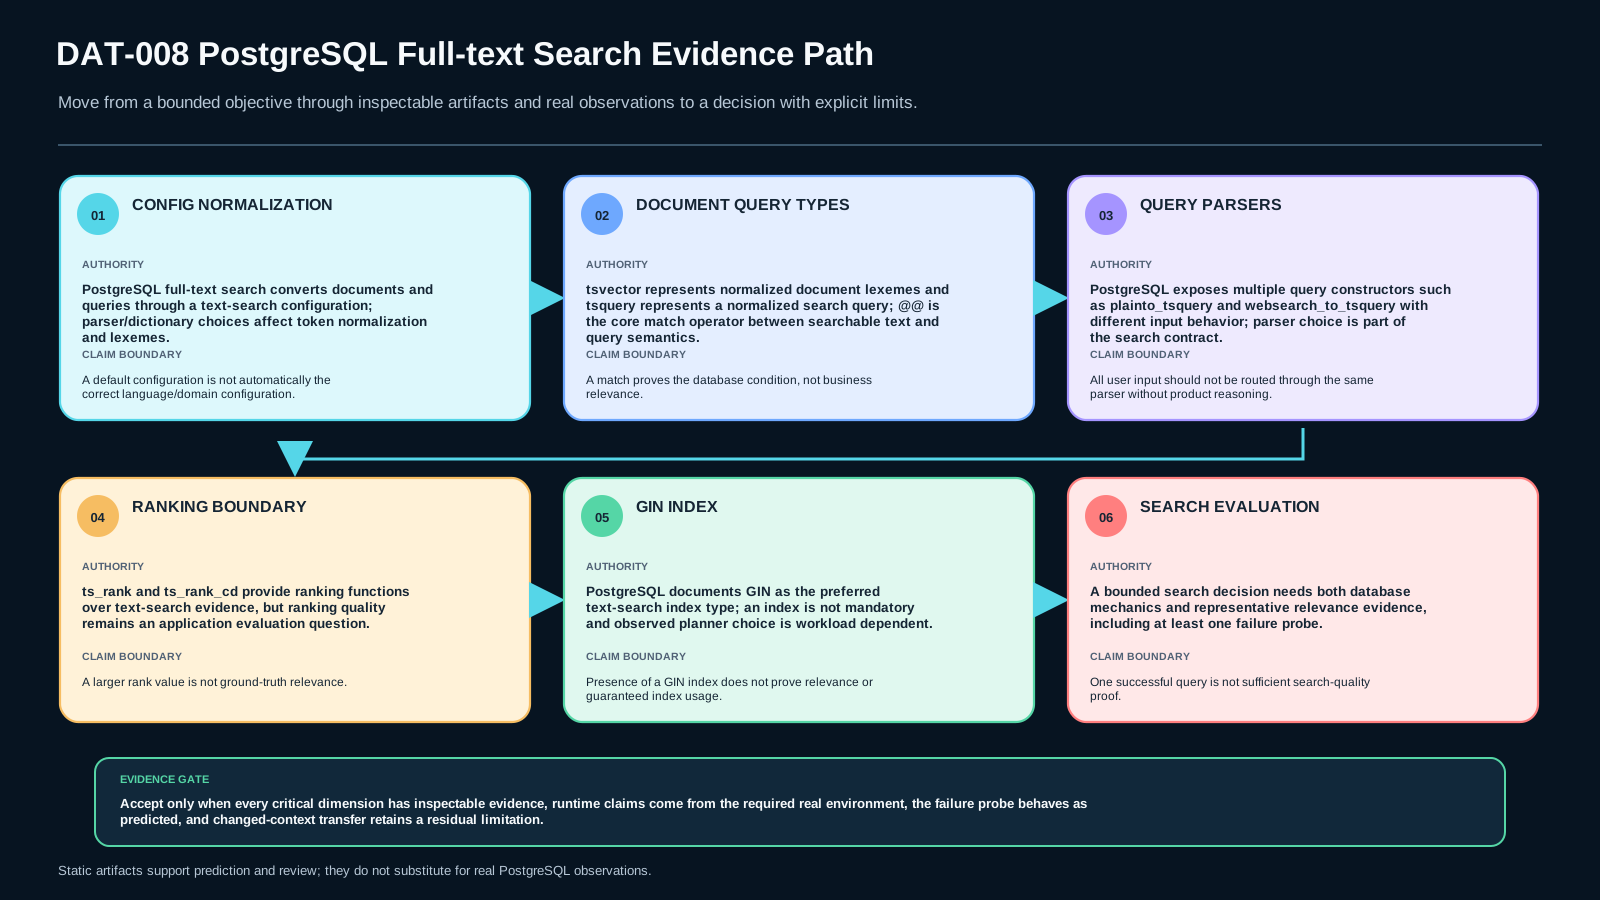
title/body → explicit text-search configuration → tsvector → tsquery parser → @@ match → rank → labelled relevance check → index/EXPLAIN observation → bounded decision
هر پیکان یک contract جدا دارد. to_tsvector متن را با configuration انتخابشده به lexemeهای نرمالشده تبدیل میکند. query هم باید به tsquery تبدیل شود. عملگر @@ فقط میگوید شرط text-search برقرار شده یا نه. ts_rank یا ts_rank_cd برای مرتبسازی شواهد متنی بهکار میروند، اما عدد rank ground truth relevance نیست. در انتها، fixture برچسبدار و observation برنامهریز را کنار هم میگذاریم و فقط یک تصمیم محدود میگیریم.
4) Configuration و normalization را implicit نگذار
Text-search configuration تعیین میکند parser و dictionaryها چگونه tokenها را به lexeme تبدیل کنند. استفاده از default بدون نوشتن دلیل، یک dependency پنهان میسازد: با تغییر محیط یا زبان محصول، همان query ممکن است معنی عملی دیگری پیدا کند. در lab باید configuration بهصورت صریح ثبت شود و برای یک نمونه، خروجی normalization دیده شود. مقایسهی english و simple میتواند نشان دهد stemming و stop-word handling چگونه evidence را تغییر میدهند؛ این مقایسه برای یادگیری است، نه اینکه یکی همیشه «بهتر» باشد.
5) Document vector، وزنها و query parser بخشی از قراردادند
tsvector نمایش نرمالشدهی سند است و میتواند از چند فیلد ساخته شود. وزندهی title و body با setweight فقط یک تصمیم ranking است؛ اگر وزنها را عوض کنیم و ترتیب نتایج بهتر به نظر برسد، هنوز باید آن را با queryهای برچسبدار بررسی کنیم. در سمت query، plainto_tsquery متن ساده را به AND میان lexemeهای باقیمانده تبدیل میکند، در حالی که websearch_to_tsquery syntax نزدیکتر به web search، از جمله quoted phrases، OR و منفیسازی را میپذیرد. parser را براساس شکل واقعی ورودی کاربر انتخاب کن، نه براساس راحتی demo. در fixture جدید، سند ۷ یک hard negative برای Q2 است: هر دو واژهی «pool» و «connection» را دارد اما adjacency عبارت نقلقولشده را ندارد؛ بنابراین انتخاب parser واقعاً قابل falsify است، نه صرفاً قابل توضیح.
6) Worked example: نتیجهی جذاب کافی نیست
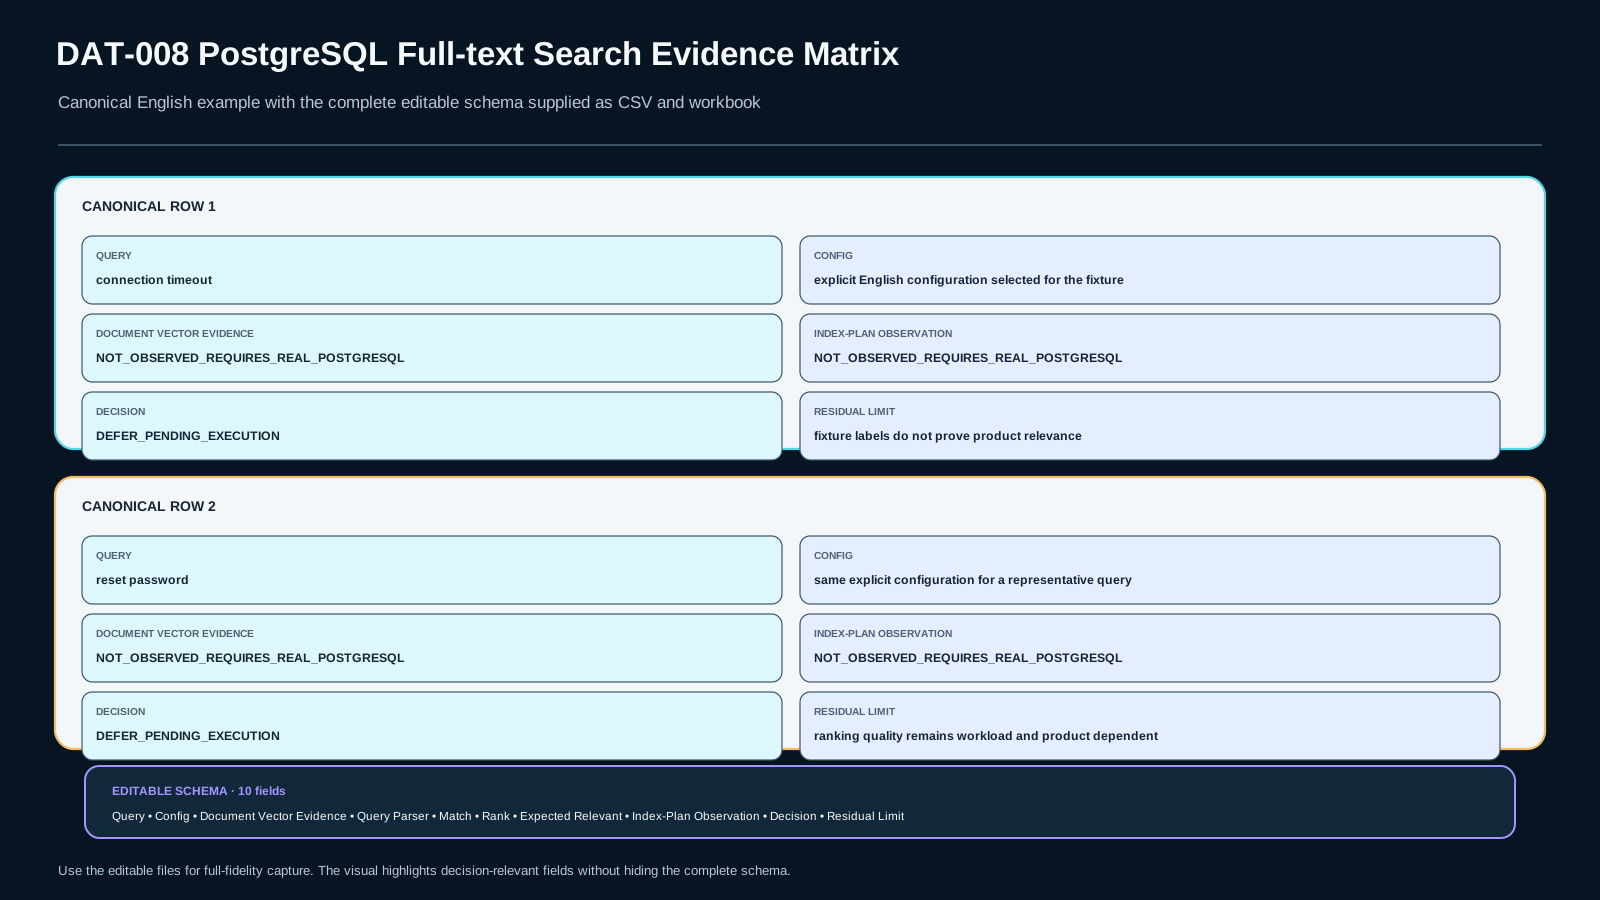
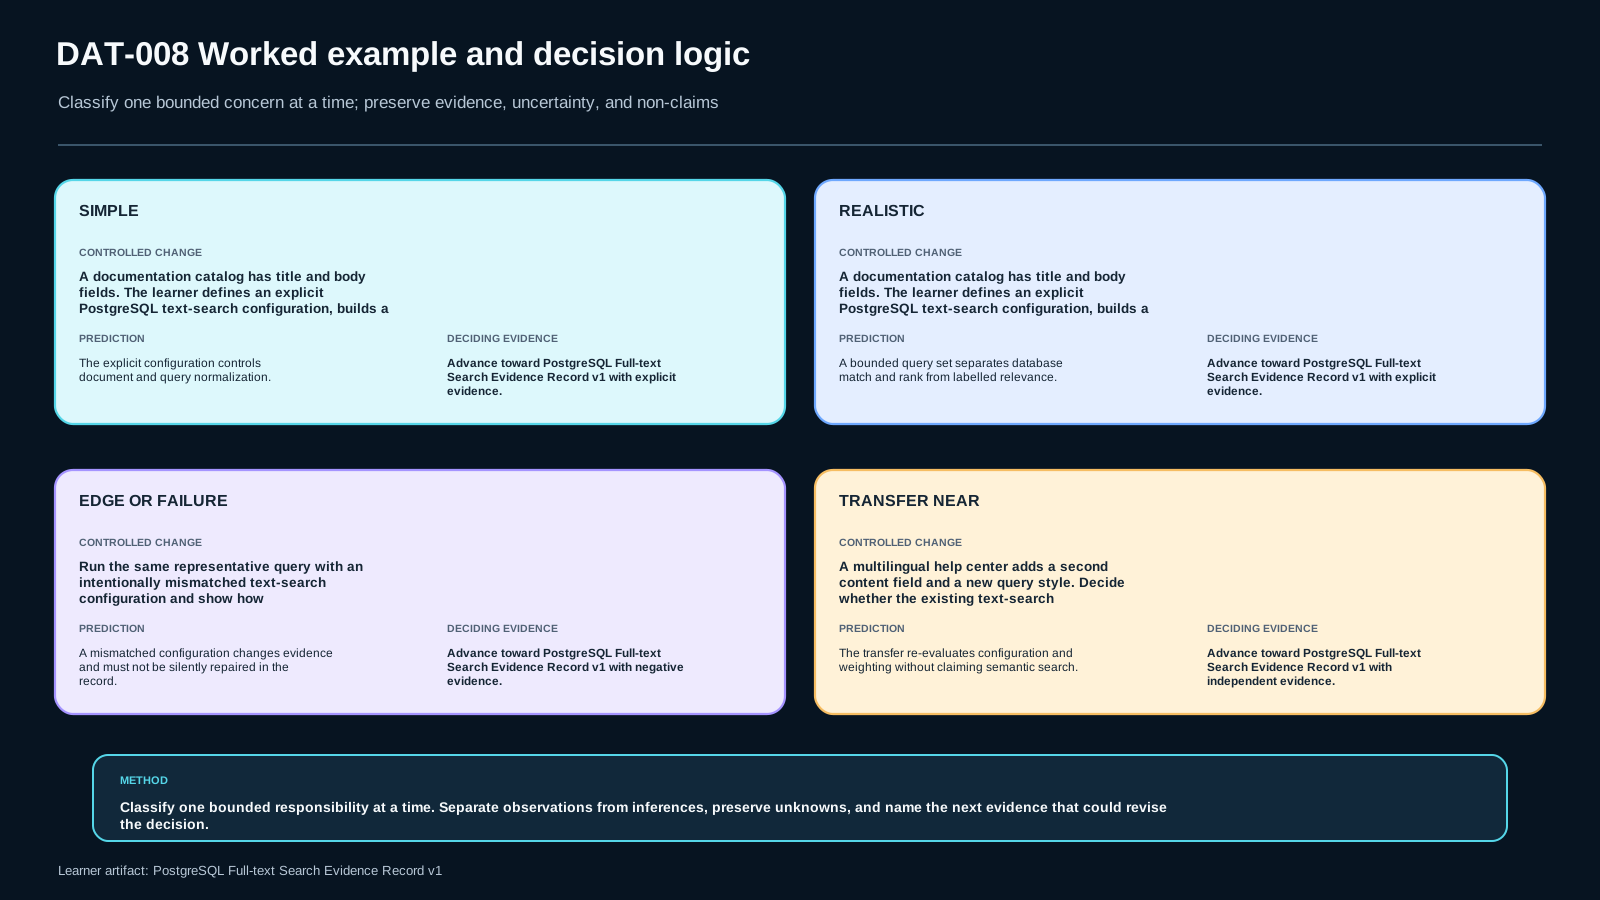
فرض کن query «connection timeout» اجرا میشود. ابتدا query label و expected-relevant document IDs را از fixture بخوان. بعد configuration و parser انتخابی را ثبت کن، tsvector و tsquery نمونه را inspect کن، matchها را بگیر و rank را محاسبه کن. سپس نتیجه را با expected relevance مقایسه کن. اگر سندی rank بالاتری دارد ولی در fixture relevant نیست، این contradiction ارزشمند است: نشان میدهد ranking function فقط evidence درون text-search را مرتب میکند و judgment relevance باید خارج از آن سنجیده شود. تصمیم نهایی باید بگوید چه چیزی قبول شده، چه چیزی رد شده و چه چیزی هنوز نامعلوم است.
7) Failure modes اجباری
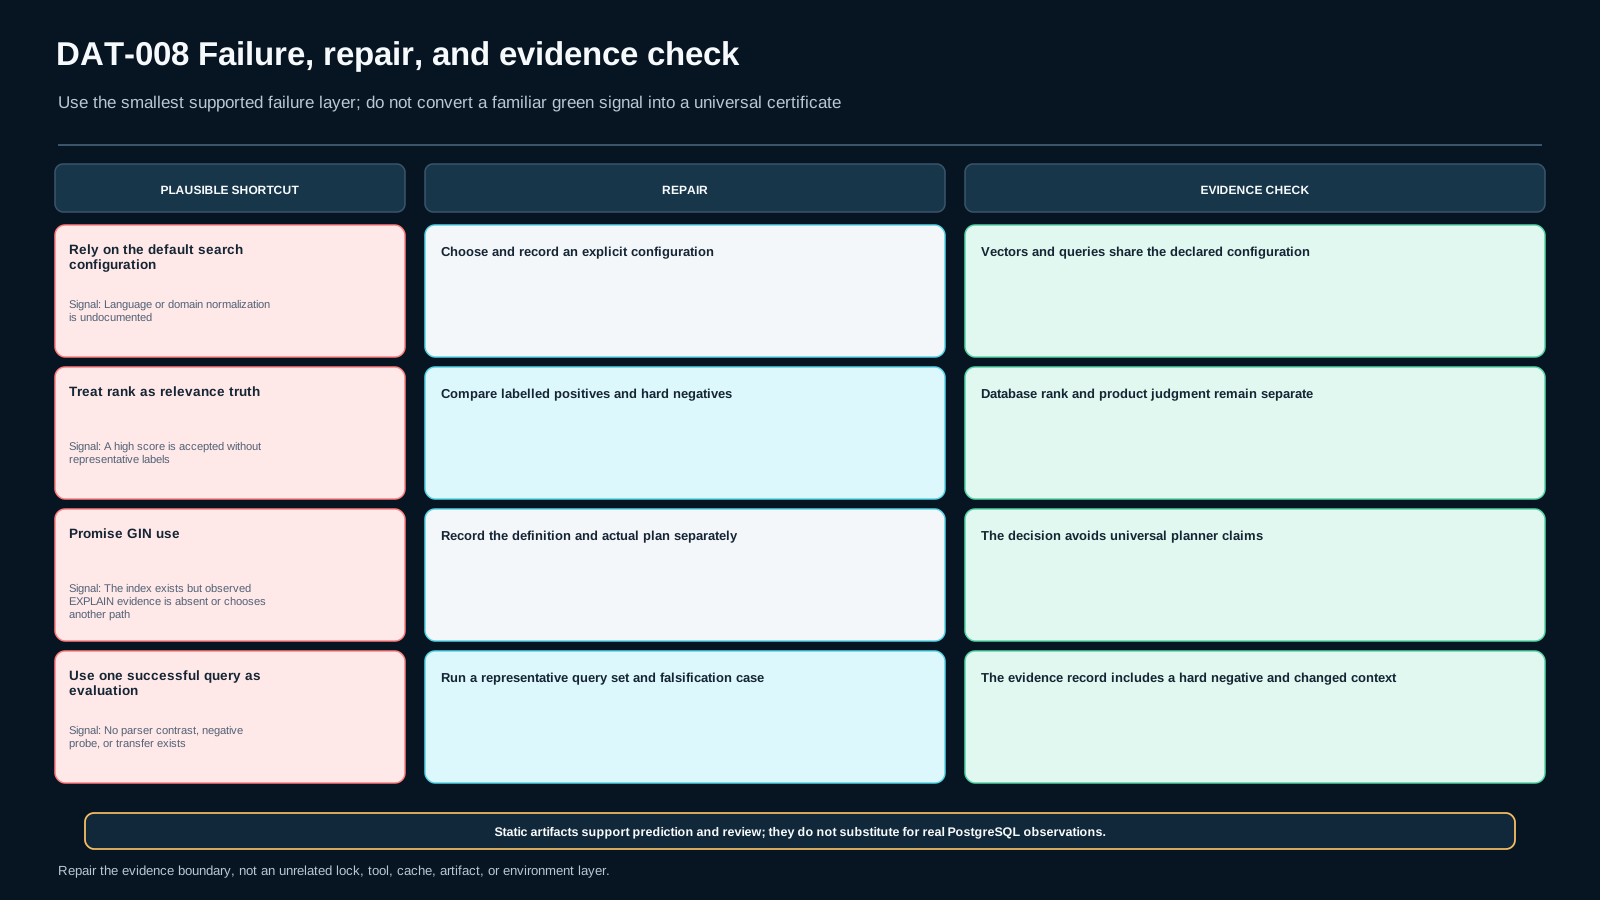
Configuration mismatch: همان query را با configuration عمداً نامتناسب اجرا کن و lexeme/match را مقایسه کن. اگر رفتار تغییر کرد، dependency configuration را evidence کردهای.
Stop-word-heavy query: queryای انتخاب کن که dictionary behavior را آشکار کند. observation را ثبت کن؛ از یک مورد به همهی زبانها تعمیم نده.
Ranking ≠ truth: یک query با matchهای plausible اما relevance برچسبدار ضعیف پیدا کن. rank بالا را success ننام.
Index ≠ guaranteed plan: GIN index را تعریف کن، سپس EXPLAIN را ثبت کن. روی جدول کوچک ممکن است planner به دلایل هزینهای sequential scan را انتخاب کند. وجود index و استفادهی planner دو observation متفاوتاند. اگر expression index میسازی، expression و configuration صریحِ index باید از نظر معنایی با expression جستوجو همراستا بماند؛ صرف وجود index ثابت نمیکند query فعلی قابلیت استفاده از همان index را دارد.
8) مسیر experienced: syntax را کوتاه کن، evidence را نه
اگر از قبل با to_tsvector, tsquery و GIN آشنا هستی، بخشهای syntax را سریع رد کن؛ اما چهار چیز حذف نمیشوند: prediction قبل از اجرا، negative probe، relevance fixture و residual limit. مسیر experienced باید حتی سختگیرانهتر در برابر overclaim باشد. یک query موفق یا یک plan سریع، بهتنهایی قرارداد retrieval را نمیبندد.
9) Alternatives و trade-offها را bounded نگه دار
ILIKE یا substring search ذاتاً «غلط» نیست؛ برای domain کوچک، prefix ساده، exact substring یا requirement محدود ممکن است کافی باشد. Full-text Search زمانی معنیدار میشود که normalization، query semantics، weighting و indexing برای مسئله ارزش داشته باشند. همچنین Full-text Search را با semantic vector search جایگزین نکن: این دو evidence و failure mode متفاوت دارند. این درس فقط انتخاب داخل boundary خودش را دفاع میکند و هر نیاز semantic را به DAT-009 defer میکند.
10) تمرین هدایتشده و مستقل
در بخش هدایتشده، اول یک objective بنویس: مثلاً «برای queryهای پشتیبانی انگلیسی، title و body را با configuration صریح جستوجو میکنم و سه query برچسبدار را برای match/rank بررسی میکنم». سپس قبل از اجرای failure probe، نتیجهی مورد انتظار را پیشبینی کن. Lab starter schema و corpus و query labels را میدهد اما configuration نهایی، وزنها، parser نهایی، index decision و acceptance row را برای تو حل نمیکند.
در بخش مستقل، یک help center چندزبانه فیلد دوم محتوایی و query style جدید اضافه میکند. باید تصمیم بگیری آیا configuration، weighting، parser و index evidence قبلی هنوز معتبرند. بدون وارد کردن vector retrieval، Evidence Record را بهروزرسانی کن و حداقل یک assumption که دیگر معتبر نیست مشخص کن.
11) Verification و Evidence Record
برای هر query حداقل این ستونها را پر کن: Query, Config, Document Vector Evidence, Query Parser, Match, Rank, Expected Relevant, Index-Plan Observation, Decision, Residual Limit. Observation پایگاهداده را از inference جدا بنویس. اگر PostgreSQL واقعی اجرا نشده، هیچ match، rank یا plan ساختگی ثبت نکن و runtime status را NOT_RUN نگه دار. Evidence خوب شامل baseline مثبت، failure منفی، repair یا bounded decision، transfer و یک محدودیت صریح است.
12) Assessment و transfer
قبولی یعنی بتوانی توضیح دهی چرا configuration صریح است، تفاوت tsvector و tsquery را حفظ کنی، parser مناسب را براساس input contract انتخاب کنی، @@ را از relevance judgment جدا کنی، rank را evidence نسبی بدانی نه حقیقت، و GIN را «preferred text-search index type» بدانـی بدون اینکه استفادهی آن توسط planner را تضمین کنی. در transfer باید همین reasoning را روی context جدید مستقل اجرا کنی و conclusion آماده از starter نگیری.
13) منابع و freshness
Source boundary عمداً فقط سه منبع رسمی PostgreSQL 18 است: PG18-FTS, PG18-FTS-CONFIG, PG18-GIN. این منابع رفتار Full Text Search، configuration و GIN را پوشش میدهند. snapshot اصلی در 2026-09-02 گرفته شده و review_due برابر 2026-10-17 است. در 2026-09-15 همان locatorهای رسمی دوباره بررسی شدند و drift معناداری در claimهای این درس دیده نشد. اگر مستندات نسخه، رفتار parser/ranking یا index guidance تغییر کند، claimهای وابسته باید دوباره review شوند؛ scope منبع بدون تغییر قرارداد گسترش پیدا نمیکند.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
DAT-008-S1 retrieval
State the bounded PostgreSQL full-text search contract, name one non-goal, and explain why an explicit text-search configuration belongs in the contract.
DAT-008-S2 application
Using the disposable fixture, build the bounded search pipeline and complete the evidence rows with real observations only.
DAT-008-S3 diagnosis
Run one deliberate failure probe, diagnose the changed lexemes/matches/ranking or plan evidence, and record the repair or bounded restriction.
DAT-008-S4 decision
Defend the chosen parser/index/search mechanism against one plausible simpler alternative without claiming universal superiority.
DAT-008-S5 transfer
For the multilingual changed-context case, decide what must change in configuration, weighting, parser and evidence; do not introduce vector retrieval.
ملاکهای ارزیابی (rubric)
- Retrieval-contract correctness: configuration, document/query representation, parser, match and ranking boundaries are explicit.
- Evidence quality: positive, negative, repair/bounded-decision and relevance observations are traceable and not fabricated.
- Scope discipline: full-text search is not conflated with semantic vector retrieval; GIN existence is not treated as guaranteed planner use.
- Transfer independence: the multilingual changed-context case is solved without a copied final configuration or conclusion.
منابع و تازگی
مطالعهٔ موارد (case studies)
فایلهای آزمایشگاه
Create exactly these two files before a real run:
03_search_workbench.sql— copy from../sql/03_search_workbench.template.sqland replace every__TODO_*__token.04_failure_probe.sql— copy from../sql/04_failure_probes.template.sql, implement at least one predicted negative probe, and remove the placeholder.
Run only through ../src/run_postgres.py. The runner is fail-closed: loopback host, database name prefix maknow_dat008_, explicit disposable confirmation, PostgreSQL major 18, bounded timeouts, fresh runtime evidence, and cleanup are mandatory.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)