داده، SQL، قراردادها و ماشین حالت · فصل ۱ — Constraint، Query و Reasoning · 61
استدلال در کوئری SQL: JOIN، CTE، Window، Aggregate و EXPLAIN
داده را ذخیره یا query میکند اما constraint، consistency، compatibility و recovery را به یک contract مهندسی تبدیل نمیکند. موضوع جاری: «SQL Query Reasoning: JOIN, CTE, Window, Aggregate, EXPLAIN». میتواند «SQL Query Reasoning: JOIN, CTE, Window, Aggregate, EXPLAIN» را برای یک domain محدود مدل کند و constraint، compatibility یا recovery evidence لازم را مشخص کند.
SQL Query Reasoning: JOIN, CTE, Window, Aggregate, EXPLAIN — en-US
خلاصهٔ درس
داده را ذخیره یا query میکند اما constraint، consistency، compatibility و recovery را به یک contract مهندسی تبدیل نمیکند. موضوع جاری: «SQL Query Reasoning: JOIN, CTE, Window, Aggregate, EXPLAIN».
میتواند «SQL Query Reasoning: JOIN, CTE, Window, Aggregate, EXPLAIN» را برای یک domain محدود مدل کند و constraint، compatibility یا recovery evidence لازم را مشخص کند.
خروجی این درس
میتواند «SQL Query Reasoning: JOIN, CTE, Window, Aggregate, EXPLAIN» را برای یک domain محدود مدل کند و constraint، compatibility یا recovery evidence لازم را مشخص کند.
۱. صفحه اول — کوئری میتواند ظاهراً درست باشد اما سؤال اشتباهی را جواب بدهد
تیم پشتیبانی یک گزارش مشتری میخواهد: برای هر مشتری دقیقاً یک ردیف، مبلغ خرید پرداختشده در بازه اخیر، تاریخ آخرین سفارش اخیر و رتبه مشتری داخل سطح پلن. نسخه اولیه SQL اجرا میشود و نامهای آشنا هم برمیگرداند؛ اما دو خطای جدی پنهان دارد. یک JOIN یکبهچند مبلغی را که قبلاً aggregate شده چندبار تکرار میکند و یک شرط در WHERE مشتریانی را که LEFT JOIN قرار بود حفظ کند حذف میکند.
در این درس SQL را مسئله «ساختن رشتهی کوئری» نمیبینیم. قبل از انتخاب JOIN، CTE، GROUP BY، تابع پنجرهای یا EXPLAIN باید grain نتیجه و cardinality رابطهها مشخص شود. بعد کوچکترین سازوکاری را انتخاب میکنیم که همان grain را حفظ کند. در پایان نیز از plan evidence استفاده میکنیم، بدون اینکه estimateهای planner یا نتیجهی یک fixture کوچک را به حکم عمومی درباره performance تبدیل کنیم.
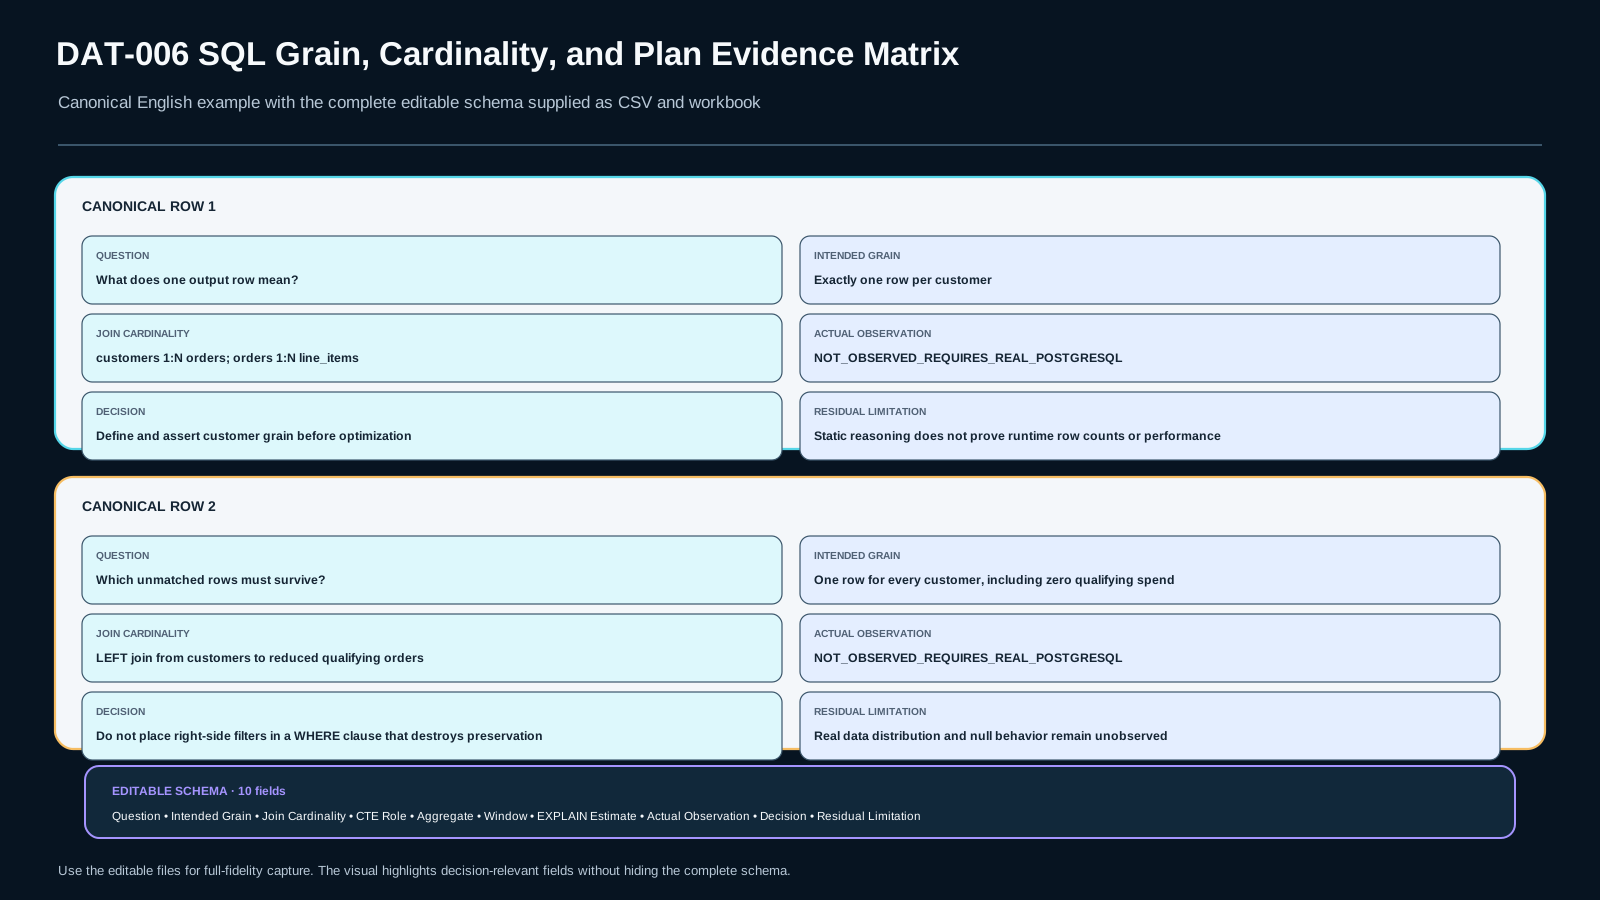
artifact اصلی شما SQL Reasoning & Plan Evidence Record v1 است. هر تصمیم مهم باید سؤال کسبوکار، grain مورد انتظار، cardinality JOIN، نقش CTE، انتخاب aggregate/window، estimate برنامه، observation واقعی در صورت وجود PostgreSQL واقعی، تصمیم محدود و یک limitation باقیمانده را به هم متصل کند.
این درس مالک transaction isolation، طراحی index در production، deployment بدون downtime یا «سریعترین کوئری جهان» نیست.
۲. مسیرها — میزان scaffold فرق میکند، سطح evidence نه
مسیر Foundation. پیش از نوشتن SQL جمله grain را بنویس: «یک ردیف برای هر مشتری». سپس customers → orders و orders → line_items را یکبهچند علامت بزن. مثال سفارش را مرحلهبهمرحله با evidence matrix جلو ببر.
مسیر Repair. از اولین dimension شکسته شروع کن. اگر مبلغ دوبرابر شده، فوراً DISTINCT اضافه نکن؛ پیدا کن کدام JOIN multiplicity را عوض کرده است. اگر مشتری ناپدید شده، شرط null-rejecting را در مرز outer join بررسی کن. فقط همان dimension را repair کن، observation را تکرار کن، بعد کل گزارش را دوباره ببند.
مسیر Experienced. مرور syntax را کوتاه کن، اما این evidenceها حذف نمیشوند: grain، مرز aggregation، تفاوت grouped aggregate و window، نقش واقعی CTE بدون ادعای optimization-fence همیشگی، و جداسازی estimate در EXPLAIN از observation در EXPLAIN ANALYZE.
در همه مسیرها transfer مستقل اجباری است. AI میتواند بعد از بیان grain و invariant، SQL پیشنهادی بدهد؛ حق ندارد خروجی PostgreSQL را جعل کند یا تصمیم accountable را بهجای learner بگیرد.
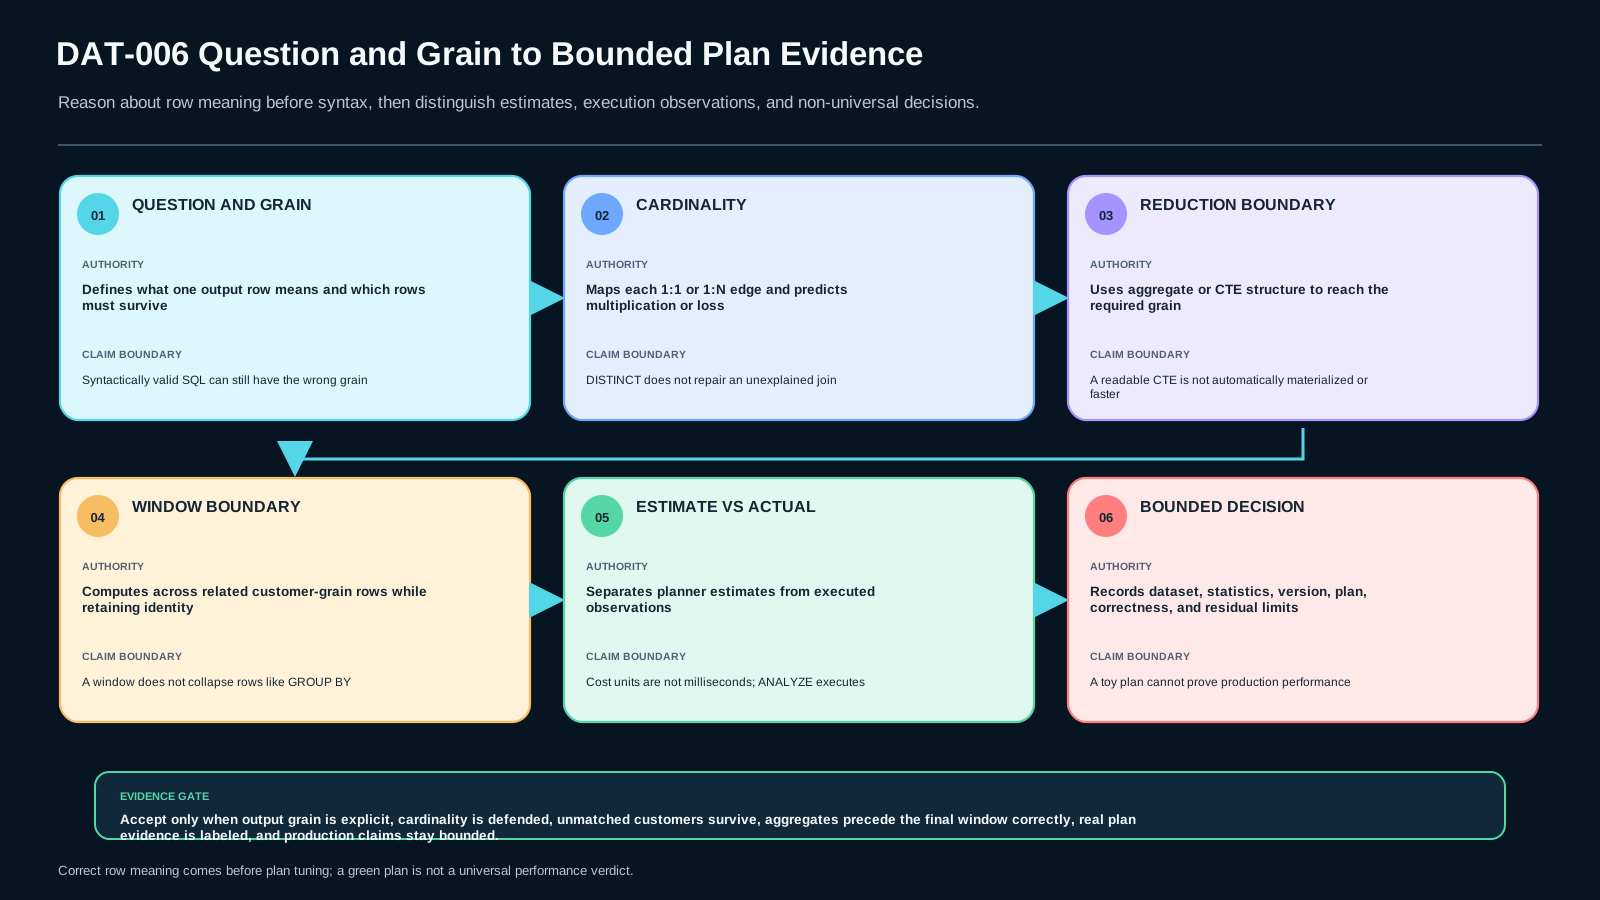
۳. مدل ذهنی — سؤال → grain → cardinality → مراحل تغییر ردیف → evidence
برای هر کوئری چندمرحلهای این زنجیره را طی کن:
- سؤال کسبوکار: یک ردیف خروجی دقیقاً نماینده چیست؟
- Result grain: صریح بنویس؛ مثلاً یک ردیف برای هر customer.
- Cardinality ورودی: هر لبه JOIN را one-to-one، one-to-many، many-to-one یا بالقوه many-to-many علامت بزن.
- قانون حفظ ردیف: مشخص کن unmatched row باید باقی بماند یا نه. این تصمیم معنای outer join را تعیین میکند.
- مرز aggregation: مشخص کن کدام many-side قبل از ترکیب با رابطهی many-side دیگر باید reduce شود.
- مرحله window: وقتی محاسبه روی مجموعهای از ردیفهای مرتبط لازم است ولی هویت ردیفها باید حفظ شود، window function مناسب است. PostgreSQL این رفتار را با
OVERتعریف میکند.[PG18-WINDOW] - نقش CTE:
WITHمیتواند مرز reasoning را روشن کند، اما CTE همیشه materialized نیست. PostgreSQL در شرایط واجد صلاحیت میتواند CTE را fold یا materialize کند.[PG18-WITH] - Plan evidence:
EXPLAINestimateهای planner را میدهد؛EXPLAIN ANALYZEstatement را اجرا میکند و آمار واقعی اجرا را اضافه میکند.[PG18-EXPLAIN] - مرز تصمیم: بنویس observation چه چیزی را پشتیبانی میکند و چه چیزی را ثابت نمیکند.
خلاصه:
business question → result grain → join cardinality → filter/group → window stage → SQL result → EXPLAIN estimate ↔ EXPLAIN ANALYZE observation → bounded decision
۴. لایه پایه — پنج تمایز کلیدی
Grain قبل از syntax
کوئری syntactically valid الزاماً سؤال درست را جواب نمیدهد. اگر خروجی باید یک ردیف برای هر مشتری باشد، هر مرحلهای که چند ردیف برای یک مشتری تولید میکند باید یا عمداً تا مرحله بعد نگه داشته شود یا پیش از projection نهایی reduce شود. مستندات PostgreSQL مراحل table expression، filtering، grouping و projection را توضیح میدهد؛ ترتیب متن SQL جای reasoning روی row set را نمیگیرد. [PG18-QUERIES]
نوع JOIN و شرط JOIN معنا هستند
INNER JOIN فقط pairهای matchشده را نگه میدارد. LEFT JOIN ردیف سمت چپ را حفظ میکند و برای نبود match ستونهای سمت راست را null میکند. اما WHERE right_table.column = ... میتواند همان null-extended row را حذف کند. سؤال اصلی «کدام JOIN سریعتر است؟» نیست؛ سؤال این است که کدام survival rule با contract گزارش همخوان است.
Aggregate ردیفها را collapse میکند؛ Window آنها را annotate میکند
GROUP BY customer_id چند ردیف را به یک ردیف grouped برای هر customer کاهش میدهد. RANK() OVER (...) روی مجموعهای از ردیفها محاسبه میکند ولی هویت ردیفها را نگه میدارد. PostgreSQL تفاوت aggregate معمولی و aggregate/window behavior را از طریق OVER مشخص میکند. [PG18-WINDOW]
CTE مرز reasoning است، نه دستور performance عمومی
میتوان مراحل «order totals → customer rollup → ranking» را با CTE واضح کرد. این برای reviewability مفید است. اما در PostgreSQL CTE واجد شرایط ممکن است fold شود و MATERIALIZED / NOT MATERIALIZED در مرزهای مستندشده بر انتخاب اثر بگذارند. [PG18-WITH] پس دو جمله «CTE همیشه optimization fence است» و «CTE همیشه inline میشود» هر دو overclaim هستند.
Cost در plan زمان میلیثانیه نیست
مقادیر cost estimateهای planner در واحدهای داخلی هزینهاند؛ زمان elapsed برحسب ms نیستند و score قابلمقایسه بین سیستمها محسوب نمیشوند. [PG18-USING-EXPLAIN] EXPLAIN ANALYZE با اجرای واقعی statement، observation قویتری برای همین fixture میدهد؛ نه proof برای production.
۵. توضیح عمیق — گزارش سفارش را مرحلهبهمرحله reasoning کن
fixture سه جدول دارد: customers، orders و line_items.
- یک customer چند order دارد.
- یک order چند line item دارد.
- هر customer باید در گزارش بماند، حتی اگر سفارش paid در بازه اخیر نداشته باشد.
- مبلغ از line item به order و سپس از order به customer جمع میشود.
- ranking باید بعد از رسیدن به grain یکردیف-برای-هر-customer انجام شود.
یک الگوی شکننده چنین است:
customers → orders → order totals از قبل aggregate شده → line_items دوباره → GROUP BY customer
اگر order دو line item داشته باشد، join مجدد همان order_total را دو بار تکرار میکند. SUM(order_total) مبلغ را دوبرابر میکند. DISTINCT روی SELECT بیرونی این arithmetic را repair نمیکند، چون multiplication پیش از projection نهایی رخ داده است.
ترتیب قویتر:
- برای هر order واجد شرایط دقیقاً یک ردیف با
order_totalبساز. - آن ردیفهای order را با
LEFT JOINبه customer وصل کن. - به grain customer aggregate کن و برای مشتری بدون order از
COALESCEاستفاده کن. - روی ردیفهای customer-level تابع rank را بهعنوان window اعمال کن.
- presentation ordering را از ranking semantics جدا نگه دار.
این به معنی اجبار «دقیقاً دو CTE» نیست. subquery معادل هم میتواند contract را حفظ کند. چیزی که باید ثابت کنی grain هر مرحله است.
شرطها در مرز outer join
این کوئری را ببین:
FROM customers c
LEFT JOIN orders o ON o.customer_id = c.id
WHERE o.status = 'paid';
مشتری بدون order در ستونهای o.* مقدار null میگیرد. شرط WHERE برای او true نیست و ردیف حذف میشود. اگر contract «همه مشتریها باقی بمانند» است، predicate سفارش واجد شرایط باید در جایی قرار بگیرد که nonmatch را نابود نکند؛ مثلاً داخل CTE/subquery سفارشهای واجد شرایط یا در ON، بسته به طراحی کامل.
Grouped aggregate در برابر window
دو سؤال متفاوت:
- «مبلغ اخیر هر مشتری چقدر است؟» → grouped reduction طبیعی است.
- «رتبه هر مشتری در tier خودش چیست؟» → window روی خروجی customer-grain طبیعی است.
اگر SUM(...) OVER (PARTITION BY customer_id) را جای grouped aggregate بگذاری ولی detail rowها باقی بمانند، شاید عدد total روی چند ردیف درست تکرار شود، اما grain هنوز غلط است. عدد درست روی ردیفهای تکراری همان contract «یک ردیف برای هر مشتری» نیست.
۶. مثال کامل — fixture محدود را repair کن
starter عمداً دو defect دارد: بعد از محاسبه order total دوباره line_items را join میکند و predicate مربوط به paid/recent order را بعد از LEFT JOIN در WHERE میگذارد.
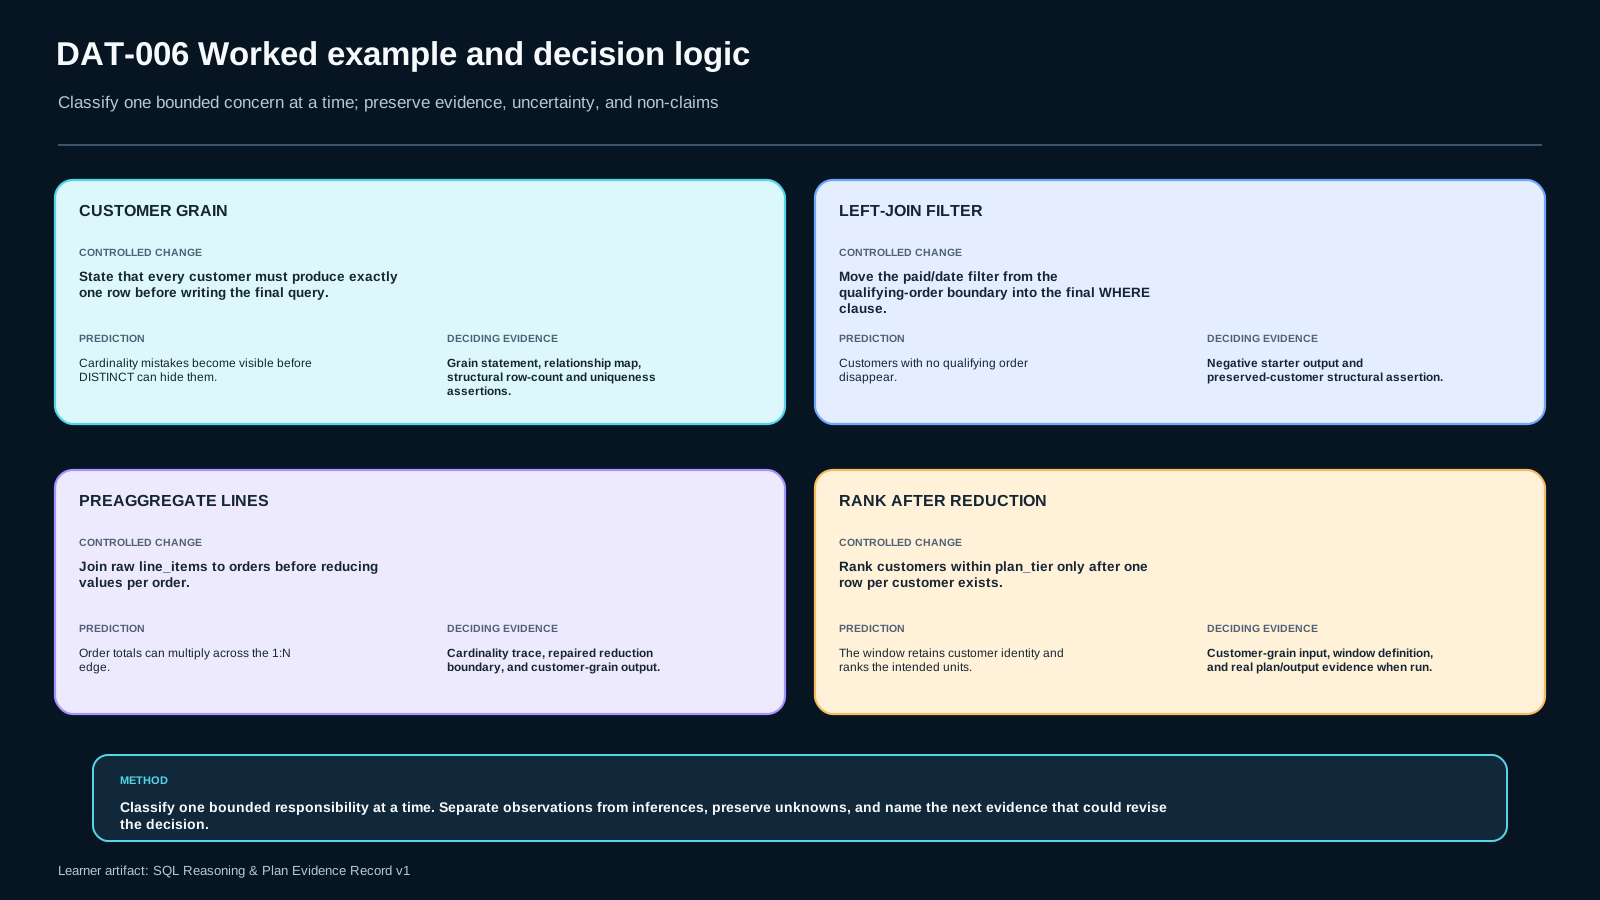
قبل از تغییر SQL در evidence record این prediction را ثبت کن:
- Intended grain: یک ردیف برای هر مشتری.
- Preservation: مشتری بدون recent paid order باید با spend صفر و latest-order خالی باقی بماند.
- Mutation signal: join یکبهچند اضافی میتواند order total محاسبهشده را چندبار تکرار کند.
در صورت داشتن PostgreSQL واقعی، starter را اجرا و خروجی واقعی را ثبت کن. expected rowهای hidden را جای observation ننویس.
repair قابلقبول میتواند یک مرحله order_totals، یک مرحله customer_rollup و سپس RANK() OVER (PARTITION BY plan_tier ORDER BY recent_spend DESC) داشته باشد. formatting مهم نیست؛ این checkpoints مهماند:
- هر order واجد شرایط دقیقاً یک بار به مبلغ کمک کند؛
- customer بدون order واجد شرایط حذف نشود؛
- پیش از ranking خروجی یک ردیف برای هر customer باشد؛
- ranking تعداد customer rowها را تغییر ندهد.
پس از semantic correctness، برای SELECT از EXPLAIN (FORMAT JSON, COSTS TRUE) و سپس EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON) استفاده کن. PostgreSQL version، estimated rows، actual rows و limitation ناشی از fixture کوچک را ثبت کن. [PG18-EXPLAIN] [PG18-USING-EXPLAIN]
۷. Failure modeها — میانبرهای قابلباور اما غلط
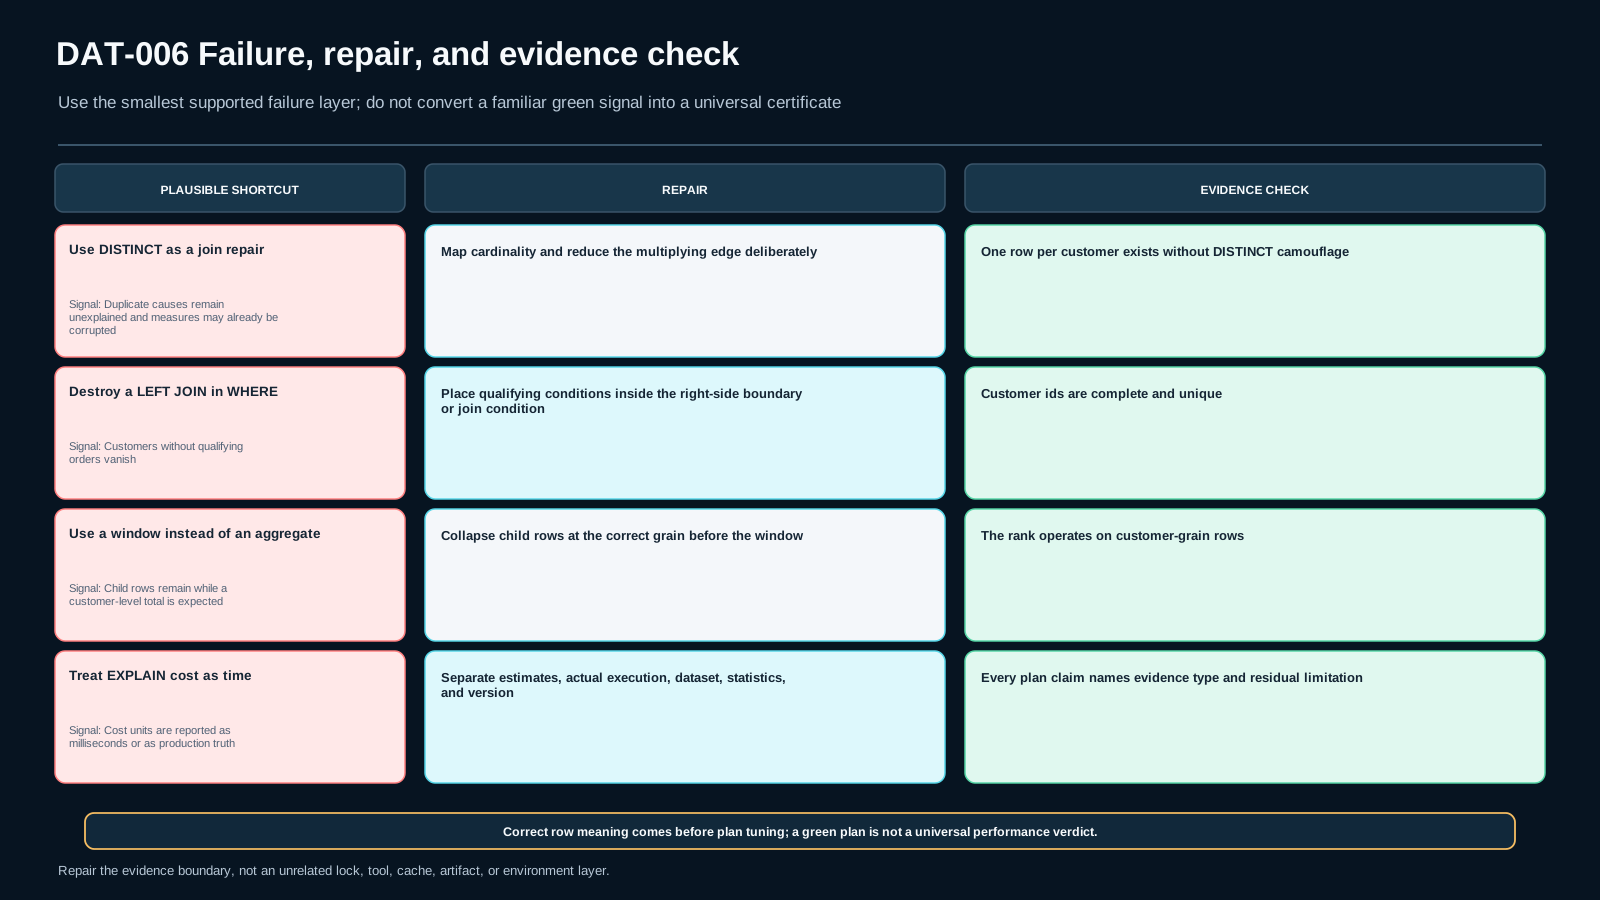
A. پنهان کردن cardinality bug با DISTINCT
اگر join مبلغ را multiply کرده باشد، DISTINCT شاید duplicate final row را حذف کند ولی sum غلط را درست نمیکند. مرز join/aggregation را repair کن.
B. انتقال filter سمت راست به WHERE
Prediction: customer بدون qualifying order حذف میشود. Observation: row count و شناسه مشتریها را مقایسه کن. Diagnosis: null-extended row در WHERE reject شده است.
C. فرض materialization فقط از روی CTE
وجود WITH proof اجرای مستقل نیست. برای همین fixture plan واقعی PostgreSQL را ببین و claim را محدود نگه دار. [PG18-WITH]
D. جایگزینی grouped aggregate با window و فراموش کردن grain
ممکن است total روی چند detail row تکرار شود. uniqueness کلید customer و row count را مستقل از correctness عدد بررسی کن.
E. فرض بیخطر بودن EXPLAIN ANALYZE برای هر statement
EXPLAIN ANALYZE statement را اجرا میکند. برای statement تغییردهندهی داده side effect واقعی ممکن است رخ دهد. مستند PostgreSQL برای inspection امن، transaction و rollback را توضیح میدهد. [PG18-EXPLAIN] evidence اصلی این درس روی SELECT است.
۸. پل Experienced — چه چیزی را میتوان کوتاه کرد؟
syntax مقدماتی قابل کوتاه شدن است؛ این پرسشها نه:
- یک ردیف خروجی چه معنایی دارد؟
- کدام join edge multiplicity را عوض میکند؟
- کدام unmatched row باید زنده بماند؟
- هر many-side در چه مرحلهای reduce میشود؟
- window روی customer-grain اجرا شده یا detail-grain را نگه داشته؟
- claim مربوط به CTE semantic است یا plan-specific؟
- عدد
EXPLAINestimate است یا observation واقعی ازEXPLAIN ANALYZE؟ - چه تفاوتی بین fixture و production باقی مانده؟
مسیر سریع tutorial را کم میکند، evidence را نه.
۹. Alternatives و trade-offها
CTE یا derived table
هر دو میتوانند مرحلهبندی reasoning را بیان کنند. CTE معمولاً مرز evidence را خواناتر میکند؛ اما correctness جایزهی استفاده از WITH نیست.
Aggregate قبل از JOIN یا بعد از JOIN
اگر join graph چند رابطه مستقل many-side دارد، pre-aggregation میتواند multiplication را حذف کند. اگر فقط یک many-side وجود دارد و هر joined row واقعاً باید در aggregate مشارکت کند، aggregate بعدی ممکن است صحیح باشد. تصمیم از grain/cardinality میآید، نه style guide ثابت.
RANK، DENSE_RANK، ROW_NUMBER
tie semantics متفاوت دارند. این lab برای reference از RANK استفاده میکند. در production باید tie semantics بهصراحت تعریف شود.
EXPLAIN یا EXPLAIN ANALYZE
اولی estimate بدون اجرا میدهد؛ دومی statement را اجرا و actual statistics اضافه میکند. evidence قویتر است اما هزینه و در statementهای تغییردهنده side effect دارد. [PG18-EXPLAIN]
۱۰. تمرین guided و independent
Guided
learner/sql/starter_broken.sqlوlearner/model-contract.jsonرا بخوان.- grain را قبل از edit بنویس.
- پیشبینی کن کدام customer با predicate در
WHEREحذف میشود. - پیشبینی کن کدام مبلغ با join اضافی multiply میشود.
learner/sql/query.sqlرا بدون دسترسی به solution داخلی تکمیل کن.python src/static_preflight.pyرا اجرا کن.- روی PostgreSQL disposable،
MAKNOW_DATABASE_URLوMAKNOW_DAT006_DISPOSABLE_CONFIRM=YESرا تنظیم وpython src/run_postgres.pyرا اجرا کن. runner از schema تصادفی و ایزوله استفاده میکند و SQL غیر read-only یا چند-دستوری learner را قبل از اجرا رد میکند. - فقط observation واقعی را در evidence record وارد کن.
Independent
دامنه را به organization و support ticket تغییر بده. خروجی باید یک ردیف برای هر organization، latest ticket information و رتبه در plan tier داشته باشد. grain، cardinality، reduction stage و window stage را مستقل استخراج کن. SQL سفارش را مکانیکی کپی نکن.
۱۱. Verification و evidence
record کامل حداقل شامل موارد زیر است:
- business question و intended grain؛
- cardinality هر رابطه؛
- نقش CTE/subquery؛
- aggregate و window choice؛
- positive observation از query repaired؛
- negative observation از یک mutation؛
- repair result؛
- estimate از
EXPLAIN؛ - actual evidence از
EXPLAIN ANALYZEدر صورت وجود runtime واقعی و safe execution؛ - PostgreSQL version؛
- transfer decision؛
- residual limitation.
هر گزاره را observation، inference یا design decision علامت بزن. «fixture چهار customer row برگرداند» فقط وقتی observation است که واقعاً اجرا شده باشد. «پس روی صد میلیون ردیف سریع است» از این fixture نتیجه نمیشود. plan به data distribution، statistics، parameters، configuration و version وابسته است. [PG18-USING-EXPLAIN]
۱۲. Assessment و transfer
باید پنج نوع task را بتوانی انجام دهی:
- Retrieval: contract grain و یک non-goal را بیان کن.
- Application: گزارش سفارش را repair و evidence تولید کن.
- Diagnosis: یک mutation مربوط به cardinality/filter/window را predict، observe و repair کن.
- Decision: شکل SQL را در برابر alternative دفاع کن، بدون ادعای performance عمومی.
- Transfer: مسئله organization/ticket را مستقل حل کن.
قبولی به formatting خاص وابسته نیست؛ حفظ contract محدود و evidence traceable معیار است.
۱۳. References و freshness boundary
Source boundary فقط PostgreSQL رسمی است:
[PG18-QUERIES]— query/table expression، grouping و ساختار query در PostgreSQL 18.[PG18-WINDOW]— window functions و semantics مربوط بهOVER.[PG18-WITH]— مرزهای folding/materialization درWITH/CTE.[PG18-EXPLAIN]— رفتارEXPLAINوANALYZEو هشدار اجرای واقعی statement.[PG18-USING-EXPLAIN]— تفسیر estimate، cost، actual row و محدودیت تعمیم plan.
authority frozen در 2026-09-02 بازیابی شده است. claimهای tool-volatile تا 2026-10-17 و claimهای practice-evolving تا 2026-12-31 review_due دارند. authoring فعلی قبل از این تاریخهاست و source boundary را گسترش نمیدهد.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
DAT-006-S1 retrieval
State the intended row grain for the order-report lab and name one claim this lesson explicitly does not prove.
DAT-006-S2 application
Repair the bounded customer report so every customer is represented once, recent paid spend is not multiplied, latest recent order is preserved, and tier rank is computed at customer grain. Record real evidence.
DAT-006-S3 diagnosis
Predict and diagnose one mutation: redundant many-side join, outer-join filter moved to WHERE, grouped aggregate replaced by a window, or another supplied bounded mutation. Show the observed failure and repair.
DAT-006-S4 decision
Defend your CTE/subquery and aggregate/window boundaries against one plausible alternative. Separate semantic correctness from plan/performance inference.
DAT-006-S5 transfer
For organizations and support tickets, derive one-row-per-organization grain, latest-ticket information, and rank within plan tier independently. Provide the reasoning record without copying the order-report SQL.
ملاکهای ارزیابی (rubric)
Critical dimensions:
- Contract correctness: output grain and row-survival semantics match the bounded question.
- Evidence quality: predictions, real observations, mutation and repair are traceable; no fabricated PostgreSQL output.
- Scope discipline: CTE, EXPLAIN and fixture evidence are not generalized into universal performance or production-safety claims.
- Transfer independence: the organizations/tickets case is re-derived rather than copied.
Blocking failure: wrong customer grain, missing negative/mutation evidence, fabricated runtime observation, or decisive scaffold in the transfer.
منابع و تازگی
مطالعهٔ موارد (case studies)
فایلهای آزمایشگاه
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)