مهندسی سامانههای هوش مصنوعی · فصل ۴ — Model Artifacts، Transfer، License، Scheduler و Device Telemetry · 148
Device Telemetry برای GPU/Media Workloads
میتواند مدل یا ابزار AI را فراخوانی کند اما contract، qualification، routing، cost، trust و failure را کنترل نمیکند. موضوع جاری: «Device Telemetry برای GPU/Media Workloads». میتواند «Device Telemetry برای GPU/Media Workloads» را در یک workflow AI محدود طراحی کند و validation، authority، cost یا failure controls مرتبط را مشخص کند.
خلاصهٔ درس
میتواند مدل یا ابزار AI را فراخوانی کند اما contract، qualification، routing، cost، trust و failure را کنترل نمیکند. موضوع جاری: «Device Telemetry برای GPU/Media Workloads».
میتواند «Device Telemetry برای GPU/Media Workloads» را در یک workflow AI محدود طراحی کند و validation، authority، cost یا failure controls مرتبط را مشخص کند.
خروجی این درس
میتواند «Device Telemetry برای GPU/Media Workloads» را در یک workflow AI محدود طراحی کند و validation، authority، cost یا failure controls مرتبط را مشخص کند.
1. مسئله واقعی: utilization پایین، «GPU سالم» را ثابت نمیکند
فرض کنید N-GPU-2/GPU-0 فقط ۳۸٪ utilization دارد؛ در نگاه اول ممکن است از یک GPU با utilization برابر ۹۱٪ «سالمتر» یا «آزادتر» به نظر برسد. اما همین device میتواند ۹۵٪ framebuffer را مصرف کرده باشد، دمایش نزدیک مرز هشدار باشد و یک XID اخیر داشته باشد. برعکس، GPU دوم ممکن است با utilization بالا کاملاً در محدودهٔ سالم دما، حافظه و خطا کار کند. بنابراین artifact مالک این درس GPU/Media Device Telemetry Health & Scheduling Signal Record v1 است: یک قرارداد evidence که metricها را دقیق ثبت میکند و از تبدیل یک درصد ساده به حکم سلامت جلوگیری میکند.
2. مرز درس: telemetry evidence میسازیم، scheduler و remediation را مالک نمیشویم
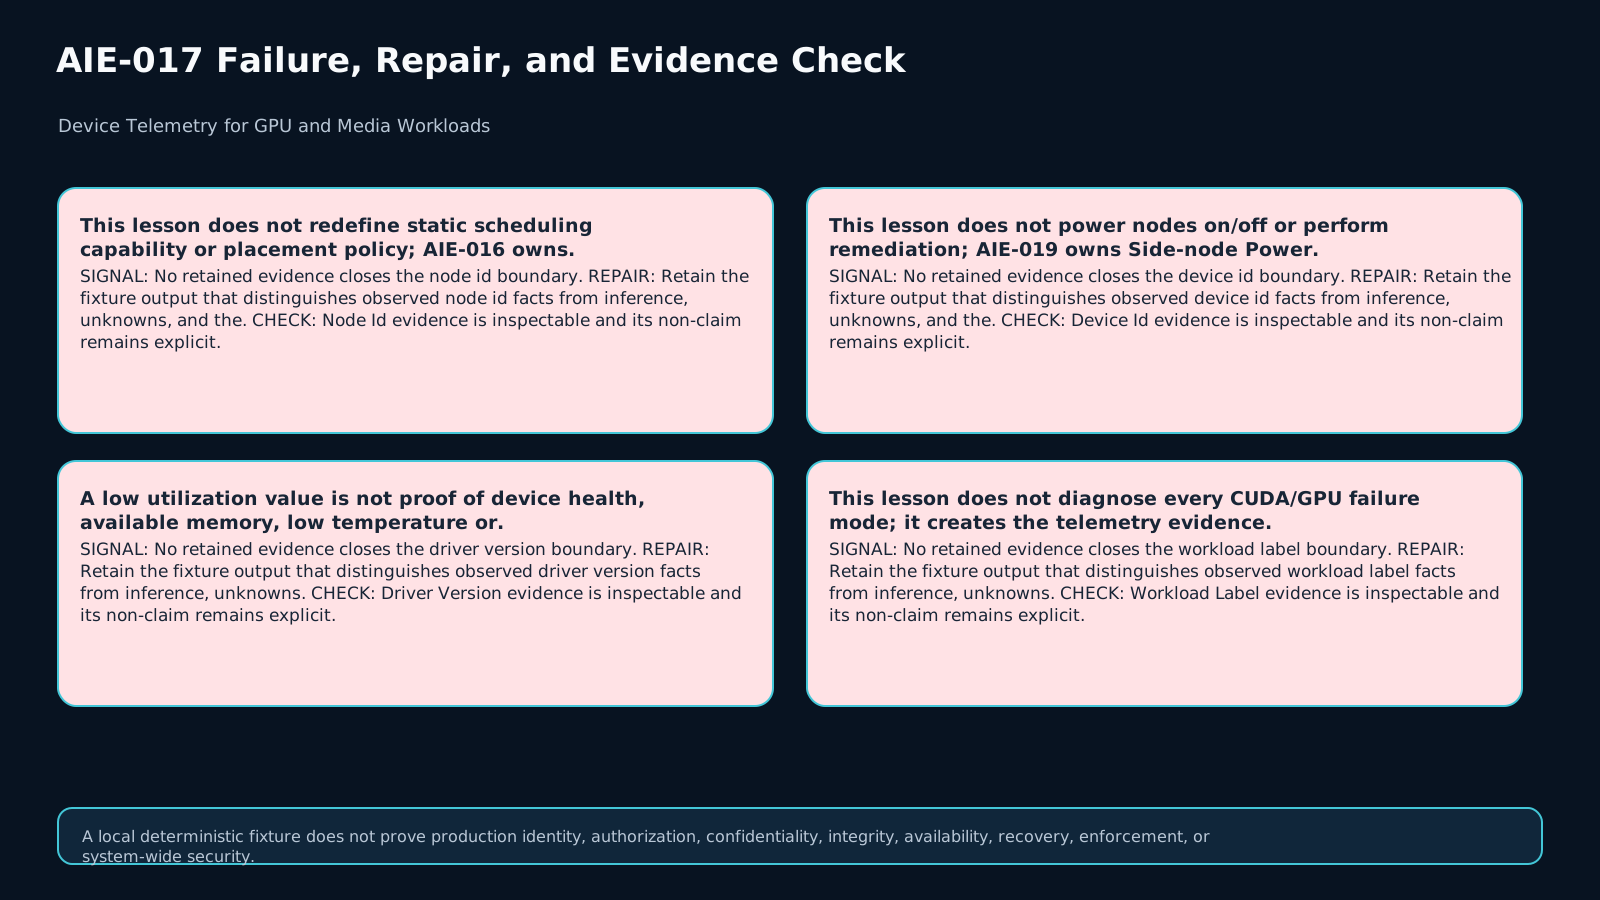
AIE-017 مسئول collection contract، freshness، availability، provenance و derived telemetry state است. این درس تعیین نمیکند node از نظر static capability برای workload مناسب است؛ آن مرز متعلق به AIE-016 است. همچنین هیچ node را روشن/خاموش نمیکند و action اصلاحی خودکار انجام نمیدهد؛ AIE-019 مالک power orchestration است. خروجی این درس فقط signal محدود و versioned برای scheduler/operations است؛ مصرفکنندهٔ پاییندستی باید همچنان policy خودش را صریح نگه دارد.
3. هر sample باید هویت، واحد، زمان و window داشته باشد
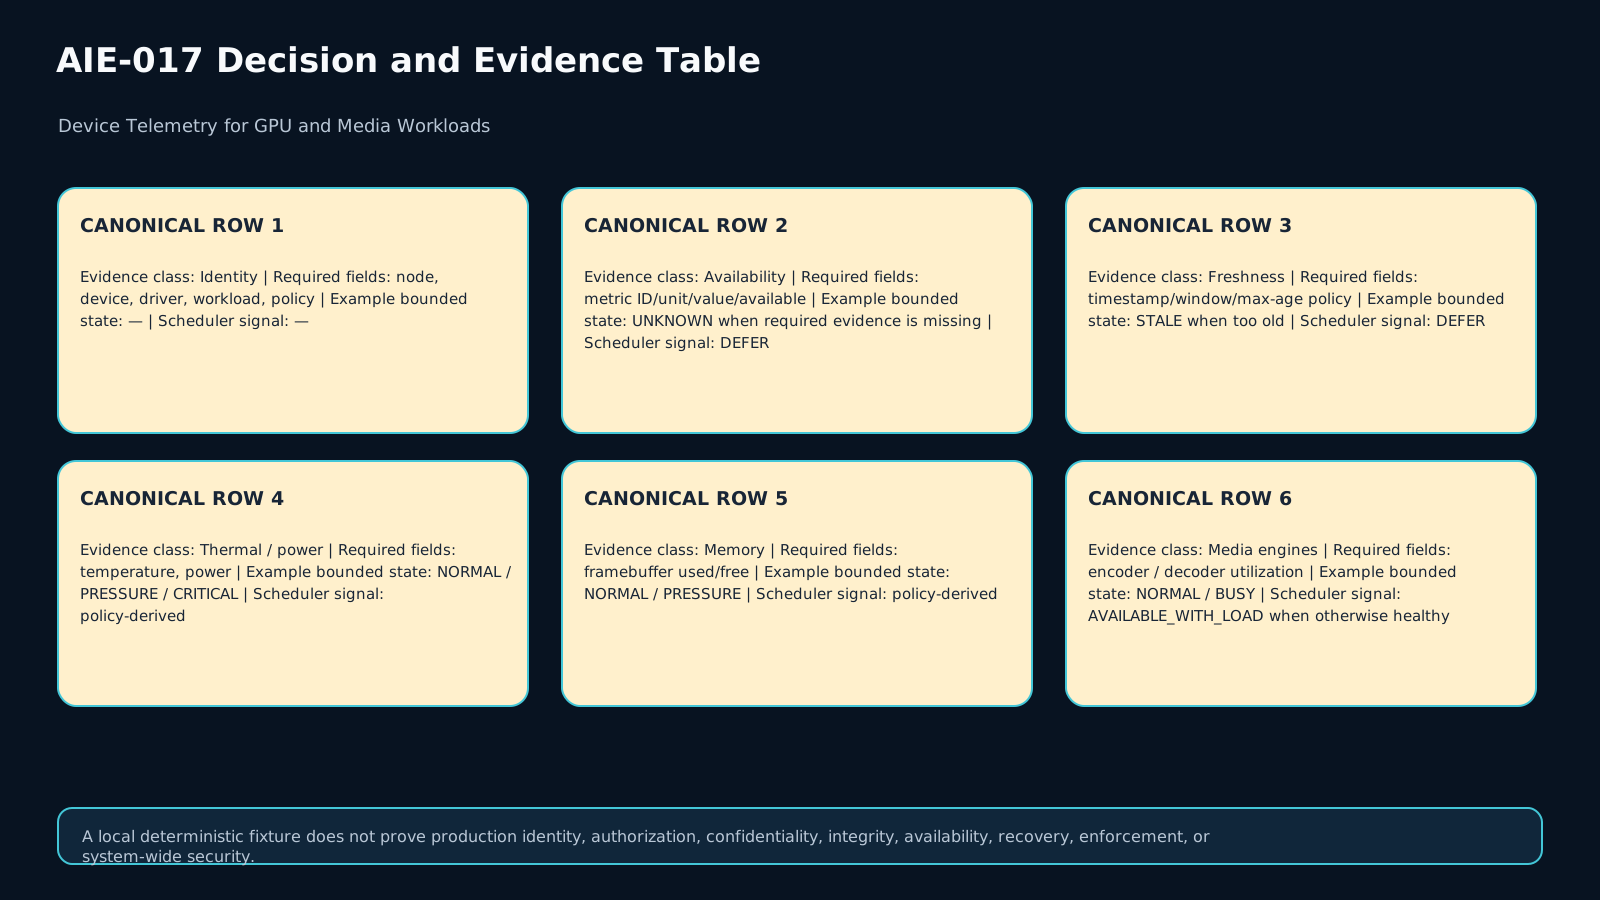
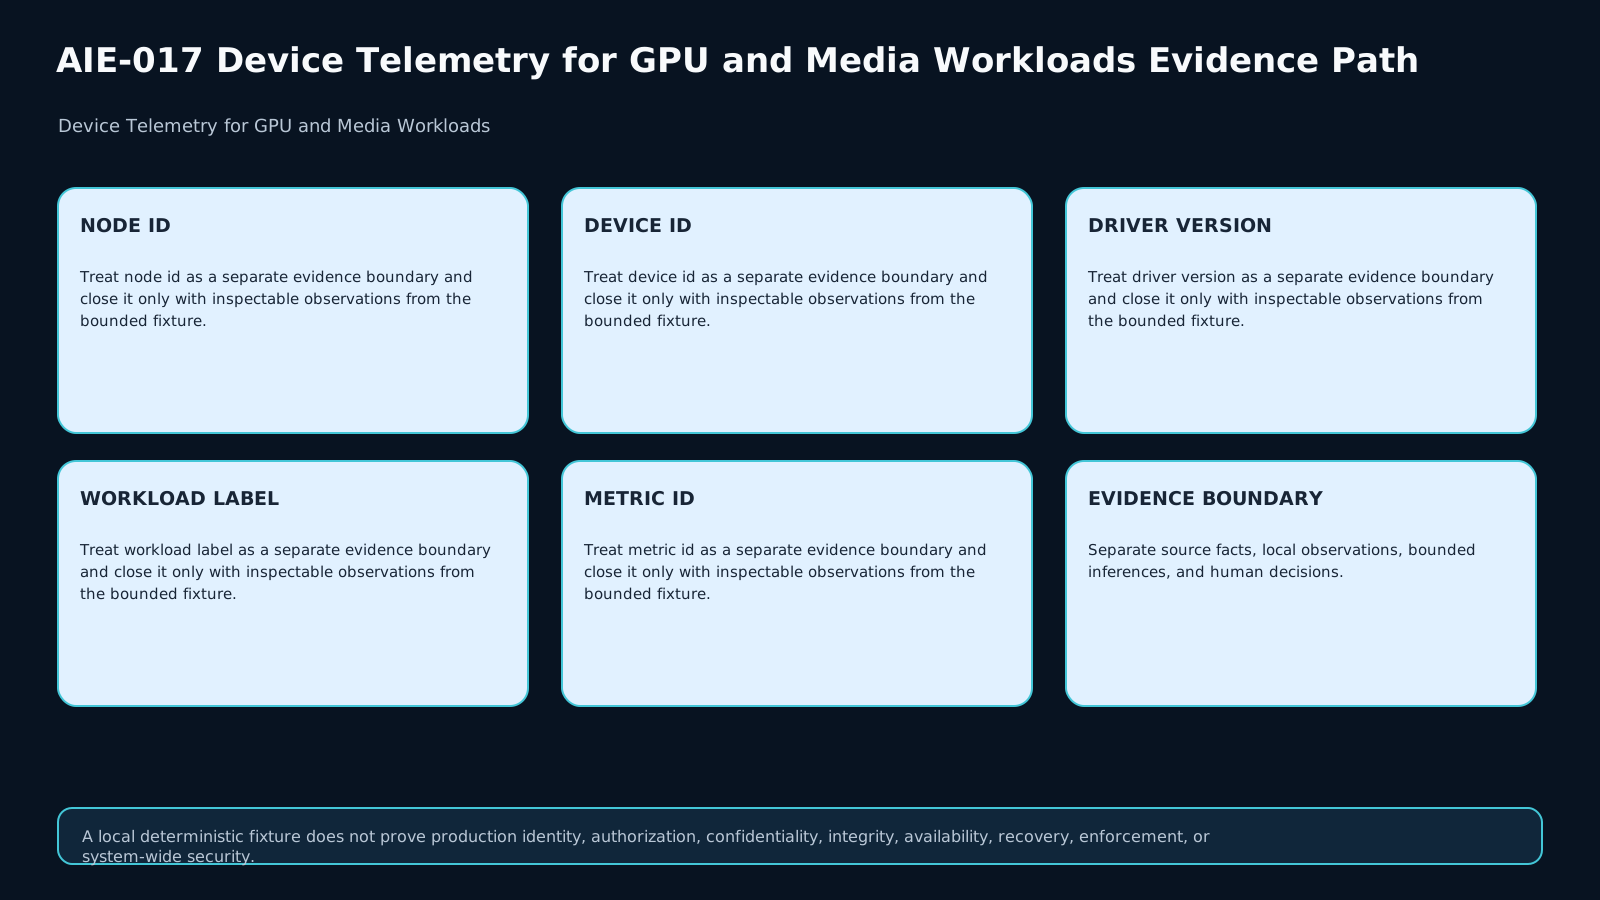
یک عدد بدون contract تقریباً غیرقابل ممیزی است. حداقل برای هر sample باید node_id، device_id، driver_version، workload_label، metric_id، metric_unit، sample_timestamp، sample_window، metric_value، metric_available و provenance ثبت شود. اگر metric از یک exporter یا collector خاص میآید، نسخه/پیکربندی همان collector نیز باید قابل ردیابی باشد. در این درس «۵۰» فقط وقتی معنا دارد که بدانیم مثلاً DCGM_FI_DEV_GPU_TEMP با واحد درجهٔ سلسیوس و timestamp مشخص است.
4. سطح فعلی DCGM Exporter گسترده است، اما policy شما نیست
مستندات جاری NVIDIA برای DCGM Exporter در collector پیشفرض metricهایی مانند GPU temperature، board power، total energy، PCIe RX/TX، GPU utilization، encoder/decoder utilization، framebuffer free/used و XID error را نشان میدهد. این فهرست یک surface ابزار است، نه تعریف «health» محصول شما. MAKNOW باید metric identity و semantics را ثبت کند و سپس policy versioned خودش را برای تبدیل evidence به state بهکار ببرد؛ vendor metric بهتنهایی مجوز HEALTHY، PLACE یا remediation نیست.
5. configured metric با emitted metric یکی نیست: UNKNOWN را حفظ کنید
خود NVIDIA صریح میگوید فعالبودن یک row در collector تضمین نمیکند آن field روی یک سیستم خاص emit شود؛ GPU، driver، DCGM، entity support، permission و deployment configuration روی availability اثر دارند. بنابراین غیبت metric را صفر تفسیر نکنید. اگر temperature بعد از تغییر collector ناپدید شد، temperature=0 یا «آخرین مقدار سالم» جعل evidence است؛ state درست UNKNOWN/UNAVAILABLE است تا collection یا mapping دوباره qualification شود.
6. collection cadence، scrape cadence و freshness سه مفهوم جدا هستند
DCGM Exporter metricهای انتخابشده را watch میکند و از /metrics در فرمت Prometheus ارائه میدهد؛ --collect-interval cadence پیشفرض watch را کنترل میکند و labelهای workload نیز میتوانند اضافه شوند. اما scrape کردن endpoint لزوماً hardware sample تازه تولید نمیکند. در قرارداد MAKNOW باید sample_timestamp/window و freshness_state بر اساس policy خودتان محاسبه شوند. اگر آخرین sample از max_age عبور کرده، حتی اگر endpoint هنوز عددی نشان دهد، evidence باید STALE شود.
7. utilization را از capacity، pressure و health جدا نگه دارید
GPU utilization عمدتاً نشان میدهد چه مقدار از engine/SM در window مربوط فعال بوده است؛ نمیگوید چقدر framebuffer آزاد است، دما چقدر است، power limit زده شده یا خطای device رخ داده است. یک scheduler ممکن است از utilization برای load-awareness استفاده کند، ولی health signal باید چندبعدی باشد. shortcut «utilization کمتر = سالمتر» در Lab عمداً شکست میخورد: device با ۳۸٪ utilization بهعلت memory/thermal/error evidence DEGRADED میشود، در حالی که device ۹۱٪ میتواند BUSY_BUT_HEALTHY باشد.
8. framebuffer memory pressure را مستقل بسنجید
برای workloadهای AI و media، framebuffer نزدیک saturation میتواند allocation failure، eviction/churn یا عدم امکان شروع workload بعدی را ایجاد کند حتی اگر GPU utilization پایین باشد. قرارداد باید used/free یا یک نسبت محاسبهشده را با unit و policy threshold ثبت کند. threshold یک حقیقت جهانی NVIDIA نیست؛ تصمیم طراحی MAKNOW است و باید با policy_version همراه باشد. اگر metric memory unavailable یا stale باشد، state memory باید UNKNOWN/STALE بماند.
9. thermal و power pressure را با threshold versioned و evidence تازه مدل کنید
Temperature و board power برای تشخیص pressure مهماند، اما thresholdهای warning/critical باید در policy خود محصول تعریف و version شوند. در fixture این درس، رسیدن به warning باعث DEGRADED و عبور از critical thermal/power باعث QUARANTINED/UNSCHEDULABLE میشود. این thresholdها نمونهٔ synthetic آموزشیاند و نباید بهعنوان حد رسمی یک GPU واقعی منتشر شوند. شرط مهمتر این است که value، unit، timestamp و policy version همزمان قابل ممیزی باشند.
10. media engineها را فراموش نکنید: encoder/decoder saturation میتواند bottleneck اصلی باشد
در pipelineهای ویدئو، GPU core utilization ممکن است متوسط باشد ولی NVENC/NVDEC یا engine متناظر نزدیک saturation باشد. DCGM Exporter metricهای encoder و decoder utilization را در surface جاری خود دارد. بنابراین record باید encoder_utilization و decoder_utilization را در کنار GPU utilization نگه دارد. در policy synthetic این درس، media-engine saturation بدون error/thermal pressure به BUSY_BUT_HEALTHY منجر میشود: device سالم است، اما scheduler باید load موجود را ببیند.
11. XID/ECC/health evidence را به utilization تقلیل ندهید
خطاهای device مانند XID یا ECC evidence یک لایهٔ متفاوت از load هستند. یک XID اخیر میتواند نیازمند investigation باشد حتی وقتی utilization پایین آمده است. در این درس، presence یک XID در window synthetic باعث DEGRADED و ops_signal=INVESTIGATE میشود؛ اگر policy واقعی برخی errorها را critical بداند میتواند quarantine را فعال کند، اما این mapping باید explicit و versioned باشد. «utilization صفر شد، پس مشکل حل شد» claim قابل قبول نیست.
12. derived state باید deterministic، versioned و ضعیفتر یا مساوی evidence باشد
ترتیب پیشنهادی این Lab چنین است: اگر metricهای ضروری unavailable باشند → UNKNOWN; اگر available ولی stale باشند → STALE; اگر thermal/power critical باشد → QUARANTINED; اگر error incident یا memory/thermal warning باشد → DEGRADED; اگر health evidence سالم است ولی GPU/media load بالاست → BUSY_BUT_HEALTHY; در غیر این صورت → HEALTHY. این یک policy synthetic قابل تست است، نه استاندارد vendor. هر derived state باید به exact telemetry_policy_version و sampleهای ورودی trace شود.
13. scheduler signal و ops signal را جدا صادر کنید
یک signal برای placement و یک signal برای عملیات، هدفهای متفاوت دارند. در Lab، HEALTHY → AVAILABLE، BUSY_BUT_HEALTHY → AVAILABLE_WITH_LOAD، DEGRADED/UNKNOWN/STALE → DEFER و QUARANTINED → UNSCHEDULABLE میشود. همزمان ops signal میتواند NONE، OBSERVE_LOAD، INVESTIGATE، CHECK_COLLECTOR، REFRESH_TELEMETRY یا QUARANTINE باشد. این signalها authority برای خاموشکردن node یا تعمیر خودکار نیستند؛ فقط evidence محدود و auditable برای سیستمهای دیگرند.
14. مثالها و ضدنمونههای تصمیم
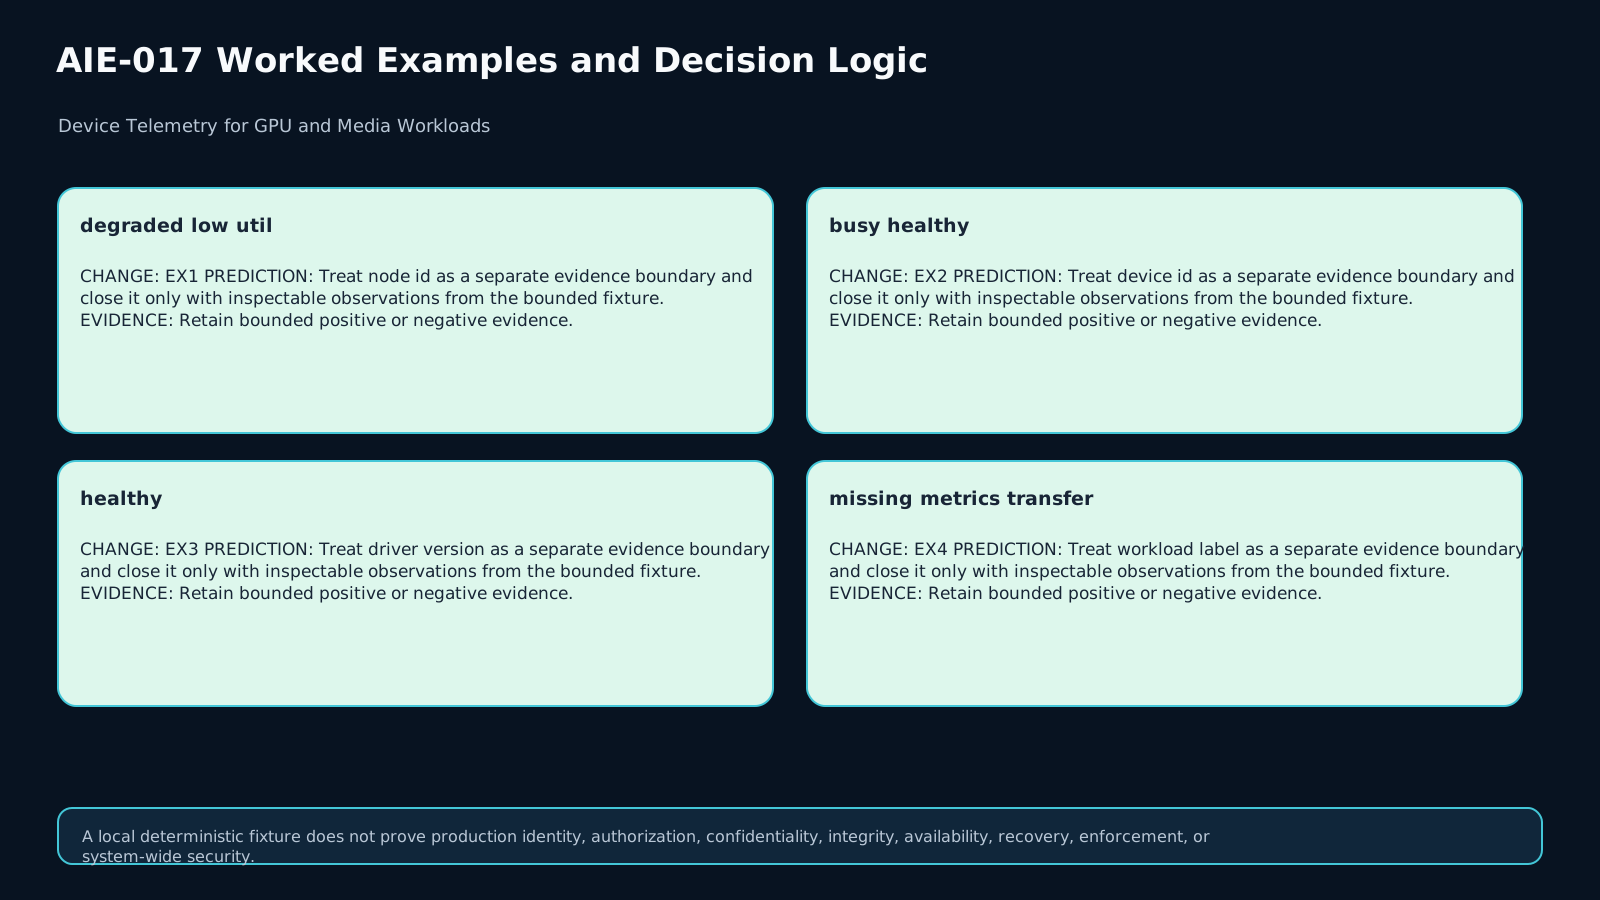
Case 1: utilization=38٪، framebuffer=95٪، temp در warning و XID اخیر → DEGRADED/DEFER/INVESTIGATE. Case 2: utilization=91٪، memory/thermal/error سالم → BUSY_BUT_HEALTHY/AVAILABLE_WITH_LOAD. Case 3: همهٔ evidence سالم و load پایین → HEALTHY/AVAILABLE. Case 4: temperature و power بعد از collector change ناپدید میشوند → UNKNOWN/DEFER/CHECK_COLLECTOR، نه استفاده از آخرین مقدار. Case 5: temperature موجود ولی قدیمی است → STALE/DEFER. Case 7: thermal critical synthetic → QUARANTINED/UNSCHEDULABLE.
15. Transfer و چکلیست نهایی
Transfer اصلی دقیقاً همان failure واقعی این درس است: collector تغییر میکند، utilization همچنان میآید ولی temperature و power دیگر emit نمیشوند. record را از صفر با evidence جدید بسازید؛ missing metrics را UNKNOWN کنید و تصمیم قبلی را copy نکنید. چکلیست: device/workload identity ثبت؟ unit و metric ID دقیق؟ sample time/window ثبت؟ availability جدا از value؟ freshness policy versioned؟ utilization از memory/thermal/power/media/error جدا؟ missing≠zero؟ derived state deterministic؟ scheduler و ops signal جدا؟ provenance و recheck trigger موجود؟ و هیچ remediation خودکار از telemetry تنها صادر نشده است؟
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
Q1
Why can a GPU at 38% utilization be a worse scheduling choice than one at 91%?
Q2
Temperature disappears after a collector change while utilization still arrives. What is the correct telemetry state?
Q3
How do collection cadence, Prometheus scrape cadence and freshness differ?
Q4
Why must scheduler_signal and ops_signal remain separate?
ملاکهای ارزیابی (rubric)
A passing response must:
- Bind exact node/device/driver/workload and telemetry-policy identity.
- Preserve metric ID, unit, sample time/window, availability, freshness, and provenance.
- Separate utilization from framebuffer, thermal, power, media-engine, and error/health evidence.
- Treat missing metric evidence as
UNKNOWN/UNAVAILABLE, never as zero or healthy. - Treat over-age evidence as
STALEeven if the exporter still exposes a cached value. - Apply a deterministic versioned policy whose decision is no stronger than evidence.
- Distinguish
HEALTHY,BUSY_BUT_HEALTHY,DEGRADED,UNKNOWN,STALE, andQUARANTINEDstates. - Emit bounded scheduler and operations signals separately and avoid autonomous remediation claims.
- Rebuild the record after collector/configuration changes rather than copying the prior decision.
منابع و تازگی
مطالعهٔ موارد (case studies)
تصاویر درس
فایلهای آزمایشگاه
Implement evaluate_telemetry(case) in starter.py. Build a typed decision from the supplied synthetic metrics. Missing evidence is UNKNOWN, over-age evidence is STALE, and low GPU utilization must never override memory, thermal, power, media-engine, or XID/error evidence.
Your result should preserve the bounded derived state plus separate scheduler and operations signals. The synthetic policy and thresholds exist only for this lab; they are not NVIDIA hardware limits. Run python run_checks.py to verify the fixture structure. Hidden evaluation checks deterministic outcomes.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)