مهندسی سامانههای هوش مصنوعی · فصل ۴ — Model Artifacts، Transfer، License، Scheduler و Device Telemetry · 149
Side-node Power Orchestration
میتواند مدل یا ابزار AI را فراخوانی کند اما contract، qualification، routing، cost، trust و failure را کنترل نمیکند. موضوع جاری: «Side-node Power Orchestration». میتواند «Side-node Power Orchestration» را در یک workflow AI محدود طراحی کند و validation، authority، cost یا failure controls مرتبط را مشخص کند.
خلاصهٔ درس
میتواند مدل یا ابزار AI را فراخوانی کند اما contract، qualification، routing، cost، trust و failure را کنترل نمیکند. موضوع جاری: «Side-node Power Orchestration».
میتواند «Side-node Power Orchestration» را در یک workflow AI محدود طراحی کند و validation، authority، cost یا failure controls مرتبط را مشخص کند.
خروجی این درس
میتواند «Side-node Power Orchestration» را در یک workflow AI محدود طراحی کند و validation، authority، cost یا failure controls مرتبط را مشخص کند.
1. مسئله واقعی: «idle است» به معنی «میتوان خاموشش کرد» نیست
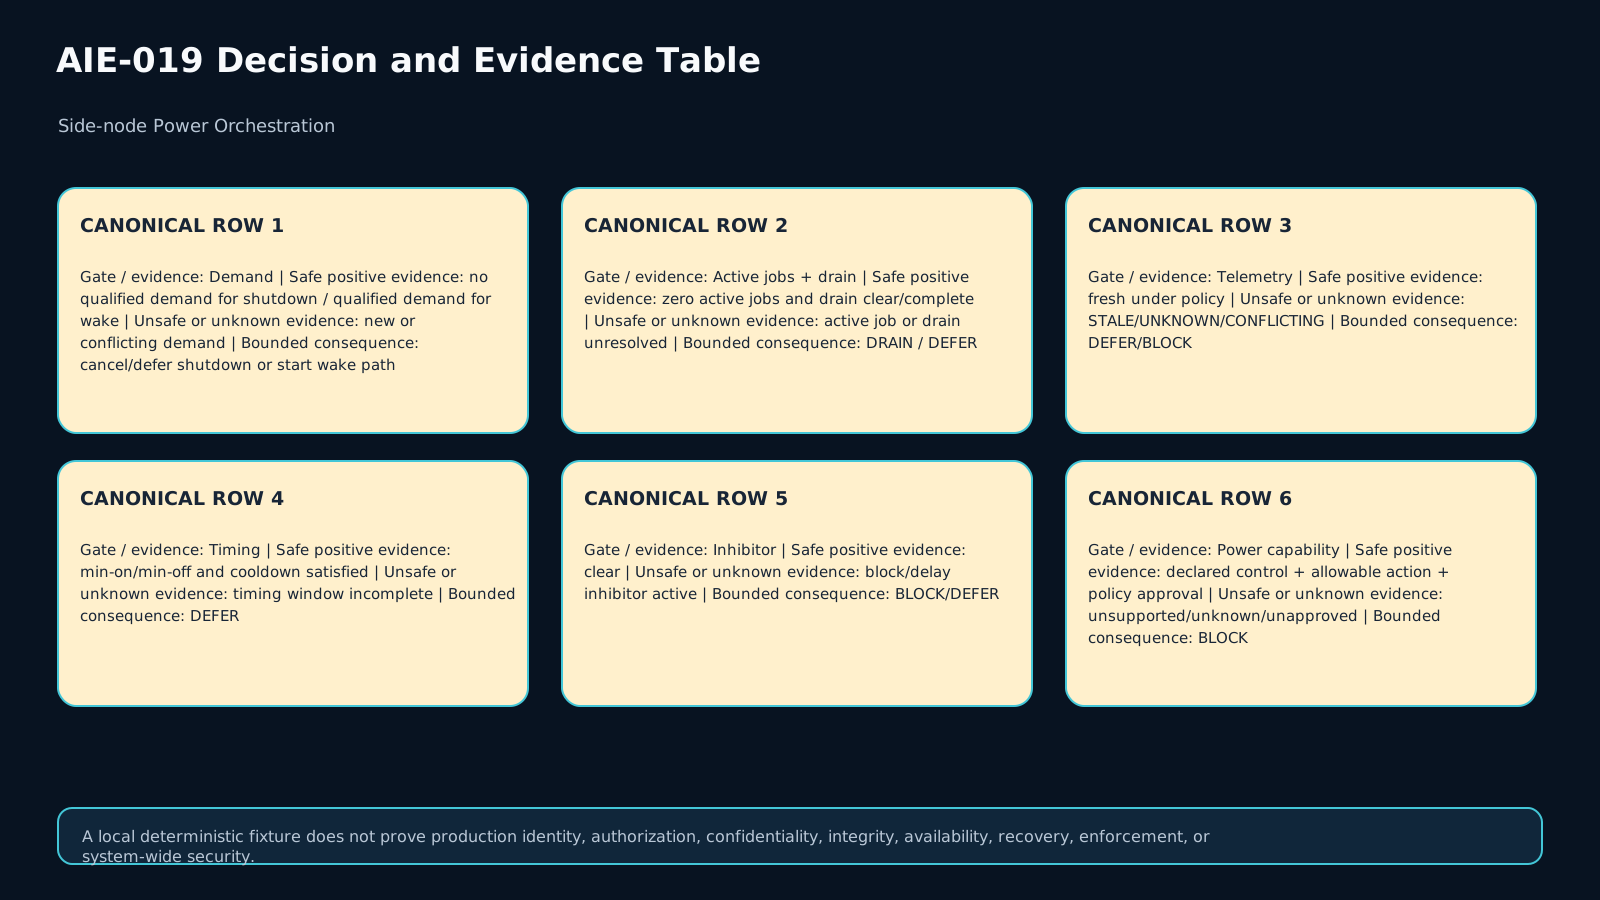
فرض کنید N-GPU-2 در وضعیت ON_IDLE است. فعلاً job فعالی ندارد، ۲۵ دقیقه از idle شدنش گذشته و هزینهٔ برق و استهلاک باعث میشود خاموشکردن آن جذاب باشد. تصمیم خطرناک این است که فقط با همین timer فرمان power-off بدهیم. بین «الان بیکار است» و «خاموشکردن امن است» چند سؤال مستقل وجود دارد: آیا demand جدیدی وارد شده؟ آیا drain واقعاً کامل است؟ telemetry تازه است؟ minimum-on و cooldown تمام شده؟ inhibitor فعالی وجود ندارد؟ کنترل power واقعاً پشتیبانی میشود؟ و اگر درخواست shutdown پذیرفته شد، آیا host واقعاً OFF شده؟ artifact مالک این درس Side-node Power Orchestration State Machine & Safety Record v1 است.
2. مرز درس: scheduler و telemetry را مصرف میکنیم، مالک آنها نمیشویم
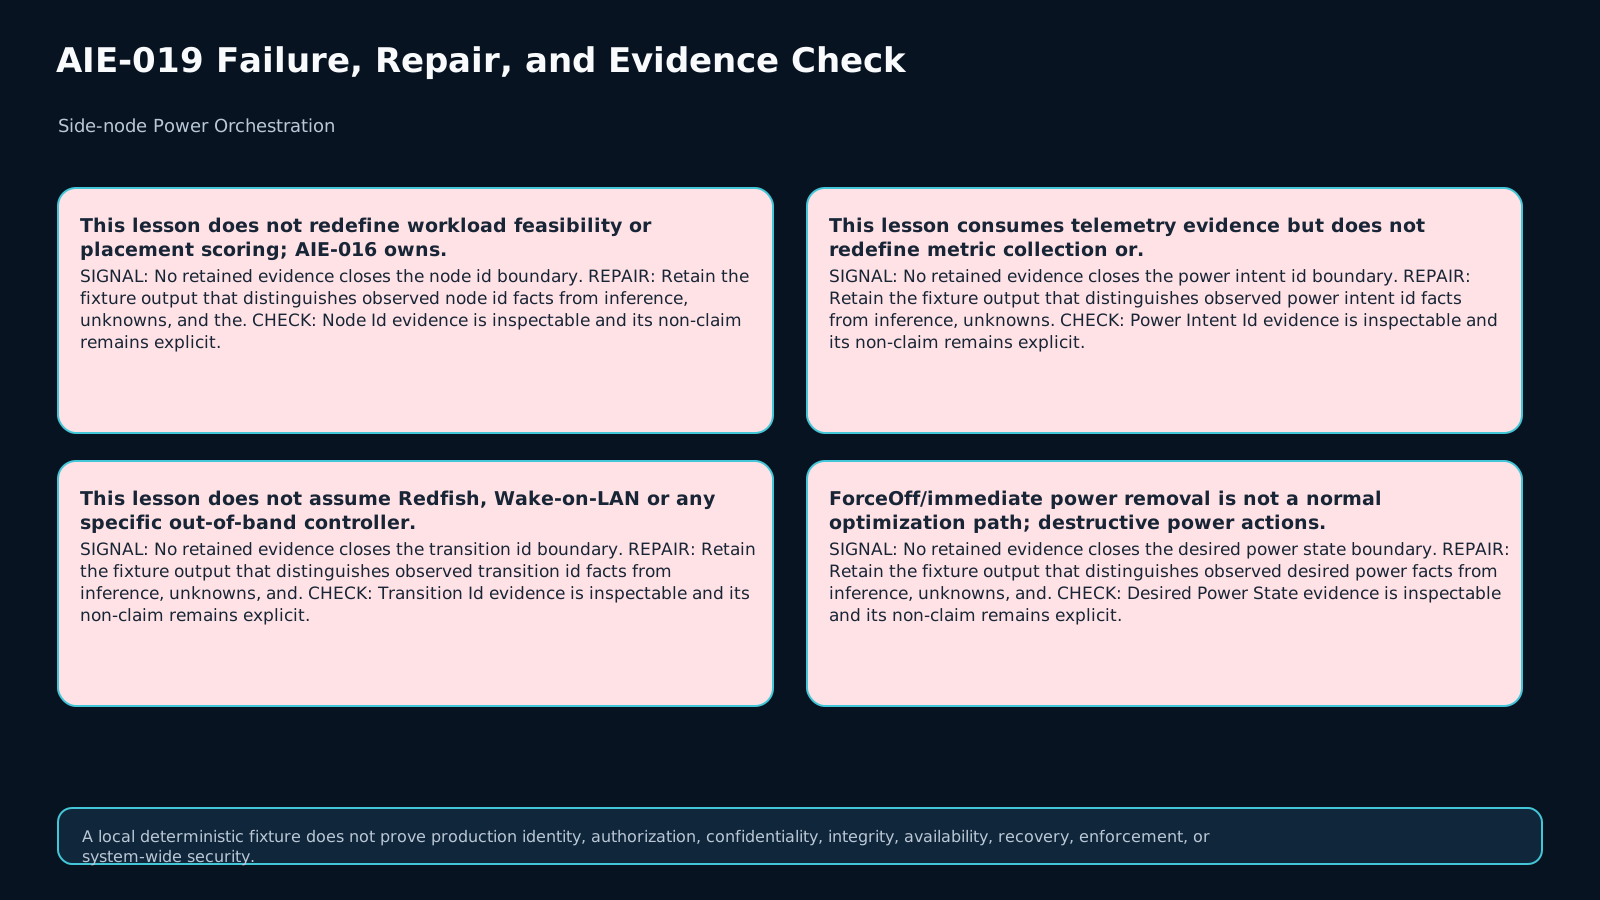
AIE-019 دربارهٔ سیاست و evidence انتقال power state است. نتیجهٔ capability/placement از scheduler میآید و freshness/health evidence از telemetry؛ این درس آن دو را بازطراحی نمیکند. وظیفهٔ power orchestrator این است که ورودیهای versioned را به یک intent محدود تبدیل کند، admission را در لحظهٔ مناسب ببندد، transition را request کند، observed state را دوباره بررسی کند و فقط وقتی readiness ثابت شد اجازهٔ استفادهٔ بعدی بدهد. طراحی سختافزار، BMC، PSU و firmware خارج از مرز درس است.
3. سه مفهوم را هرگز یکی نکنید: desired state، observed state و runtime readiness
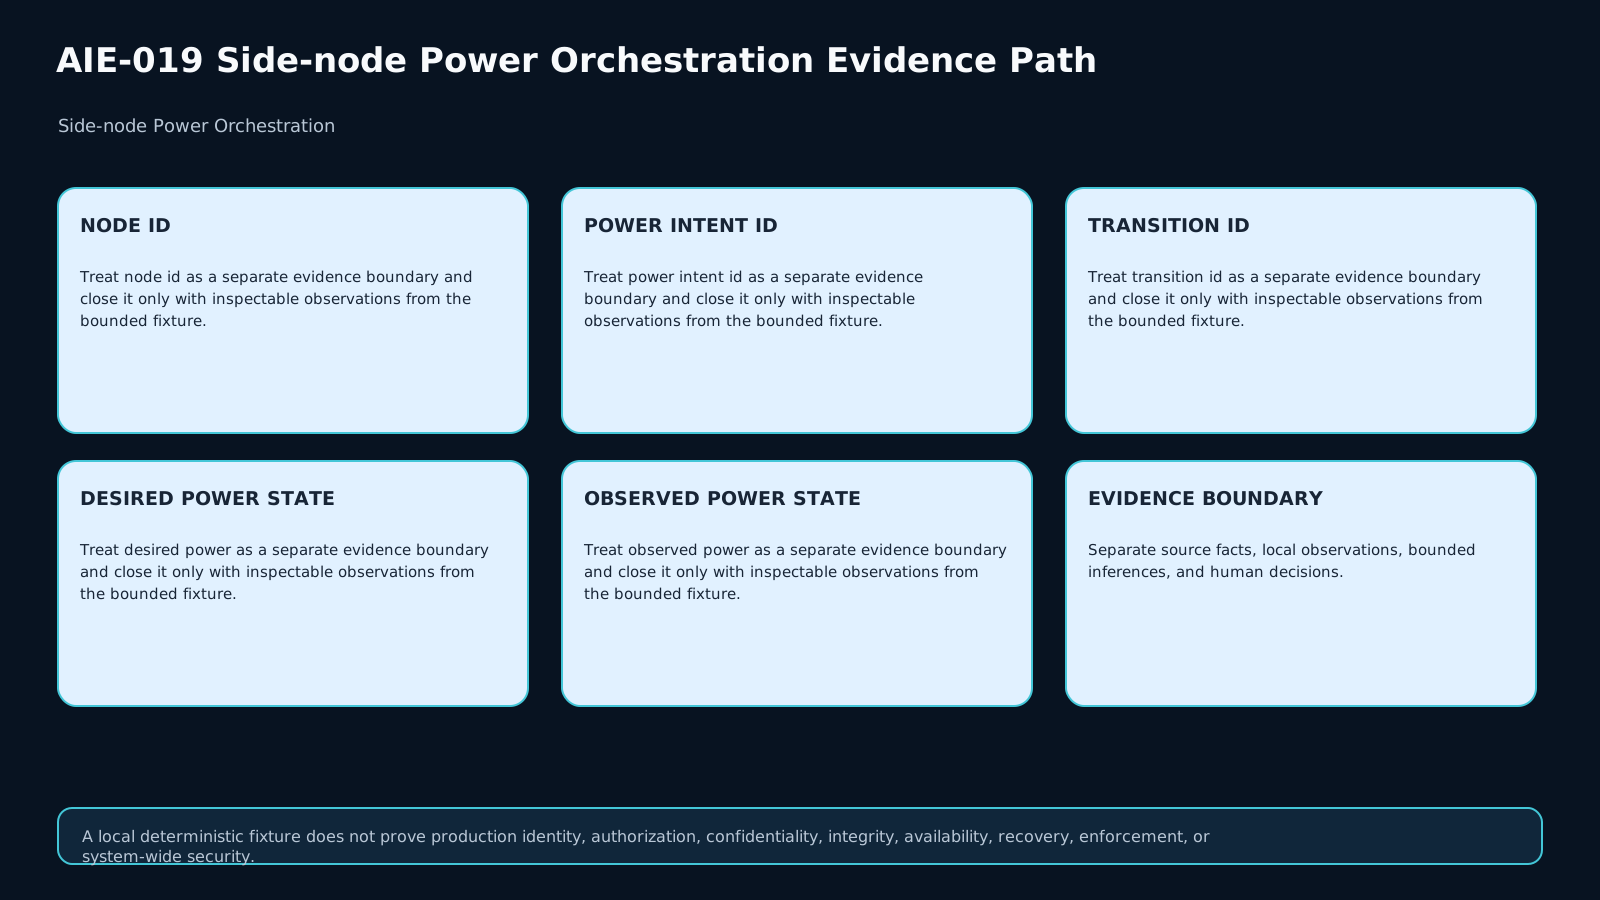
desired_power_state=ON فقط هدف controller است. observed_power_state=ON یعنی از یک سطح مشاهدهٔ معتبر فهمیدهایم host روشن است. runtime_readiness=READY ادعای قویتری است: سرویسها و runtime لازم برای workload از probe تعریفشده عبور کردهاند. به همین شکل، پاسخ موفق به یک درخواست shutdown فقط میگوید درخواست پذیرفته شده؛ تا وقتی state confirmation نداریم نباید OFF ثبت شود. این جداسازی جلوی بخش بزرگی از false successها را میگیرد.
4. قبل از هر transition، capability واقعی و action مجاز را کشف کنید
اگر node یک Redfish service دارد، ComputerSystem.Reset میتواند actionهایی مثل On، GracefulShutdown، GracefulRestart، ForceRestart و ForceOff را تعریف کند و service میتواند allowable valueهای همان system را اعلام کند. این یعنی action باید از capability همان node کشف شود، نه از حافظه یا فرض. وجود Redfish روی یک سرور، وجود آن روی همهٔ side nodeها را ثابت نمیکند. policy محلی نیز باید مشخص کند کدام action از نظر عملیاتی مجاز است.
5. Wake-on-LAN یک capability است؛ ارسال magic packet readiness نیست
Linux ethtool netlink برای Wake-on-LAN عملیات wol-get و wol-set و modeهای مربوط را در سطح network device در اختیار میگذارد. این evidence برای فهم supported/enabled WOL مفید است، اما success در ارسال wake request معادل روشنشدن host یا آمادهشدن GPU/runtime نیست. firmware، NIC، power state، شبکه و تنظیمات میتوانند نتیجه را عوض کنند. بنابراین بعد از wake باید observed power و سپس ready probe جدا ثبت شوند.
6. shutdown امن از admission و drain شروع میشود
قبل از خاموشی، orchestrator نباید فقط active_job_count=0 را ببیند؛ باید qualified demand را هم دوباره بررسی کند و admission جدید را ببندد تا race ساخته نشود. Kubernetes یک pattern جاری مفید نشان میدهد: هنگام graceful node shutdown، kubelet پذیرش Pod جدید را متوقف میکند و Podهای در حال اجرا را در grace periodهای تنظیمشده terminate میکند. MAKNOW لازم نیست Kubernetes باشد؛ اصل مهندسی مهم این است که «عدم پذیرش workload جدید + تخلیهٔ workload موجود» قبل از transition غیرقابلبازگشت evidence داشته باشد.
7. telemetry تازه یک gate است، نه تزئین dashboard
اگر idle timer تمام شده ولی telemetry decisive در وضعیت STALE است، controller حق ندارد فقدان داده را به «همهچیز خوب است» تبدیل کند. freshness باید همراه timestamp و policy version ثبت شود. در چنین وضعی state مناسب DEFER یا BLOCKED است تا evidence تازه شود. این درس health semantics را از AIE-017 میگیرد؛ فقط تصمیم میگیرد stale evidence برای power transition کافی نیست.
8. minimum-on، minimum-off و cooldown از نوسان و thrash جلوگیری میکنند
خاموش و روشنکردن سریع node میتواند به latency، فرسودگی، queue churn و رفتار غیرقابلپیشبینی منجر شود. policy باید حداقل زمان روشنبودن، حداقل زمان خاموشبودن و cooldown پس از transition را جدا تعریف کند. تمامشدن idle threshold بهتنهایی کافی نیست. مثال: اگر threshold بیکاری ۲۰ دقیقه است اما minimum_on_time=30m و node فقط ۲۲ دقیقه روشن بوده، تصمیم باید DEFER بماند حتی اگر صف خالی باشد.
9. inhibitor را بهعنوان evidence عملیاتی جدی بگیرید
systemd برای جلوگیری یا تأخیر shutdown/sleep inhibitor lock دارد. درخواستهای عادی باید این lockها را رعایت کنند مگر policy صریح و استثنایی خلاف آن را مجاز کرده باشد. مسیرهای force میتوانند shutdown عادی serviceها را دور بزنند و در force شدید خطر data loss دارند. در MAKNOW، ForceOff shortcut صرفهجویی انرژی نیست؛ اگر inhibitor فعال است، default امن BLOCK/DEFER است و override باید جدا، قابل ممیزی و از قبل مجاز باشد.
10. state machine پیشنهادی: intent → guards → request → confirmation
یک مسیر قابل اتکا میتواند این stateها را داشته باشد: OFF، WAKING، ON_IDLE، ACTIVE، DRAINING، SHUTTING_DOWN و stateهای محافظ مثل UNKNOWN/BLOCKED. برای shutdown: demand/drain/freshness/timing/capability/inhibitor gate را ارزیابی کنید، admission را ببندید، demand را دوباره بخوانید، transition intent بسازید، GracefulShutdown را request کنید و فقط با observed confirmation به OFF بروید. برای wake: demand qualified + timing/capability → request → WAKING → observed ON → ready probe → admission open.
11. race را درست مدیریت کنید: تصمیم قدیمی را تا آخر اجرا نکنید
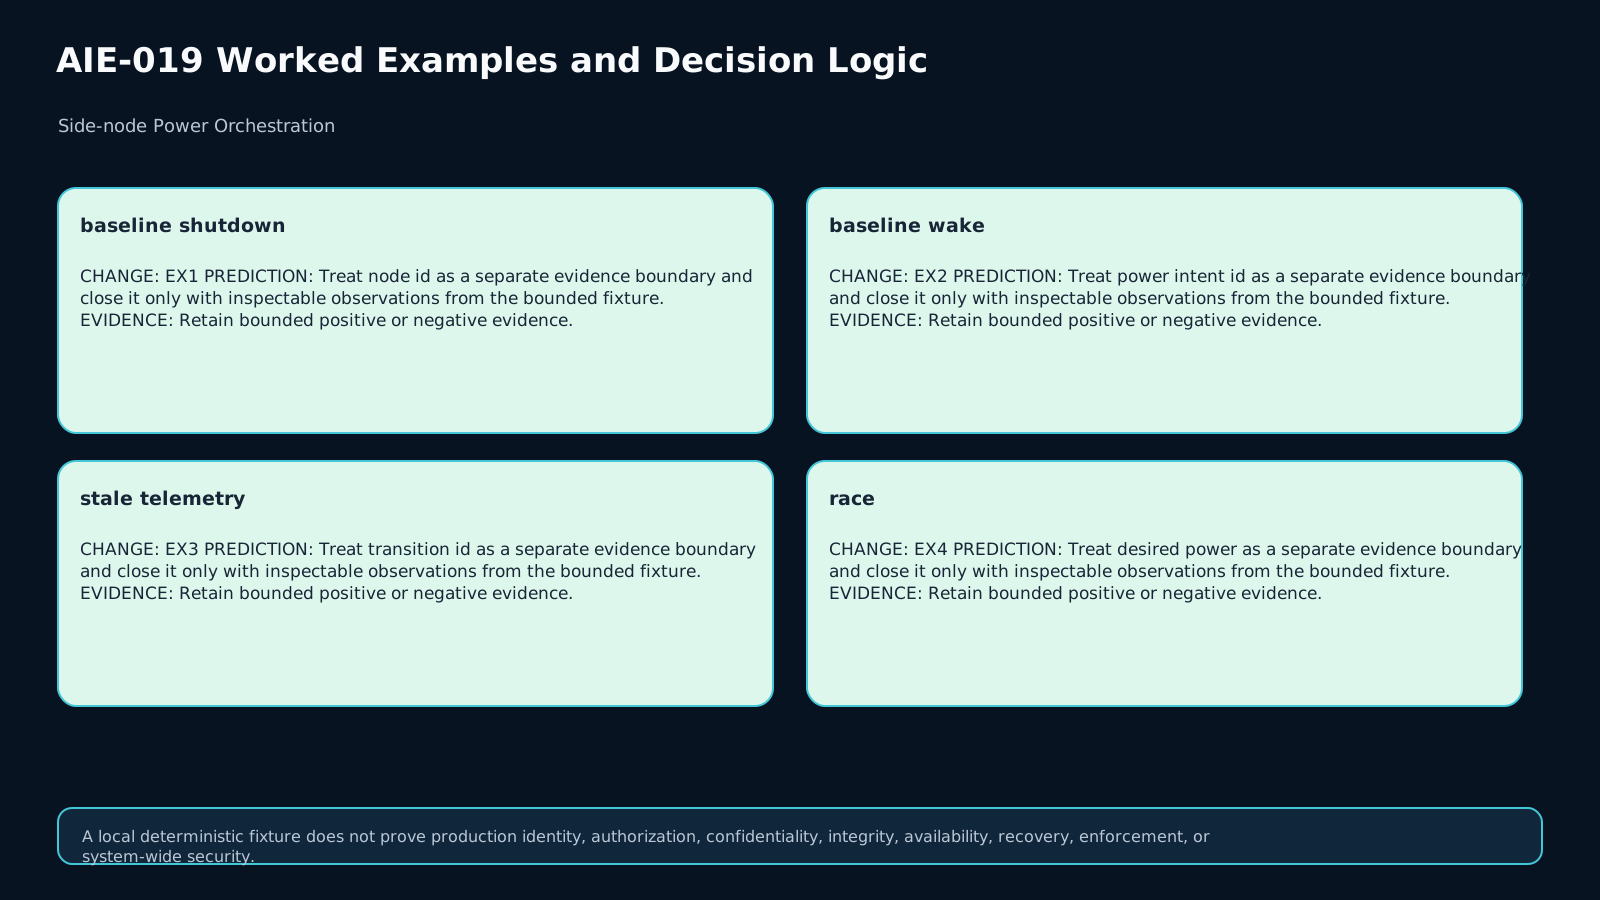
فرض کنید shutdown وارد DRAINING شده و در grace window یک job پراولویت برای N-GPU-2 runnable میشود. controller باید قبل از مرحلهٔ غیرقابلبازگشت evidence را تازه کند. اگر host هنوز recoverable است، shutdown pending را cancel/abort کند، observed state را بررسی کند و admission را فقط بعد از readiness confirmation باز کند. ادامهٔ تصمیم timer قدیمی با وجود demand جدید یک race bug است، نه automation موفق.
12. timeout، retry/backoff و UNKNOWN باید bounded باشند
power control ممکن است request را بپذیرد اما state تغییر نکند؛ wake نیز ممکن است host را روشن کند اما runtime هرگز ready نشود. هر transition به deadline، retry budget و backoff نیاز دارد. با پایان deadline، success نسازید. اگر retry budget باقی است، DEFER/WAKING/UNKNOWN را با زمان recheck نگه دارید؛ اگر capability یا confirmation دیگر قابل اثبات نیست، BLOCK یا POWER_CONTROL_UNAVAILABLE را در reason ثبت کنید. retry بینهایت فقط failure را پنهان میکند.
13. Safety Record باید چه چیزی را نگه دارد؟
حداقل این evidenceها را ثبت کنید: node_id، power_intent_id، transition_id، desired/observed/readiness، control method و allowable action، queued demand، active job count، drain/admission state، telemetry freshness، idle/min-on/min-off/cooldown، inhibitor، request timestamp، deadline، retry/backoff، request result، state confirmation، ready probe، race flag، manual override، final decision، reason، power_policy_version و provenance. این record باید نشان دهد کدام evidence «درخواست» را ثابت میکند و کدام evidence «حالت واقعی» را.
14. مثالها و ضدنمونههای تصمیم
Baseline shutdown: node ON_IDLE، demand صفر، job فعال صفر، drain clear، telemetry fresh، min-on و idle window پاس، inhibitor clear، capability مجاز و GracefulShutdown available؛ admission بسته میشود، recheck هنوز demand صفر است، request پذیرفته میشود و state بعداً OFF تأیید میشود → SHUTDOWN. Baseline wake: demand qualified وجود دارد، min-off/cooldown پاس و control مجاز است؛ request موفق، observed ON و ready probe پاس → START و سپس admission باز. ضدنمونهها: telemetry stale → DEFER؛ inhibitor فعال → BLOCK؛ control unsupported → BLOCK؛ wake ack بدون ready probe → DEFER نه START.
15. Transfer و چکلیست نهایی
در transfer اول، هنگام grace window demand جدید میآید: تصمیم shutdown را از نو ارزیابی کنید، pending transition را در صورت امکان cancel کنید و فقط پس از verified ON+READY admission را باز کنید. در transfer دوم، wake request پذیرفته شده اما ready probe تا deadline پاس نمیشود: WAKING/UNKNOWN یا DEFER/BLOCK را نگه دارید و job را به node bind نکنید. چکلیست: identity و policy version ثبت؟ demand و active jobs تازه؟ drain/admission روشن؟ telemetry fresh؟ min-on/min-off/cooldown پاس؟ inhibitor clear؟ capability و allowable action ثابت؟ request و confirmation جدا؟ deadline/retry bounded؟ race recheck انجام شده؟ readiness مستقل از power-on تأیید؟ فقط بعد از این evidence تصمیم نهایی صادر شود.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
Q1
Why is an expired idle timer insufficient evidence for SHUTDOWN?
Q2
A wake request was acknowledged but the node did not pass readiness before deadline. What may the scheduler rely on?
Q3
New qualified demand appears while the node is DRAINING for shutdown. What must change?
Q4
How should an active inhibitor or unsupported power-control method affect the decision?
ملاکهای ارزیابی (rubric)
A passing response must:
- Separate desired power state, observed power state, and runtime readiness.
- Bind exact node and power-policy identity before making a transition claim.
- Gate shutdown on fresh demand/drain/telemetry/timing/inhibitor/capability evidence rather than an idle timer alone.
- Close scheduler admission before shutdown, then recheck demand to catch races.
- Prefer graceful shutdown; never treat ForceOff as a normal optimization path.
- Treat a power-control acknowledgement as intent evidence, not state confirmation.
- Use deadlines and bounded retry/backoff and preserve UNKNOWN/DEFER/BLOCK states when confirmation is missing.
- Re-evaluate and cancel a pending shutdown when new qualified demand appears before irreversible power-off.
- Reopen admission after wake/cancel only when observed power and runtime readiness are independently verified.
منابع و تازگی
مطالعهٔ موارد (case studies)
تصاویر درس
فایلهای آزمایشگاه
Implement evaluate_power_intent(case) in starter.py. Keep desired state, observed state, and runtime readiness separate. Your result must contain these eight fields: evidence_fresh, control_available, timing_ok, shutdown_eligible, wake_eligible, transition_state, final_decision, and scheduler_admission_state.
Use only the supplied synthetic fixtures. A control acknowledgement must never be treated as observed state or readiness proof. ForceOff is not a normal optimization path. Run python run_checks.py to verify fixture structure; the hidden evaluation checks deterministic decisions.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)