مهندسی سامانههای هوش مصنوعی · فصل ۴ — Model Artifacts، Transfer، License، Scheduler و Device Telemetry · 147
Capability-aware Scheduler
میتواند مدل یا ابزار AI را فراخوانی کند اما contract، qualification، routing، cost، trust و failure را کنترل نمیکند. موضوع جاری: «Capability-aware Scheduler». میتواند «Capability-aware Scheduler» را در یک workflow AI محدود طراحی کند و validation، authority، cost یا failure controls مرتبط را مشخص کند.
خلاصهٔ درس
میتواند مدل یا ابزار AI را فراخوانی کند اما contract، qualification، routing، cost، trust و failure را کنترل نمیکند. موضوع جاری: «Capability-aware Scheduler».
میتواند «Capability-aware Scheduler» را در یک workflow AI محدود طراحی کند و validation، authority، cost یا failure controls مرتبط را مشخص کند.
خروجی این درس
میتواند «Capability-aware Scheduler» را در یک workflow AI محدود طراحی کند و validation، authority، cost یا failure controls مرتبط را مشخص کند.
1. مسئله واقعی: «یک GPU موجود است» برای placement کافی نیست
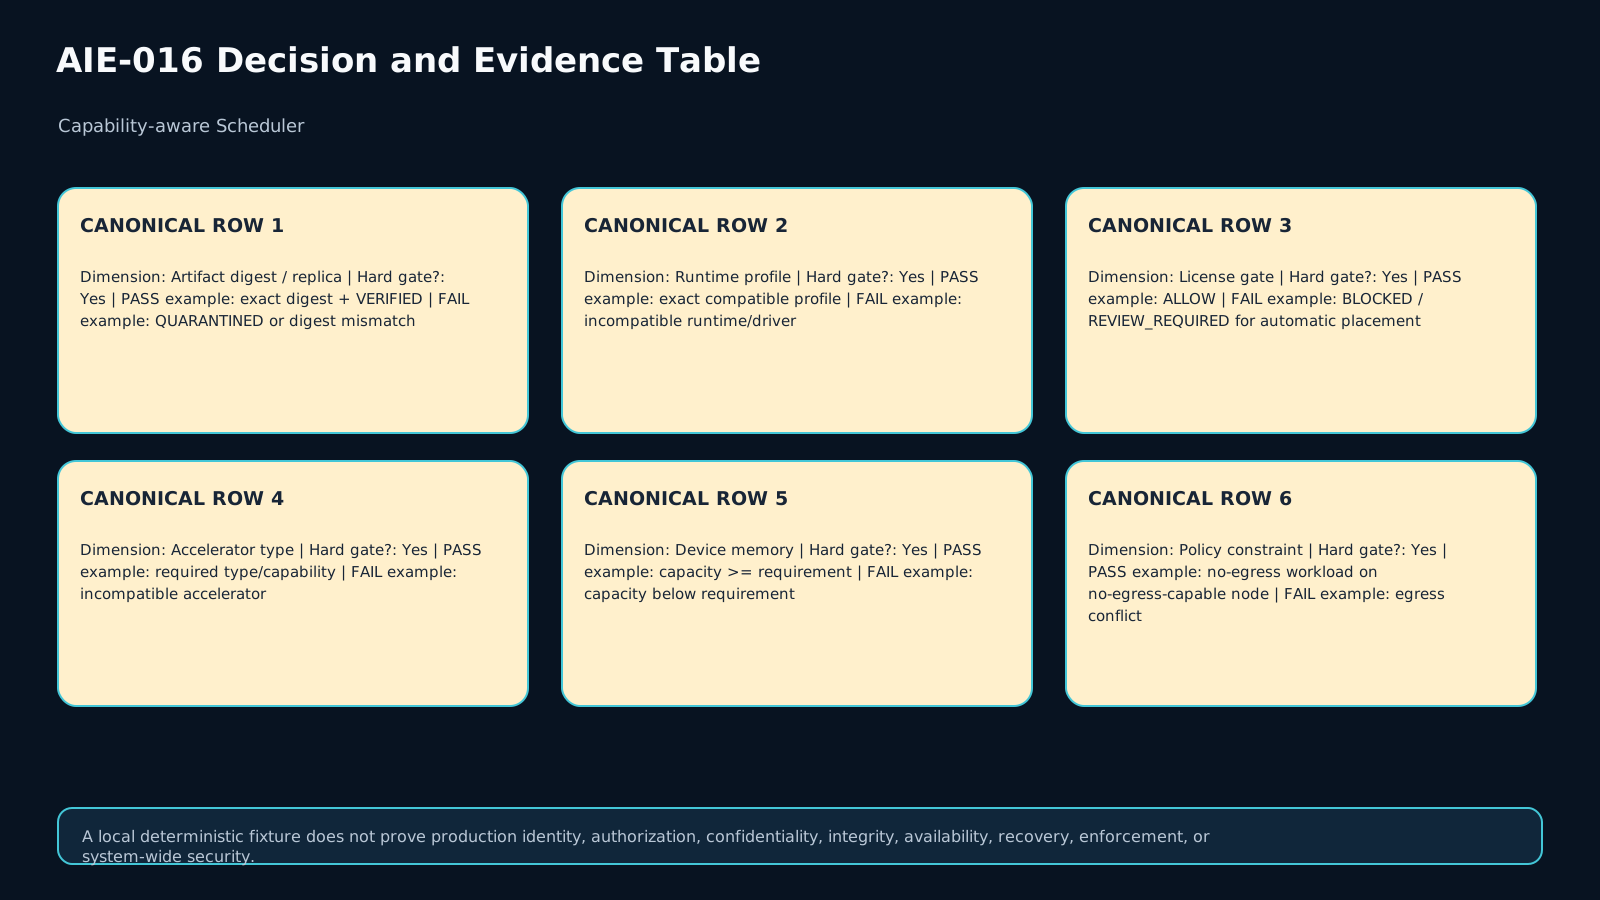
فرض کنید workload ویدئویی/هوش مصنوعی W-GPU-7 به artifact دقیق sha256:D-GPU، runtime profile برابر R3، حداقل ۲۴ GiB حافظهٔ device، accelerator سازگار، license state برابر ALLOW و policy «بدون egress خارجی» نیاز دارد. سه node داریم: N1 فقط ۱۶ GiB حافظه دارد؛ N2 ۴۸ GiB دارد اما replica همان artifact در وضعیت QUARANTINED است؛ N3 دقیقاً ۲۴ GiB، artifact تأییدشده، runtime سازگار و policy clearance معتبر دارد. اگر scheduler فقط «GPU دارد» یا یک score کلی را ببیند، placement اشتباه کاملاً ممکن است. artifact مالک این درس Capability-aware AI Workload Scheduling Decision Record v1 است.
2. مرز درس: requirement و policy را مصرف میکنیم؛ telemetry و power را مالک نمیشویم
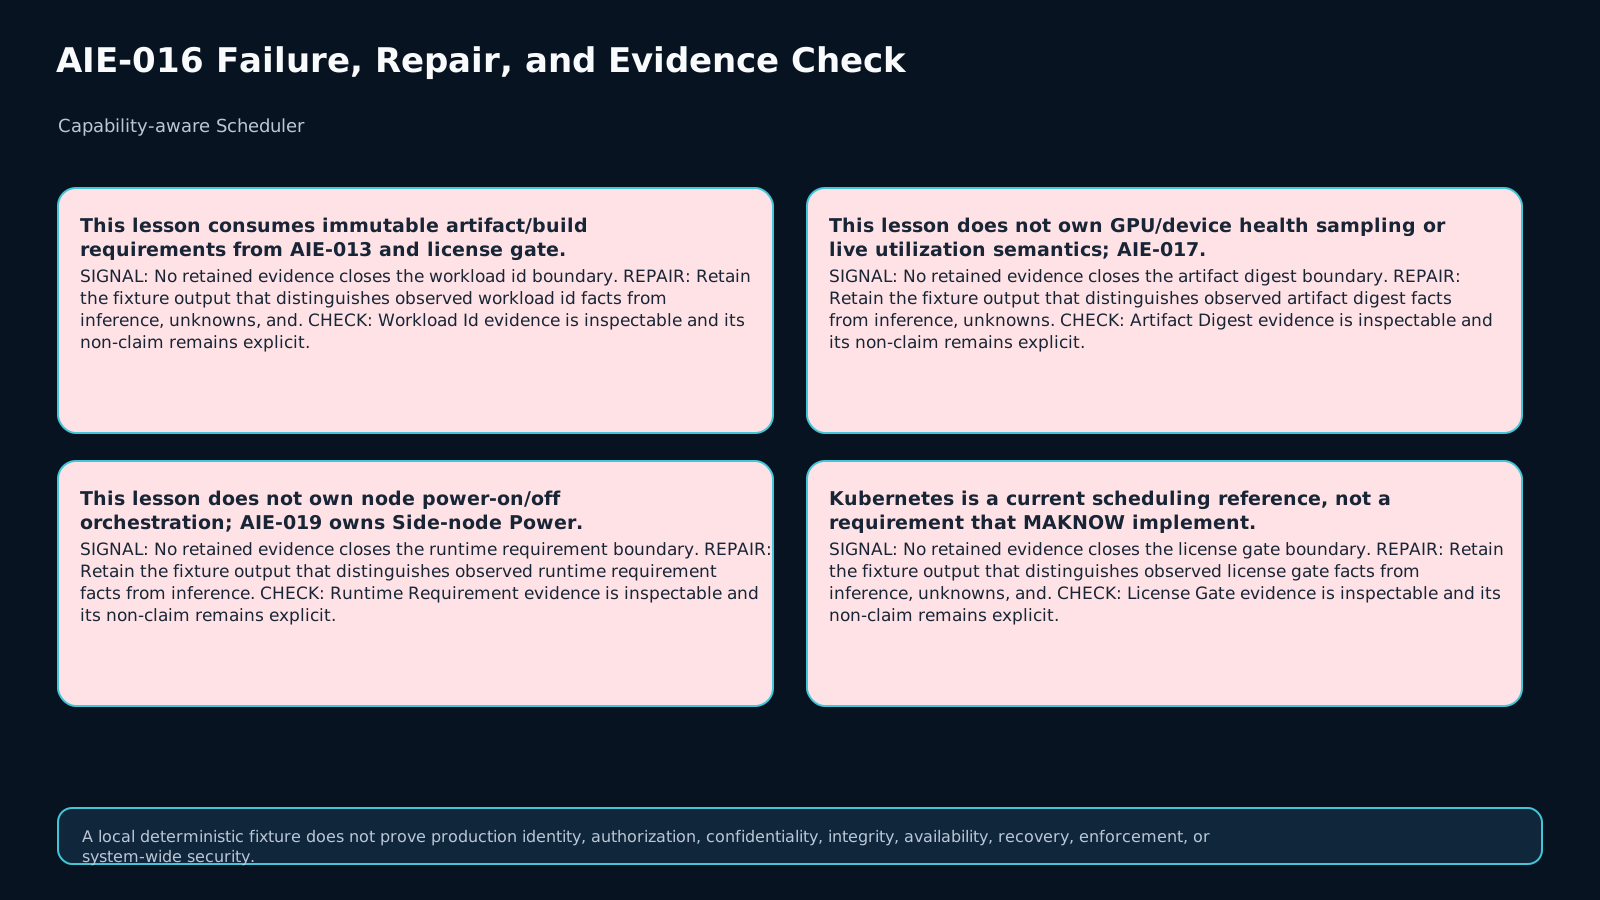
AIE-016 requirementهای immutable artifact/runtime را از AIE-013 و license/policy state را از AIE-015 مصرف میکند؛ آنها را بازتعریف نمیکند. همچنین utilization، temperature یا health زندهٔ GPU را بهعنوان capability declaration تولید نمیکند؛ آن مرز متعلق به AIE-017 است. روشن/خاموشکردن node نیز متعلق به AIE-019 است. خروجی این درس فقط eligibility، scoring و placement decision محدود و قابل ممیزی است.
3. قرارداد workload باید دقیق، versioned و قابل مقایسه باشد
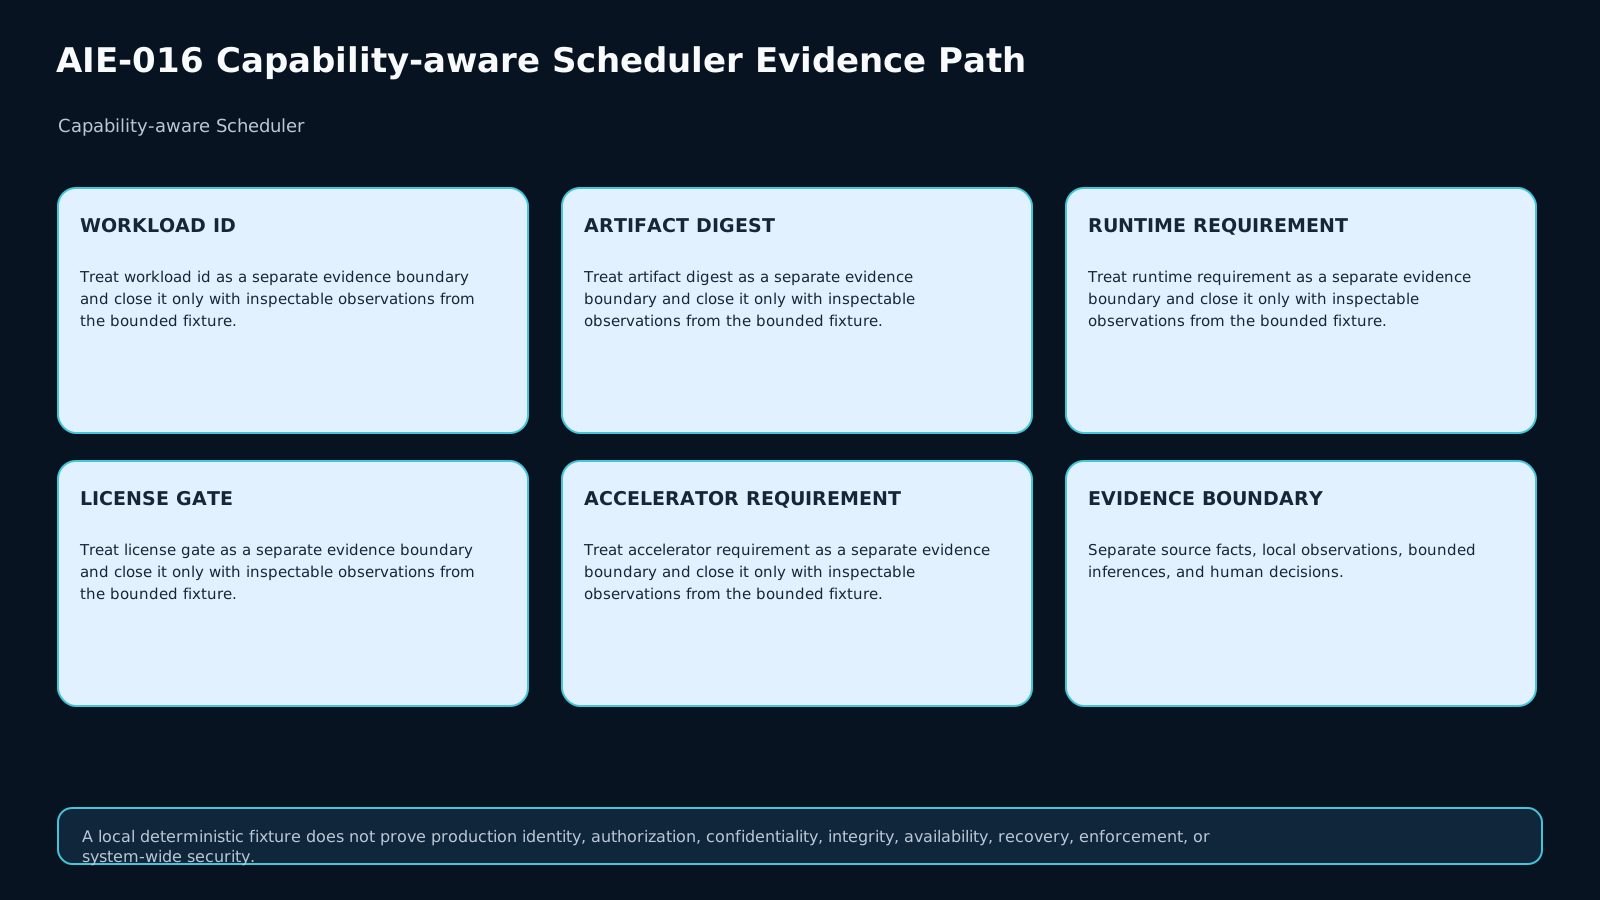
Scheduler قبل از دیدن nodeها باید workload request را به requirementهای صریح تبدیل کند: workload_id، artifact_digest، runtime_requirement، license_gate، accelerator_requirement، memory_requirement، policy_constraint و هر constraint دیگری که واقعاً hard است. عبارت مبهمی مثل «GPU خوب» یا «مدل روی CUDA اجرا میشود» قابل ممیزی نیست. requirement باید به identity/version/policy مشخص متصل باشد تا بعداً بتوان توضیح داد چرا یک node رد یا پذیرفته شده است.
4. capability declaration با live telemetry یکی نیست
Static capability میگوید node چه چیزی را اعلام و qualify کرده است: نوع accelerator، حافظهٔ قابل اتکا برای admission، runtime/driver capability، policy/domain، artifact replica state و freshness همان metadata. Live telemetry میگوید device در این لحظه چه وضعی دارد. utilization پایین نمیتواند نبود ۲۴ GiB حافظه، runtime ناسازگار یا artifact قرنطینهشده را جبران کند. telemetry ممکن است بعداً scoring/load-awareness را تغذیه کند، اما جای hard capability evidence را نمیگیرد.
5. Kubernetes device pluginها الگوی مفیدی برای advertise کردن resource تخصصی میدهند
مستندات جاری Kubernetes میگوید device plugin framework برای advertise کردن hardware resourceهایی مثل GPU، NIC و FPGA به kubelet استفاده میشود و workload میتواند resource تخصصی را request کند. این یک reference مهم برای «capability باید صریح باشد» است، نه اثبات اینکه هر label یا هر resource name در محیط شما تازه، صحیح یا کافی است. MAKNOW باید provenance و freshness capability record خودش را جدا نگه دارد.
6. label، selector، affinity و taint ابزار placement هستند؛ نه مدرک کامل qualification
در Kubernetes میتوان nodeها را بر اساس accelerator type label کرد، با node selector/affinity requirement یا preference ساخت و با taint/toleration nodeهای تخصصی را برای workloadهای مناسب نگه داشت. اما وجود label مثل accelerator=h100 بهتنهایی memory size، artifact digest، runtime profile، license clearance یا freshness را ثابت نمیکند. label باید یکی از چند evidence dimension باشد، نه shortcut نهایی.
7. اصل محوری: اول hard gate، بعد score
الگوی جاری kube-scheduler نیز ابتدا nodeهای نامناسب را filter میکند، سپس فقط feasible nodeها را score میکند و در نهایت bind انجام میدهد. طراحی MAKNOW همین تفکیک را سختگیرانهتر میکند: artifact/runtime/license/capability/memory/policy hard gate هستند و هیچ امتیاز soft حق ندارد failure یک hard gate را جبران کند. اگر N2 بهخاطر artifact قرنطینهشده رد شده است، locality score صد هم نباید آن را دوباره وارد رقابت کند.
8. hard gateها را typed کنید: PASS، FAIL، UNKNOWN و STALE
هر gate فقط Boolean نیست. PASS یعنی evidence کافی و معتبر است؛ FAIL یعنی requirement صریحاً نقض شده؛ UNKNOWN یعنی evidence لازم وجود ندارد؛ STALE یعنی evidence هست اما از freshness policy عبور کرده است. FAIL node را از feasible set خارج میکند. UNKNOWN/STALE نیز نباید به PASS تبدیل شود؛ اگر هیچ node قابلاستفادهٔ دیگری نداریم، تصمیم معمولاً DEFER است تا qualification یا refresh کامل شود.
9. artifact locality فقط بعد از integrity و replica state معنا دارد
داشتن فایل محلی میتواند preference خوبی باشد، اما فقط وقتی replica دقیقاً همان digest موردنیاز باشد و state آن VERIFIED باشد. QUARANTINED، digest mismatch یا replica با provenance نامشخص hard failure است. بعد از اینکه node feasible شد، verified locality میتواند score مثبت بدهد چون transfer/startup cost را کم میکند؛ اما locality هیچوقت integrity را override نمیکند.
10. runtime، accelerator و memory را جدا ارزیابی کنید
وجود accelerator مناسب بهتنهایی runtime compatibility را ثابت نمیکند و runtime سازگار هم حداقل حافظه را تضمین نمیکند. برای هر node حداقل سه check مستقل داشته باشید: accelerator/type compatibility، runtime/driver capability و memory requirement. مثال این درس عمداً N1 را با GPU درست ولی ۱۶ GiB حافظه رد میکند. اگر scheduler این سه را به یک label مبهم فشرده کند، علت failure و trigger لازم برای requalification گم میشود.
11. license و policy gate بخشی از eligibility هستند، نه scoring
اگر license state REVIEW_REQUIRED، BLOCKED یا policy «بدون egress» با node ناسازگار است، آن node نباید با queue کوتاه یا GPU قویتر برنده شود. permission و policy یک preference نیستند. scheduler باید نسخهٔ policy و source state را در decision record ثبت کند تا پاییندست بداند placement تحت کدام مجوز/constraint انجام شده است.
12. scoring فقط بین feasible nodeها انجام میشود
پس از hard gateها میتوان preferenceهایی مانند verified artifact locality، queue pressure، expected startup latency، energy preference یا load signal را score کرد. score باید توضیحپذیر و versioned باشد و فقط روی feasible_nodes اجرا شود. اگر دو node هر دو eligibility کامل دارند، score تعیین میکند کدام بهتر است؛ اگر یک node hard fail دارد، score آن اصلاً نباید محاسبه یا در انتخاب لحاظ شود.
13. سه outcome محدود: PLACE، UNSCHEDULABLE و DEFER
PLACE وقتی صادر میشود که حداقل یک node تمام hard gateها را پاس کند و selected node binding record کامل داشته باشد. UNSCHEDULABLE وقتی مناسب است که همهٔ candidateها با evidence قطعی hard fail شوند و uncertainty decisive باقی نمانده باشد. DEFER برای وضعیتی است که هیچ feasible node فعلی نداریم اما حداقل یک candidate بهعلت UNKNOWN/STALE هنوز قابل qualification است. این تفکیک جلوی تبدیل «هنوز نمیدانیم» به «غیرممکن است» را میگیرد.
14. Lab: هشت سناریو برای شکستن shortcutهای رایج
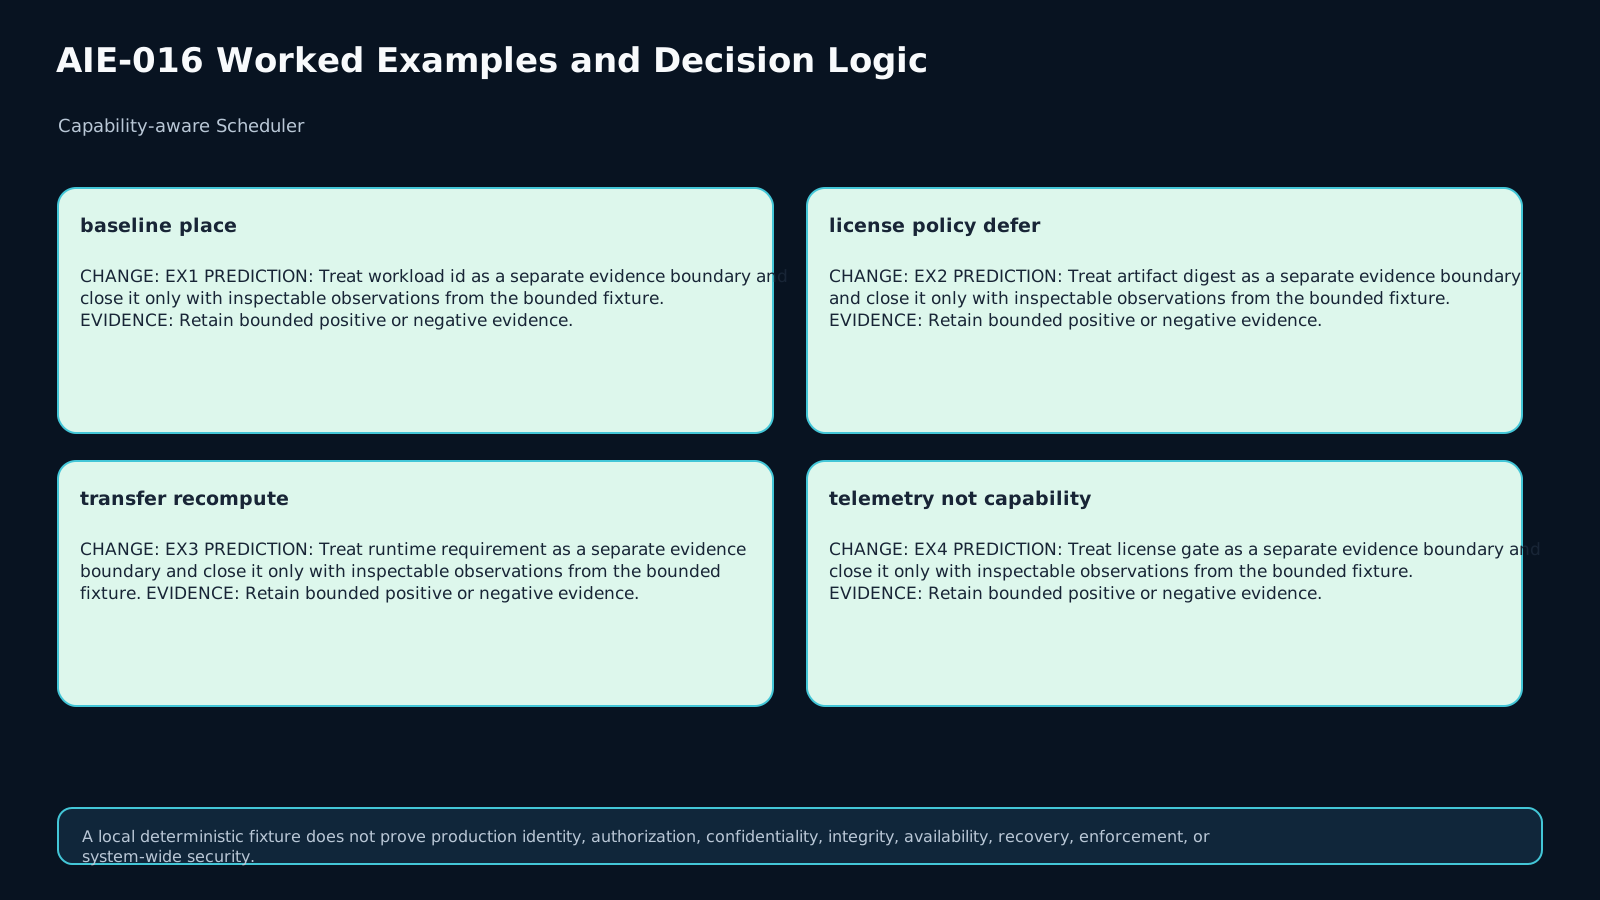
Case 1 baseline است: N1 بهخاطر memory و N2 بهخاطر artifact quarantine رد میشوند و فقط N3 PLACE میشود. Case 3 transfer است: capability metadata N3 stale میشود و N2 با replica/runtime معتبر به node منتخب تبدیل میشود. Case 4 نشان میدهد utilization پایین یا label درست جای capability تازه را نمیگیرد. Case 8 score trap است: node نامعتبر score بسیار بالاتری دارد، اما چون hard gate را رد کرده هرگز وارد scoring رقابتی نمیشود.
15. Transfer و چکلیست نهایی
در transfer، تصمیم قبلی را کپی نکنید؛ feasible set را از evidence جدید دوباره بسازید. چکلیست: workload contract دقیق؛ artifact digest و replica state؛ runtime/driver capability؛ accelerator و memory؛ license/policy gate؛ capability freshness؛ hard gate result برای هر node؛ تفکیک feasible/uncertain/hard-failed؛ scoring فقط روی feasibleها؛ decision محدود PLACE/UNSCHEDULABLE/DEFER؛ binding record شامل scheduler version و reason؛ recheck trigger؛ و هیچ ادعایی مبنی بر اینکه utilization زنده جای capability declaration را گرفته است.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
Q1
Why can a node with the highest preference score still be ineligible?
Q2
When should the result be DEFER rather than UNSCHEDULABLE?
Q3
Why is low live GPU utilization not proof that a workload can run on that node?
Q4
In the transfer, N3 becomes stale and N2 gains a verified artifact/runtime record. What must the scheduler do?
ملاکهای ارزیابی (rubric)
Blocking dimensions: exact workload identity/requirements; hard-gate-before-score discipline; explicit PASS/FAIL/UNKNOWN/STALE handling; provenance and policy version; bounded PLACE/DEFER/UNSCHEDULABLE decision; and changed-context transfer. A submission fails if a soft score overrides a hard failure, live telemetry is treated as static capability proof, UNKNOWN/STALE is silently coerced to PASS, or the previous placement is copied after decisive evidence changes.
منابع و تازگی
مطالعهٔ موارد (case studies)
تصاویر درس
فایلهای آزمایشگاه
Implement schedule(case) in starter.py. Build hard-gate results from the versioned workload request and node capability records. Preserve UNKNOWN and STALE; do not infer capability from the included live-utilization field. Compute preferences only for nodes that pass all hard gates. Emit one bounded result: PLACE, UNSCHEDULABLE, or DEFER, plus a selected node/binding record only when placement is justified.
Run python run_checks.py to verify the eight learner fixtures are structurally ready. Hidden evaluation checks deterministic outcomes.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)