وب مدرن، رابط کاربری و تجربهی وب · فصل ۷ — Locale، Translation Memory و QA · 58
Localization QA و AI-assisted Translation Review
syntax یا framework را میشناسد اما contract، runtime behavior، accessibility و failure boundary را یکپارچه نمیکند. موضوع جاری: «Localization QA و AI-assisted Translation Review». میتواند «Localization QA و AI-assisted Translation Review» را در یک feature محدود طراحی/پیادهسازی کند و correctness، accessibility یا failure behavior مرتبط را اثبات کند.
خلاصهٔ درس
syntax یا framework را میشناسد اما contract، runtime behavior، accessibility و failure boundary را یکپارچه نمیکند. موضوع جاری: «Localization QA و AI-assisted Translation Review».
میتواند «Localization QA و AI-assisted Translation Review» را در یک feature محدود طراحی/پیادهسازی کند و correctness، accessibility یا failure behavior مرتبط را اثبات کند.
خروجی این درس
میتواند «Localization QA و AI-assisted Translation Review» را در یک feature محدود طراحی/پیادهسازی کند و correctness، accessibility یا failure behavior مرتبط را اثبات کند.
۱. صفحه اول: روان بودن معادل درست بودن نیست
فرض کنید برای یک release، یک جمله آلمانی با کمک AI تولید شده است. جمله طبیعی و روان است، غلط املایی ندارد و حتی مدل میتواند با اعتمادبهنفس توضیح دهد چرا این wording خوب است. با این حال در همان candidate متغیر {amount} حذف شده، یک term قدیمی محصول استفاده شده و تاریخ/مبلغ با قالب source locale نمایش داده میشود. در یک candidate عربی دیگر، متن از نظر زبانی قابلقبول بهنظر میرسد اما metadata صریح زبان و جهت وجود ندارد. هیچکدام از این موارد با «روان بهنظر رسیدن» اثبات نمیشوند.
مسئله محدود این درس همین است. Localization QA باید چند لایه evidence را از هم جدا کند. checkهای خودکار برای defectهای مکانیکی مثل missing variable، message syntax، terminology ممنوع یا mismatch مشخص locale format مناسباند. در مقابل، meaning، context، style، تناسب فرهنگی و accept/edit/reject نهایی به review انسانی accountable نیاز دارند. خروجی AI فقط یک candidate است؛ authority نیست که خودش را تأیید کند.
راهنمای فعلی Microsoft برای localization testing همچنان functional، visual و linguistic validation را از هم جدا میکند و در linguistic review مواردی مثل accuracy، context، style، terminology، consistency، cultural appropriateness و correct data formats را مطرح میکند. [S-MS-L10N-TEST] در in-context review نیز context واقعی محصول بخشی از review است.
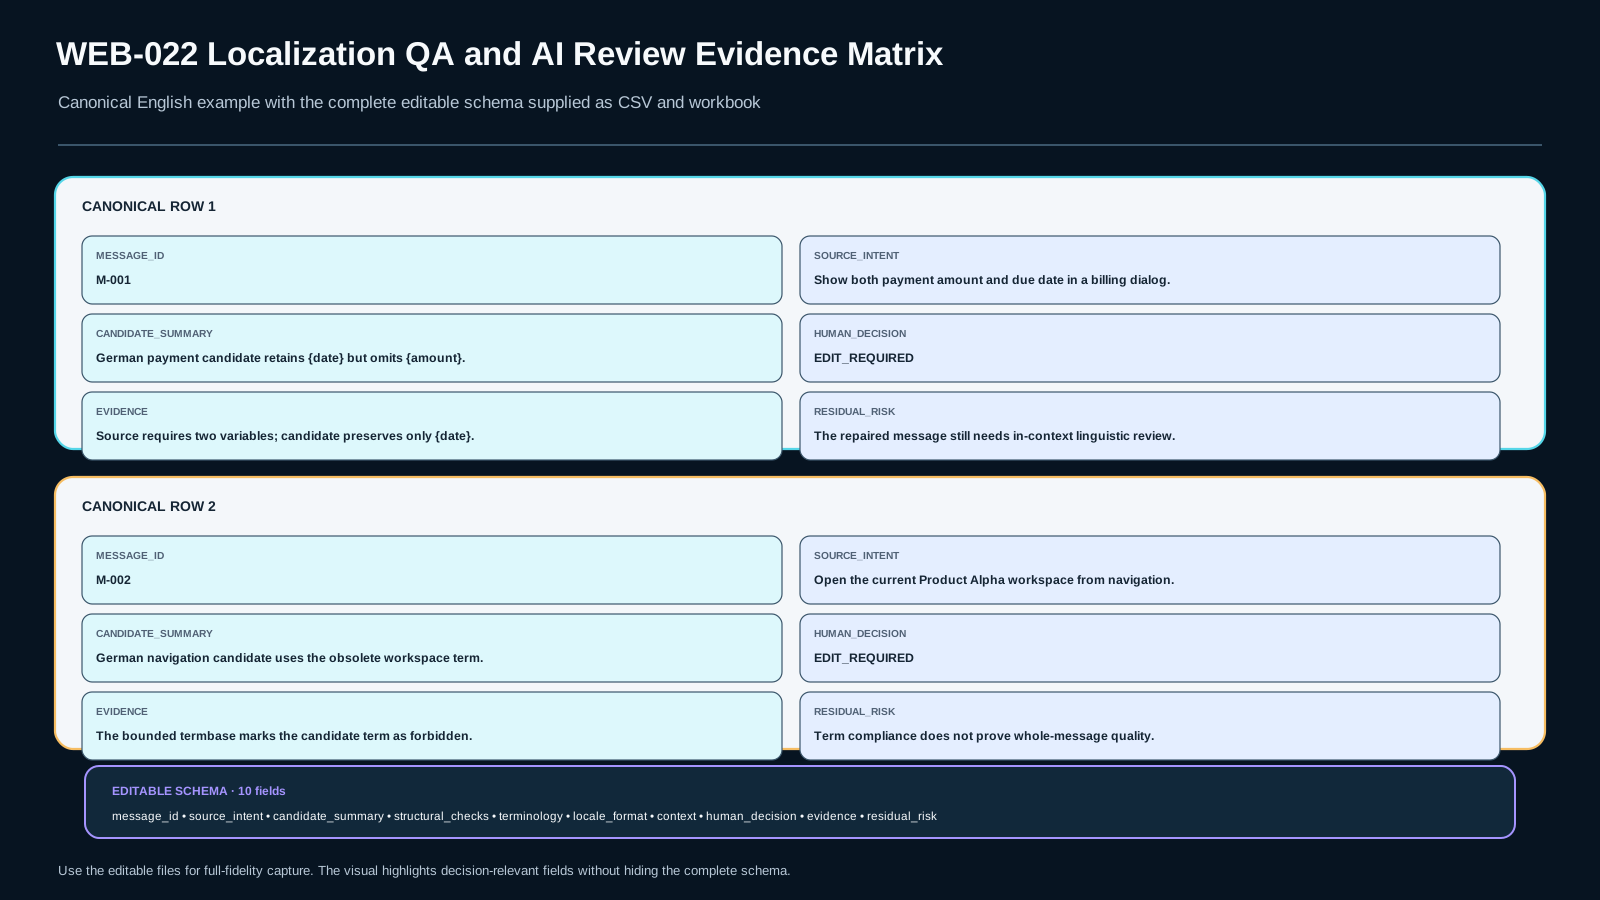
artifact این درس Localization QA & AI Review Record v1 است: برای هر message، source intent، candidate، structural checks، terminology، locale-format evidence، context review، human decision، mutation/repair evidence و residual limitation ثبت میشود.
۲. مسیر یادگیری: چیزی را automate کن که observable است
مسیر foundation با پنج سؤال شروع میشود. آیا candidate همه variableهای لازم را نگه داشته؟ آیا protected/forbidden terminology را رعایت کرده؟ آیا fixture نشان میدهد date/currency با target locale سازگار است؟ آیا برای stringهای RTL، metadata زبان و جهت موجود است؟ و در نهایت آیا reviewer انسانی candidate را برای context واقعی محصول درست میداند؟ چهار سؤال اول را میتوان با fixture قطعی محدود کرد؛ سؤال آخر را نمیتوان به همان مدلی سپرد که متن را تولید کرده است.
در مسیر repair، از یک defect شروع کنید. قبل از اجرای checker، failure code را پیشبینی کنید. سپس audit محلی را اجرا کنید، evidence row را ببینید، فقط همان boundary را repair کنید و دوباره اجرا کنید. اگر {amount} حذف شده، variable را برگردانید و بقیه wording را بیدلیل تغییر ندهید. اگر term محصول خلاف glossary است، term را اصلاح کنید اما review معنایی همچنان انسانی باقی میماند. اگر string عربی direction metadata ندارد، metadata را برگردانید و صریح بنویسید این evidence مربوط به transport/presentation است، نه اثبات معنی.
مسیر experienced از vocabulary مقدماتی عبور میکند و review system را بهعنوان acceptance contract میبیند: چه کسی تصمیم گرفت؟ چه چیزی خودکار بررسی شد؟ کدام claim نیاز به judgment انسانی داشت؟ context و terminology چه بود؟ mutation کدام بود؟ چه چیزهایی هنوز ثابت نشدهاند؟
۳. مدل ذهنی: یک candidate، چند boundary مستقل
جریان اصلی را اینطور نگه دارید:
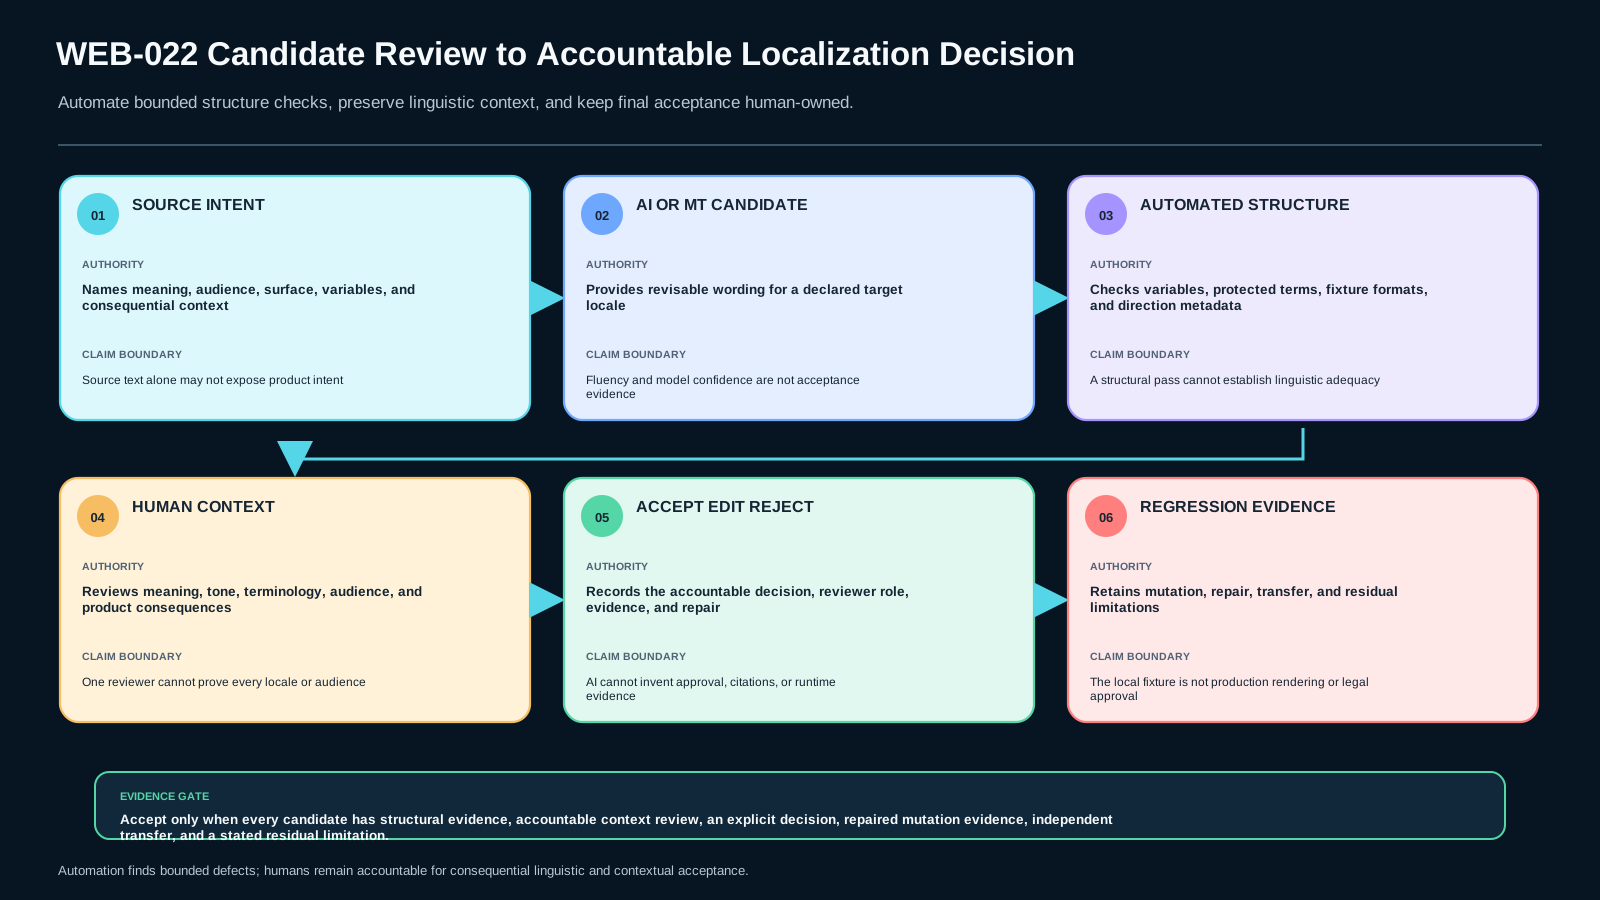
source + intent + context + terminology → AI/MT candidate → automated structural checks → human linguistic/context review → accept/edit/reject → regression evidence.
هر stage authority متفاوت دارد. Source intent میگوید message قرار است چه کاری انجام دهد. Terminology واژههای domain را محدود میکند اما کل جمله را اثبات نمیکند. Candidate ممکن است از LLM، MT، translation memory یا draft انسانی آمده باشد؛ origin آن evidence requirement را حذف نمیکند. checkهای خودکار propertyهای مکانیکی را observe میکنند. reviewer انسانی meaning و suitability context را بررسی میکند. تصمیم نهایی باید evidence مرتبط را trace کند.
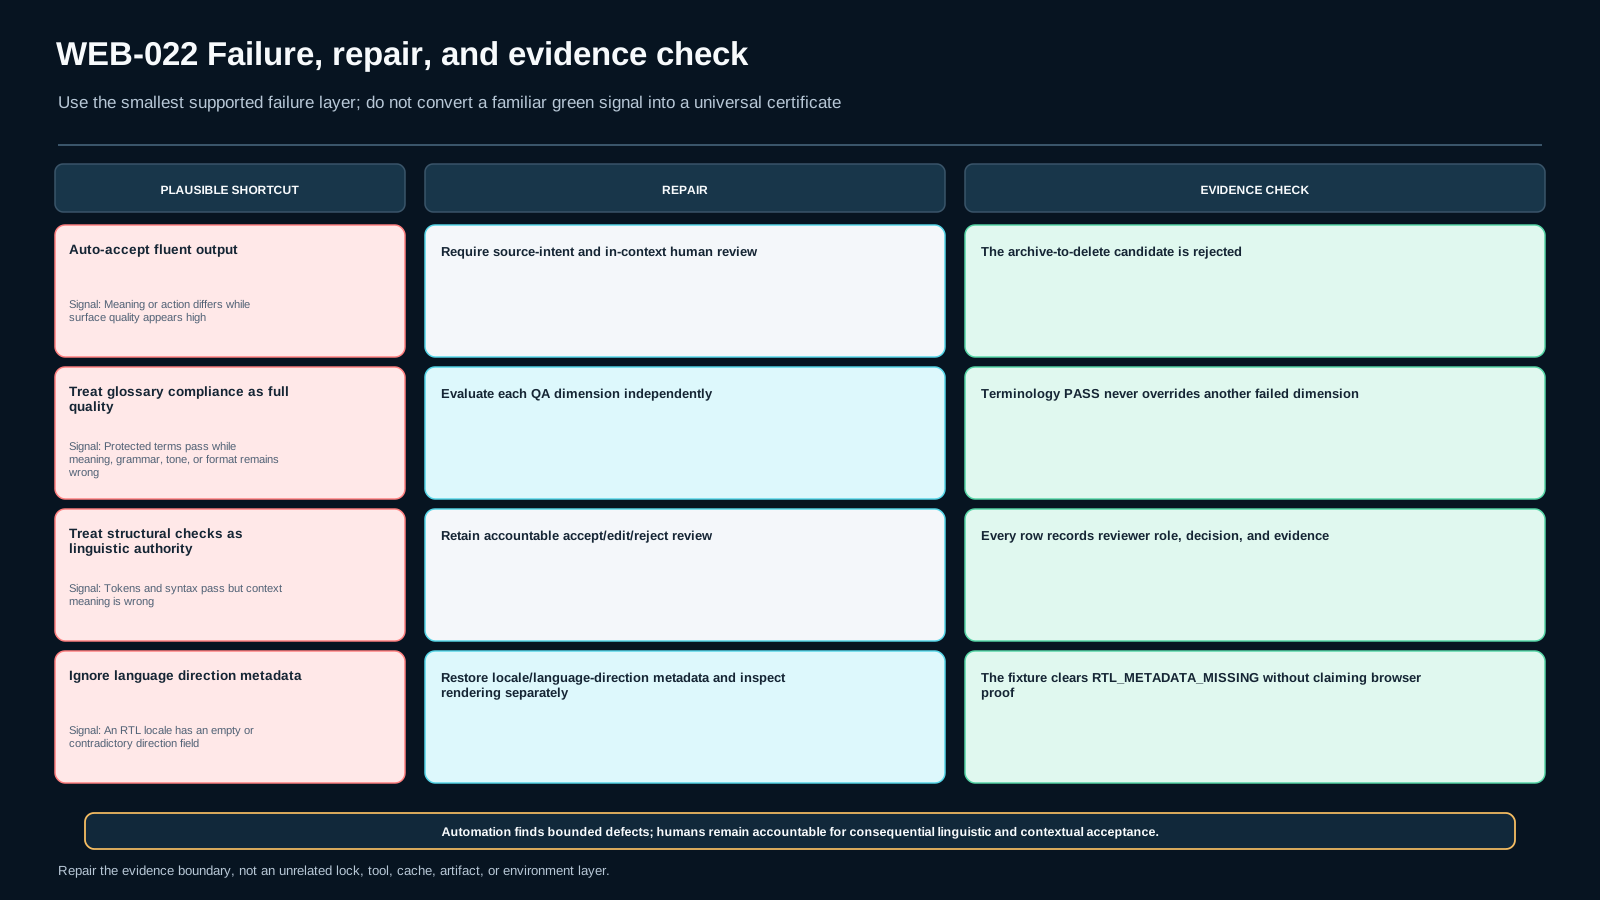
این مراحل را به یک «quality score» تبدیل نکنید. structural pass میتواند کنار context mistranslation وجود داشته باشد. glossary-compliant بودن میتواند در جملهای رخ دهد که action را برعکس ترجمه کرده است. fluent بودن میتواند همراه missing variable باشد. review انسانی نیز خطاناپذیر نیست، بنابراین record باید decision، reviewer role، evidence و regression test را نگه دارد.
برای RTL، metadata زبان و جهت boundary جداگانه است. Working Draft فعلی W3C برای String Metadata میگوید language و direction یک natural-language string باید قابل تعیین باشد و استفاده از metadata صریح را بر heuristic تنها ترجیح میدهد. [S-W3C-STRINGMETA] نبود lang/dir در این درس یک risk قابل تشخیص است؛ وجود آن proof زبانی نیست.
۴. لایه پایه: review row را قبل از checker طراحی کن
حداقل row باید این فیلدها را داشته باشد: message_id، source، source intent، candidate، source/target locale، required variables، candidate variables، terminology constraints، locale-format observation، context note، language/direction metadata، automated findings، human decision، reviewer role، evidence refs و residual risk.
Observation و inference را جدا کنید. Observation: source شامل {amount} است و candidate آن را ندارد. Inference: runtime substitution مبلغ از بین میرود. Decision: EDIT_REQUIRED. Observation: candidate آلمانی Arbeitsbereich دارد اما glossary فعلی Projektbereich را لازم میداند. Inference: policy terminology نقض شده. Decision: term را اصلاح کن و سپس context review را ادامه بده. این ساختار اجازه نمیدهد explanation تولیدشده توسط AI بهجای runtime evidence جا زده شود.
Glossary یک control surface است، نه oracle. مستند فعلی Azure Translator glossary را برای terminology context-specific، source/target pair مشخص و review/update منظم توضیح میدهد. [S-AZ-GLOSSARY] بنابراین glossary برای constrain کردن term شناختهشده مفید است، اما از آن نمیتوان correctness کل جمله را نتیجه گرفت.
در fixture، terminology evidence از human meaning decision جدا ذخیره میشود. همچنین AI-assisted بودن candidate فقط provenance است و به خودی خود نه امتیاز مثبت correctness است نه منفی.
۵. توضیح عمیق: QA dimensionها جای هم را نمیگیرند
Accuracy و meaning. آیا target همان proposition، action، warning یا commitment source را منتقل میکند؟ مدل میتواند برای واژه چندمعنا یک sense روان اما غلط انتخاب کند. در این workflow این judgement انسانی/contextual است.
Contextual adherence. آیا wording برای surface، audience و وضعیت محصول مناسب است؟ «save» در editor با «save» در rescue context یکی نیست. review resource-level میتواند این تفاوت را نبیند.
Style و terminology. style guide لحن را محدود میکند؛ glossary termهای domain را. هر دو consistency را بهتر میکنند اما semantic review نیستند. Microsoft style-guide adherence، terminology/vocabulary و consistency را dimensionهای جدا در linguistic validation معرفی میکند. [S-MS-L10N-TEST]
Locale-specific formatting. date، number، currency، name و دادههای مشابه باید طبق contract محصول برای target locale نمایش داده شوند. fixture expected/observed value صریح دارد تا learner evidence محلی بدهد بدون اینکه ادعا کند همه platformها و localeها آزمایش شدهاند.
Structural integrity. variableها و tokenهای protected باید حفظ شوند؛ این property مکانیکی برای automation مناسب است.
Language/direction metadata. natural-language string در transport/UI به metadata مناسب نیاز دارد، مخصوصاً در bidirectional text. باز هم metadata برابر linguistic approval نیست.
۶. Structural check: لازم اما عمداً ناکافی
Automated QA وقتی ارزش دارد که درباره یک property محدود دقیق باشد. Lab placeholderهای {amount} و {date} را از source و candidate استخراج میکند. اگر placeholder لازم حذف شده باشد، checker میتواند بدون قضاوت درباره طبیعی بودن آلمانی، review را block کند. همین منطق برای forbidden term در scope مشخص، locale-format mismatch تعریفشده در fixture و RTL metadata لازم استفاده میشود.
checker نباید به linguistic judge جعلی تبدیل شود. quality score جهانی نمیدهد، cultural appropriateness را از language tag حدس نمیزند و فقط بهخاطر green بودن checkهای مکانیکی candidate را accept نمیکند. خروجی آن observation است که reviewer کنار context evidence استفاده میکند.
این boundary در AI-assisted workflow مهمتر است. AI میتواند candidate بدهد یا issueهای احتمالی را خلاصه کند، ولی evidence record باید generated output را از observed test جدا کند. NIST Generative AI Profile همچنان riskهایی مثل confabulated content و اعتماد نامناسب به خروجی تولیدی را در governance مطرح میکند. [S-NIST-GAI] استفاده محدود این درس از آن authority فقط همین است: fluency یا confidence مدل جای evidence ثبتشده را نمیگیرد.
۷. محدودیت Glossary و قانون AI candidate
Glossary برای termهای محصول بسیار مفید است: brand ترجمه نشود، واژه ambiguous sense مشخص داشته باشد یا یک feature term تنها ترجمه approved داشته باشد. در fixture، Product Alpha برای آلمانی Projektbereich را لازم و Arbeitsbereich را forbidden میکند. candidate با synonym قدیمی حتی اگر grammar عالی داشته باشد، terminology QA را رد میکند.
اما glossary فقط یک dimension است. جمله Projektbereich löschen term درست دارد ولی اگر source intent «archive workspace» باشد، meaning غلط است. Glossary intent محصول را نمیفهمد مگر context جداگانه وارد review شود. به همین علت artifact هم terminology و هم source intent را ثبت میکند.
AI-assisted review نیز همین rule را دارد. AI بعد از بیان governing contract میتواند check پیشنهاد دهد، inconsistency را flag کند یا observationها را خلاصه کند. اما نباید runtime evidence، citation، reviewer approval یا owner decision جعل کند. agreement بین دو مدل نیز evidence authoritative نیست. human decision باید در artifact نقش، دلیل و evidence داشته باشد.
۸. مثال کامل: هشت message و پنج failure class
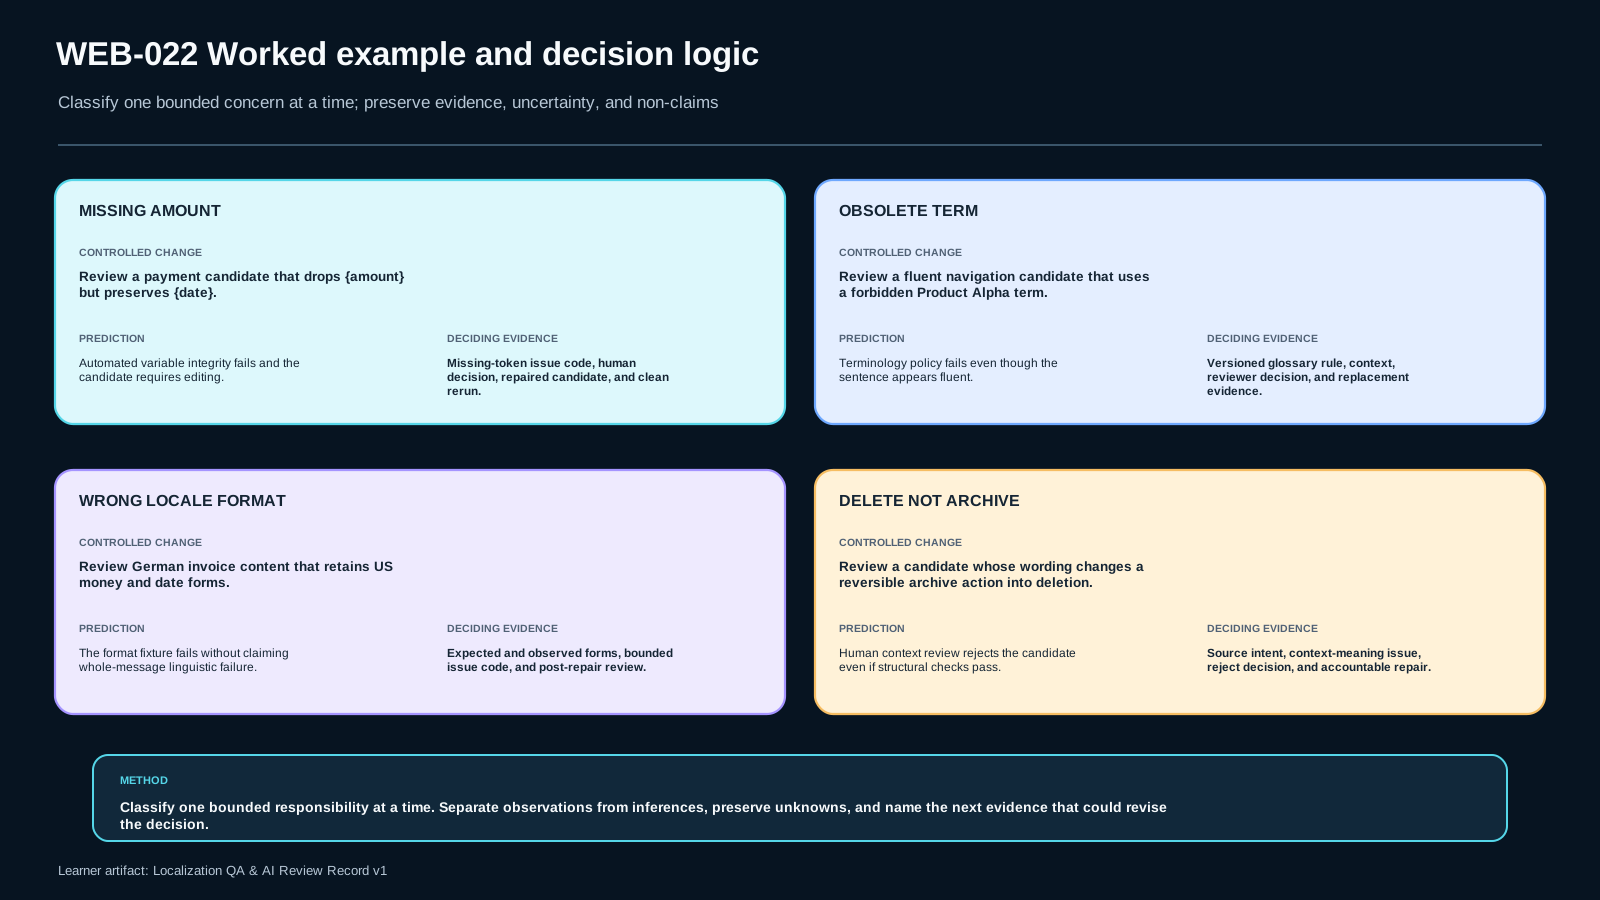
Release قطعی این lab هشت message دارد. M-001 variable {amount} را در candidate آلمانی حذف میکند. M-002 term قدیمی ممنوع را دارد. M-003 meaning را نگه میدارد اما date/currency را با presentation source locale نمایش میدهد. M-004 آلمانی روان دارد ولی action را بهدلیل نادیده گرفتن context اشتباه ترجمه میکند. M-005 candidate عربی است که direction metadata لازم را ندارد. M-006، M-007 و M-008 comparison caseهای clean هستند که با وجود clean بودن، human review ثبتشده میخواهند.
برای M-001 observation برابر placeholder mismatch است؛ decision درست EDIT_REQUIRED و evidence باید code missing-token را داشته باشد. برای M-004 ممکن است تمام structural checkها PASS باشند. observation تعیینکننده context است: source intent میگوید workspace باید archive شود اما candidate delete را میگوید. اینجا authority human review است نه checker.
برای M-005 candidate عربی است و transport fixture dir=rtl ندارد. checker metadata risk را ثبت میکند. repair metadata صریح را برمیگرداند و rerun میشود. residual limitation میگوید این fixture رفتار rendering را در همه browser/hostها ثابت نمیکند.
۹. Failure modeهای مهم
Fluency-as-proof: candidate context-wrong فقط چون طبیعی است accept شود.
Green-check overreach: همه structural checkها سبز باشند و system بدون contextual review auto-accept کند.
Glossary absolutism: وجود همه termهای approved بهعنوان proof کل sentence استفاده شود.
Generated-evidence laundering: AI بنویسد «در production تست شد» یا reviewer approval جعل کند.
Locale-format shortcut: $1,234.50 و 09/14/2026 در UI آلمانی بماند ولی review فقط «translation correct» ثبت کند.
RTL heuristic dependence: string عربی بدون metadata صریح بهخاطر یک screenshot ظاهراً خوب ship شود.
Single-reviewer universalization: review یک locale برای همه localeها و audienceها proof تلقی شود.
هر failure یک boundary متفاوت را میشکند؛ به همین دلیل یک score واحد diagnosis خوبی نیست.
۱۰. پل experienced و trade-offها
سؤال عملی تیمها این است: localization QA platform بخریم، model-based review اضافه کنیم یا linting خودمان را بسازیم؟ این درس vendor تعیین نمیکند؛ invariant آن evidence boundary است.
Static lint برای variable، syntax، protected term و policy قطعی عالی است و روی هر build ارزان اجرا میشود؛ ضعف آن semantic blindness است.
Model-assisted review میتواند triage را scale کند و wording مشکوک را flag کند؛ ضعف آن این است که میتواند با confidence غلط باشد، context محصول را از دست بدهد و explanation شبیه evidence بسازد. پس خروجی model تا زمان verification فقط candidate observation/suggestion است.
Human in-context review جایی قوی است که meaning، tone، legal sensitivity، audience و رفتار محصول مهماند. هزینه و variance بیشتری دارد، پس باید source intent، product access/screenshot، terminology، issue taxonomy و decision record ساختاریافته بدهیم. Microsoft نیز in-context review و resourceهای reviewer را توصیه میکند. [S-MS-L10N-TEST]
workflow بالغ این mechanismها را ترکیب میکند و هیچکدام را وادار نمیکند نقش دیگری را جعل کند.
۱۱. تمرین هدایتشده، mutation و transfer مستقل
اول contract را بخوانید و سپس data را. برای defectهای injectشده failure code پیشبینی کنید. python3 run_checks.py را اجرا کنید. PASS baseline یعنی workflow defectها را درست تشخیص داده و decision accountable ثبت کرده؛ به این معنی نیست که raw candidateها بدون defect هستند.
سپس mutationها را انجام دهید: missing-token message را بدون repair ACCEPT کنید؛ forbidden terminology را accept کنید؛ source-locale format را acceptable علامت بزنید؛ context-wrong candidate را accept کنید؛ RTL metadata را حذف کنید و بازهم approval بدهید. هر mutation باید audit را با code مورد انتظار fail کند. بعد decision/evidence درست را restore و rerun کنید.
Transfer مستقل risk را تغییر میدهد. یک release-note notification wording حساس حقوقی دارد و دو locale جدید fr-FR و es-MX اضافه میکند. learner باید review path سختگیرانهتری طراحی کند: structural checkها باقی بمانند، برای بخش حساس second accountable reviewer یا legal/product owner اضافه شود و صریحاً گفته شود automation meaning یا legal correctness را ثابت نمیکند. decisive solution نباید از baseline کپی یا توسط AI تحویل داده شود.
۱۲. Verification و evidence record
Record خوب باید به reviewer دوم اجازه دهد دلیل decision را بازسازی کند. برای هر message، source intent، candidate، automated findings، terminology rule، locale-format observation، context note، lang/dir evidence، human decision، reviewer role و residual limitation ذخیره کنید.
Mutation evidence شامل prediction، observed issue code، diagnosis، repair و rerun است. اگر code مورد انتظار ظاهر نشد، detection ثابت نشده است. اگر repair rowهای نامرتبط را تغییر دهد، causal evidence ضعیف است.
Fact و conclusion را جدا کنید. «placeholder set candidate فقط {date} است اما source {amount,date} میخواهد» observation است. «amount substitution از بین میرود» inference محدود است. EDIT_REQUIRED accountable decision است. «کل localization آلمانی درست است» generalization unsupported است.
Residual limitation اجباری است: این lab به Azure Translator وصل نمیشود، live LLM evaluation انجام نمیدهد، competence reviewer یا legal approval را ثابت نمیکند و cross-host rendering را اثبات نمیکند. هدف آن اثبات method review و failure boundary در fixture محلی است.
۱۳. Assessment، transfer و freshness boundary
برای بستن درس باید core contract و یک non-goal را بیان کنید، workflow محدود را اجرا کنید، یک mutation را diagnose کنید، جداسازی automation از human judgment را دفاع کنید و changed-context حساس حقوقی را مستقل حل کنید.
Failureهای blocking شامل accept کردن candidate structurally defective، تبدیل glossary به proof کل جمله، جایگزینی context review با model score، جعل evidence/reviewer approval یا generalize کردن یک locale/reviewer به universal correctness است.
source boundary دقیقاً همین چهار authority است. S-MS-L10N-TEST راهنمای جاری Microsoft localization testing است. S-AZ-GLOSSARY راهنمای فعلی Azure Translator glossary است که در ژوئن ۲۰۲۶ بهروزرسانی شده و همچنان تعریف دقیق و review منظم glossary را توصیه میکند. S-NIST-GAI فقط برای risk محدود اعتماد به generated output استفاده میشود. S-W3C-STRINGMETA First Public Working Draft مورخ 16 July 2026 است؛ پس guidance evolving است و بهعنوان Recommendation نهایی معرفی نمیشود. [S-MS-L10N-TEST] [S-AZ-GLOSSARY] [S-NIST-GAI] [S-W3C-STRINGMETA]
نزدیکترین review_due برابر 2026-10-17 است چون vendor glossary guidance tool-volatile است. freshness update میتواند claim جاری را narrow/update کند اما حق ندارد scope WEB-022 را به data-model درس قبل یا relational-modeling درس بعد گسترش دهد.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
WEB-022-S1 retrieval
WEB-022-S2 application
WEB-022-S3 diagnosis
WEB-022-S4 decision
WEB-022-S5 transfer
ملاکهای ارزیابی (rubric)
Projection source: accepted [admin-only reference omitted] assessment rubric; no new acceptance semantics are introduced.
Critical dimensions:
- contract correctness — Implementation and explanation preserve the owned technical/behavioral contract.
- evidence quality — Observed evidence, mutation and repair are traceable and do not rely on architecture labels or appearance alone.
- scope discipline — Adjacent lesson outcomes and unsupported generalizations are explicitly deferred.
- transfer independence — Changed-context task is solved without decisive scaffold.
Blocking assessments: S2, S3 and S5. Internal synthetic oracle material remains admin/audit-only.
منابع و تازگی
مطالعهٔ موارد (case studies)
فایلهای آزمایشگاه
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)