بازگشت به مهندسی مدرن و کار با هوش مصنوعی · فصل صفر — جای خودت را در مسیر پیدا کن · 3
هوش مصنوعی در برنامهنویسی چه کارهایی میتواند انجام دهد و چه چیزهایی را نباید به آن بسپاریم؟
مرز توانمندی AI و مسئولیت انسانی را نمیشناسد و ممکن است تولید نامزد را با قضاوت مهندسی اشتباه بگیرد. میتواند برای یک کار محدود مشخص کند AI چه چیزی پیشنهاد دهد و انسان چه چیزی را باید اثبات یا تأیید کند.
What Can AI Do in Programming—and What Should You Not Delegate to It? — en-US
خلاصهٔ درس
مرز توانمندی AI و مسئولیت انسانی را نمیشناسد و ممکن است تولید نامزد را با قضاوت مهندسی اشتباه بگیرد.
میتواند برای یک کار محدود مشخص کند AI چه چیزی پیشنهاد دهد و انسان چه چیزی را باید اثبات یا تأیید کند.
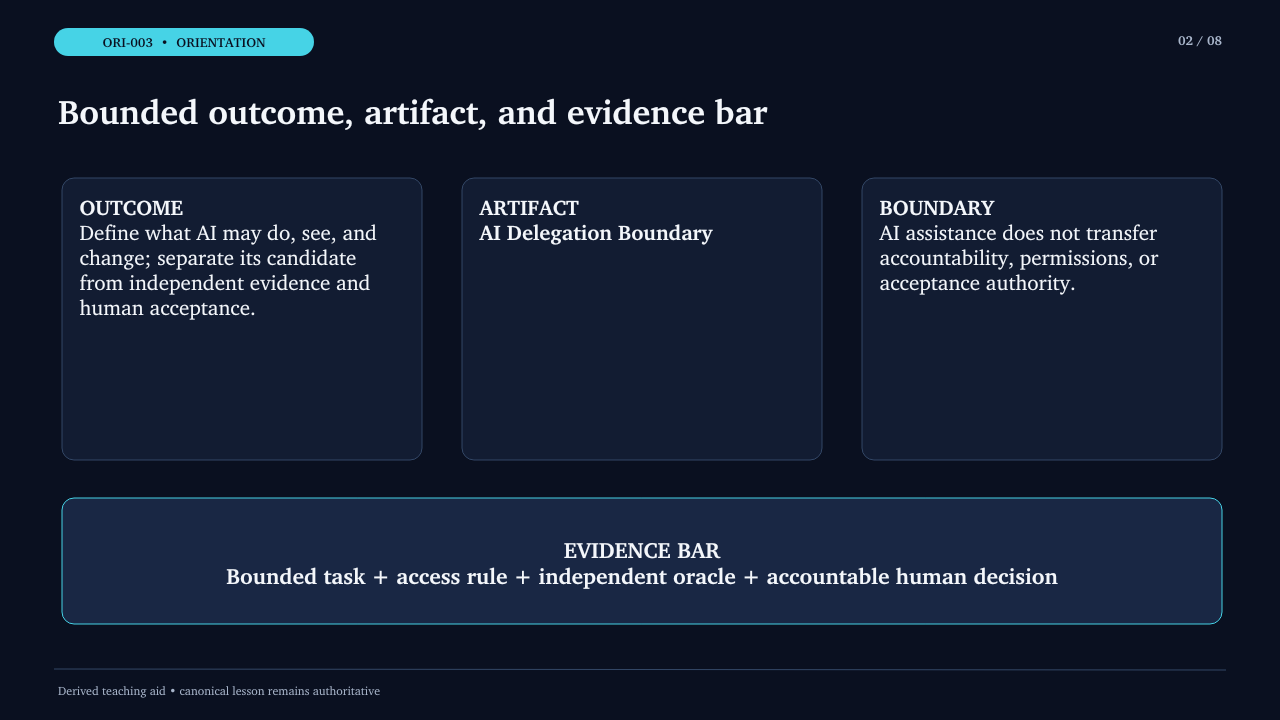
خروجی این درس
میتواند برای یک کار محدود مشخص کند AI چه چیزی پیشنهاد دهد و انسان چه چیزی را باید اثبات یا تأیید کند.
پیشنیازها
این درس پیشنیازی ندارد؛ نقطهی شروع است.
هوش مصنوعی میتواند خیلی سریع یک راهحل، قطعهکد، تست، توضیح یا چند گزینهٔ جایگزین پیشنهاد کند. همین سرعت یک خطر هم دارد: پیشنهاد خوب را با تصمیم درست یکی بگیریم. ممکن است خروجی از نظر ظاهر قانعکننده باشد، اما هنوز معلوم نباشد با نیاز واقعی، محدودیتهای سیستم، دادههای مجاز و معیار پذیرش ما سازگار است یا نه.
هدف این درس ساختن یک فهرست دائمی از «کارهایی که AI میتواند یا نمیتواند انجام دهد» نیست. چنین فهرستی با ابزارها عوض میشود. هدف، ساختن یک مرز تصمیم پایدارتر است: برای یک کار محدود، مشخص کنی AI چه چیزی میتواند بهعنوان نامزد پیشنهاد دهد، چه چیزی باید مستقل بررسی شود، و تصمیم نهایی و مسئولیت پذیرش دست چه کسی میماند. خروجی تو یک مرز واگذاری به هوش مصنوعی یا AI Delegation Boundary است.
مسئله این نیست که AI «میتواند»؛ مسئله این است که چه چیزی را حق داری از روی خروجی آن بپذیری
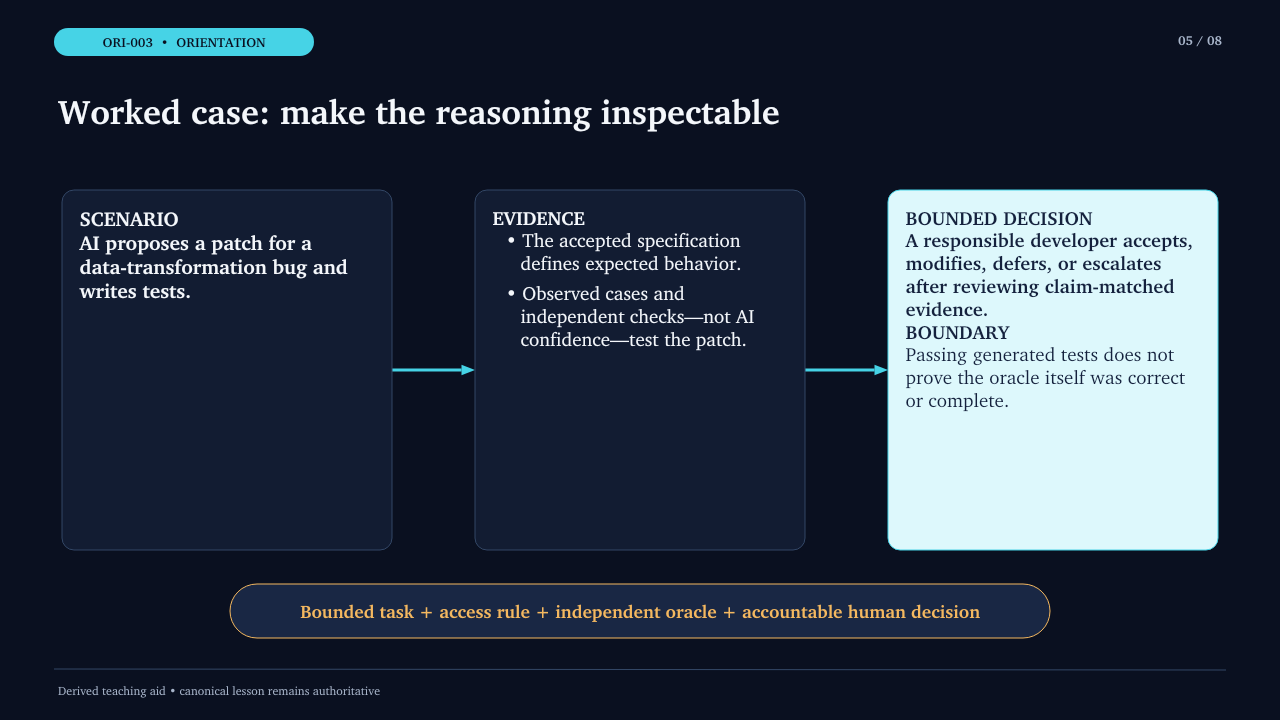
فرض کن از AI میخواهی یک باگ را اصلاح کند. مدل یک patch میدهد، توضیحش منطقی به نظر میرسد و حتی چند تست هم تولید میکند. آیا حالا باید تغییر را بپذیری؟ نه هنوز. سه چیز از هم جدا هستند:
- نامزد (Candidate): چیزی که AI پیشنهاد یا تولید کرده است؛
- شاهد (Evidence): چیزی که واقعاً ادعای موردنظر را میسنجد؛
- تصمیم پذیرش: قضاوتی که بر اساس شاهد و محدودیتها میگوید تغییر پذیرفته، اصلاح، متوقف یا به بررسی دیگری ارجاع شود.
در یک کار محدود، AI میتواند در تولید نامزد، پیدا کردن گزینهها، خلاصهکردن اطلاعاتی که در اختیارش گذاشتهای یا پیشنهاد آزمون کمک کند. اما نباید خروجی خودش را بهعنوان دلیل کافی برای درستبودن همان خروجی بپذیری. اگر patch و test هر دو یک فرض اشتباه مشترک داشته باشند، «دو خروجی AI» لزوماً دو شاهد مستقل نیستند.
مرز واگذاری تو باید روشن کند:
- دقیقاً چه outcome محدودی میخواهی؟
- AI اجازه دارد چه کاری انجام دهد و به چه context یا ابزاری دسترسی داشته باشد؟
- چه خروجیای فقط یک نامزد است؟
- معیار یا شاهد مستقل پذیرش چیست؟
- چه کسی تصمیم نهایی را میگیرد و مسئول پیامد آن است؟
این درس ثابت نمیکند که یک مدل خاص همیشه خوب یا بد است، و تسلط فنی یا آمادگی شغلی تو را هم ثابت نمیکند.
بهجای «AI برای این کار خوب است یا نه؟» سؤال را محدود کن
جملههایی مثل «AI برای برنامهنویسی خوب است» یا «نباید به AI اعتماد کرد» برای تصمیم مهندسی خیلی کلیاند. یک ابزار ممکن است برای تولید چند گزینه مفید باشد، اما همان خروجی برای پذیرش نهایی کافی نباشد. همچنین ممکن است سطح دسترسی ابزار، ریسک تصمیم را کاملاً تغییر دهد.
واحد تصمیم را کوچک کن. بهجای «کدنویسی»، بگو:
«برای این تابع محدود، AI میتواند skeleton پیشنهاد دهد؛ رفتار مورد انتظار از specification میآید؛ پذیرش فقط وقتی انجام میشود که تستها و بررسیهای مربوط به همان رفتار عبور کنند و من تصمیم را تأیید کنم.»
یا:
«برای این تغییر حساس، AI فقط اجازهٔ مشاهدهٔ بخش محدود و غیرحساس context را دارد و حق اعمال تغییر مستقیم ندارد؛ خروجی آن صرفاً پیشنهاد است.»
موضوع اصلی توان بالقوهٔ مدل نیست. موضوع اصلی مرز authority و شواهد لازم برای تصمیم است.
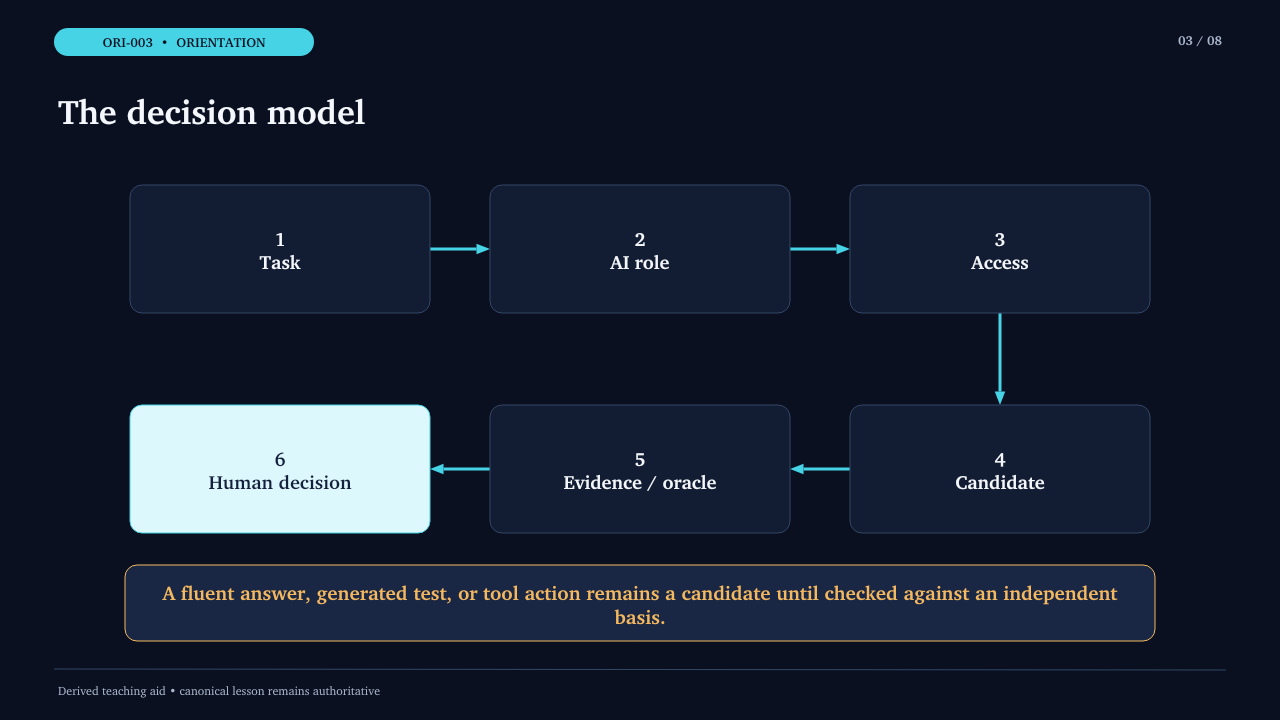
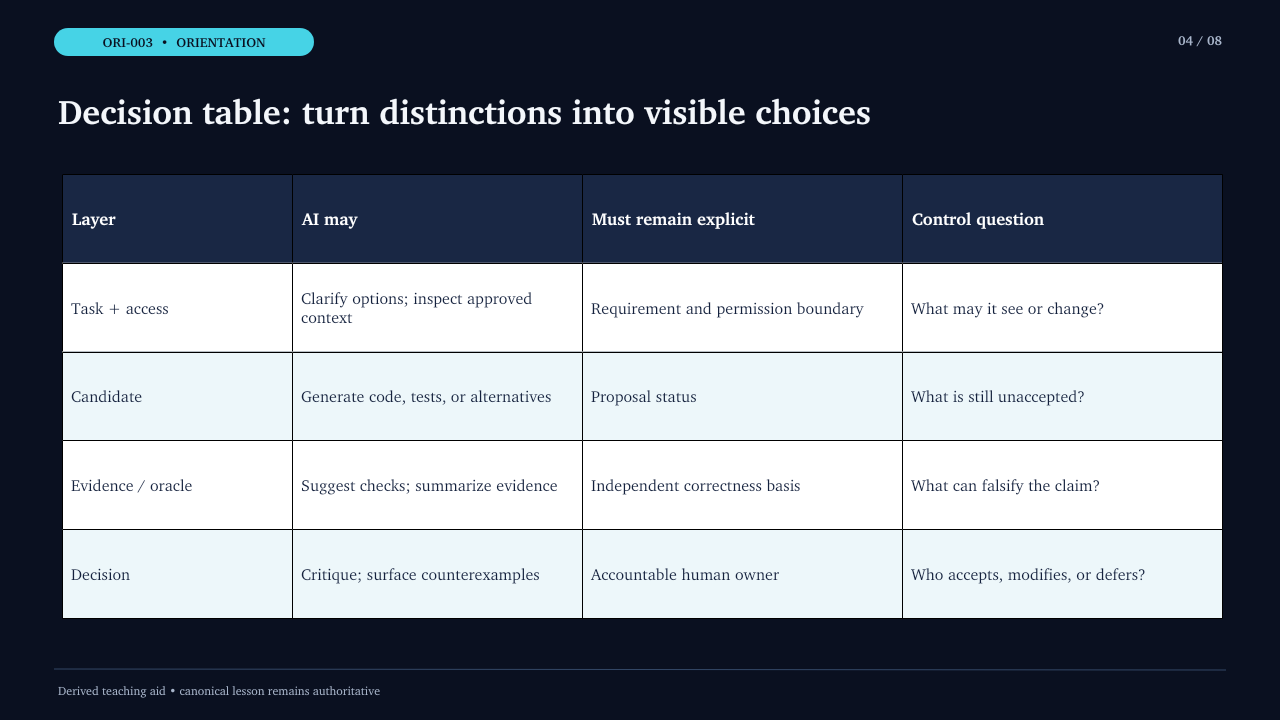
مدل تصمیم: Task → AI Role → Access → Candidate → Evidence → Human Decision
مرز واگذاری به AI را با شش سؤال بساز.
۱) Task: نتیجهٔ محدود چیست؟
دقیق بنویس چه کاری قرار است انجام شود. «بهبود کد» مبهم است. «کاهش تکرار در این تابع بدون تغییر رفتار observable آن» قابلبررسیتر است.
اگر outcome مبهم باشد، هیچ تست یا review نمیتواند بهتنهایی روشن کند چه چیزی واقعاً باید پذیرفته شود.
۲) AI Role: AI قرار است چه نقشی داشته باشد؟
نقش میتواند تولید نامزد، پیشنهاد چند گزینه، توضیح کد، خلاصهکردن شواهد موجود، یافتن counterexample یا پیشنهاد تست باشد. نقش را از authority جدا کن. «میتواند پیشنهاد دهد» با «میتواند تصمیم را نهایی کند» یک چیز نیست.
۳) Access: ابزار چه چیزی را میتواند ببیند یا تغییر دهد؟
سه حالت ساده برای فکرکردن مفید است:
- بدون ابزار: AI به محیط واقعی دسترسی ندارد و فقط بر اساس context دادهشده پیشنهاد میدهد.
- Read-only: میتواند اطلاعات مجاز را ببیند یا بخواند، اما چیزی را تغییر نمیدهد.
- Write-capable: میتواند تغییر ایجاد کند یا عملی را اجرا کند.
هرچه اثرپذیری محیط بیشتر شود، لازم است محدودهٔ context، سطح دسترسی، امکان بازگشت و معیار پذیرش روشنتر باشد. این به معنی «همیشه ممنوعکردن write access» نیست؛ یعنی access باید متناسب با outcome و ریسک همان کار تعیین شود.
۴) Candidate: چه چیزی هنوز فقط پیشنهاد است؟
کد، تست، توضیح، migration plan، query، refactor یا گزارش AI تا وقتی با معیار مستقل سنجیده نشده، نامزد است. ظاهر تمیز، توضیح مطمئن یا تعداد زیاد تستها این وضعیت را خودکار عوض نمیکند.
۵) Evidence و Oracle: از کجا میفهمیم خروجی مناسب است؟
Evidence چیزی است که ادعای مشخص را میسنجد: رفتار اجراشده، تست مرتبط، قرارداد interface، specification پذیرفتهشده، invariant، log قابلاعتماد، compiler/type checker یا review انسانی، بسته به نوع ادعا.
در این درس Oracle یعنی مرجع یا قاعدهای که برای یک claim مشخص به ما میگوید نتیجهٔ درست چه باید باشد. Oracle ممکن است specification، expected output موردتوافق، یک invariant یا یک منبع authoritative باشد. AI نباید فقط با تکرار یا تأیید خروجی خودش، «oracle خودش» شود.
شاهد باید با claim جور باشد. عبور unit test نشان نمیدهد امنیت کل سیستم اثبات شده؛ compileشدن هم نشان نمیدهد رفتار محصول درست است.
۶) Human Decision: چه کسی قبول، اصلاح، توقف یا ارجاع را تأیید میکند؟
مسئولیت انسانی یعنی انسان لازم نیست همهٔ کارها را دستی انجام دهد. میتوانی از تست، ابزار تحلیل، CI و review کمک بگیری. اما معیار پذیرش، تفسیر شواهد و تصمیم نهایی پذیرش نباید صرفاً به همان مولدی سپرده شود که نامزد را ساخته است.
برای تصمیمهای پرریسک، ممکن است مالکیت تصمیم بین چند نقش تقسیم شود؛ مثلاً توسعهدهنده، reviewer یا مالک محصول. مهم این است که ownership واقعی و قابلپیگیری باشد.
یک «مرز واگذاری» قابلبررسی بساز
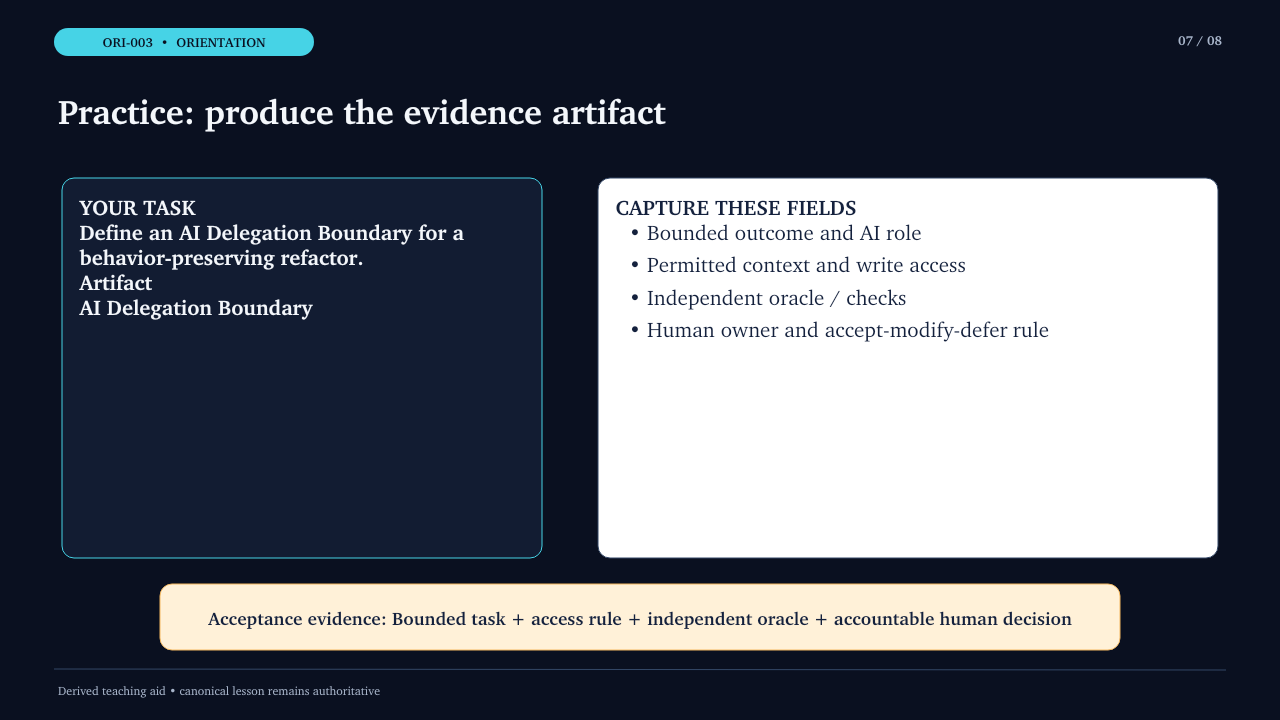
برای هر task یک ردیف با این فیلدها بساز:
| فیلد | چیزی که ثبت میکنی |
|---|---|
| Task / Outcome | نتیجهٔ محدود و قابلبررسی |
| AI Role | پیشنهاد، تولید نامزد، critique، خلاصهسازی یا نقش دیگر |
| Context / Access | چه چیزی مجاز است ببیند یا تغییر دهد |
| Candidate Output | خروجیای که هنوز فقط نامزد است |
| Acceptance Evidence | شاهد یا oracle مستقل برای claim موردنظر |
| Human Decision Owner | چه کسی تصمیم نهایی را تأیید میکند |
| Failure / Rollback | اگر نامزد بد بود چه چیزی متوقف یا برگردانده میشود |
| Claim Boundary | این پذیرش چه چیزی را ثابت نمیکند |
| Update Condition | چه شاهد یا تغییر context مرز را عوض میکند |
دو قانون مهم:
قانون اول: ابزار را به task محدود کن، نه task را به توان تبلیغشدهٔ ابزار. اگر برای outcome فقط read-only کافی است، write access خودکار لازم نیست.
قانون دوم: شواهد پذیرش را قبل از شیفتهشدن به candidate تعریف کن. اگر معیار فقط بعد از دیدن پاسخ ساخته شود، خطر این وجود دارد که ناخودآگاه معیار را با خروجی هماهنگ کنی.
چرا «AI هم کد بنویسد هم تست» همیشه verification مستقل نمیسازد؟
فرض کن requirement میگوید ورودی خالی باید خطای مشخصی برگرداند. AI patchای مینویسد که ورودی خالی را به یک لیست خالی تبدیل میکند. سپس تستی هم تولید میکند که دقیقاً همین رفتار را انتظار دارد. patch و test با هم سازگارند، اما هر دو یک برداشت اشتباه مشترک از requirement دارند.
مشکل اینجا «AI بودن» تست نیست؛ مشکل وابستگی منبع استدلال است. اگر candidate و check از همان فرض اشتباه ساخته شده باشند، زیادشدن تعداد checkها اعتماد مستقل ایجاد نمیکند.
برای شکستن این حلقه، بخشی از oracle یا معیار پذیرش باید از چیزی بیرون از همان تولیدکننده بیاید: specification تأییدشده، test caseهای از قبل تعریفشده، invariant روشن، رفتار مرجع، یا review مستقلی که claim را از ابتدا میسنجد.
مسئولیت انسانی یعنی ownership، نه انجام دستی همهچیز
ممکن است هزاران تست خودکار اجرا شوند و هیچ انسانی تکتک آنها را نخواند. این همچنان میتواند evidence معتبر باشد، اگر بدانیم تستها چه claimی را میسنجند و چه چیزهایی را نمیسنجند. نقش انسانی این است که مرز claim، کف evidence و واکنش به شکست را مالک باشد.
context هم بخشی از تصمیم است
گاهی مدل از نظر فنی میتواند روی اطلاعات بیشتری کار کند، اما تو مجاز نیستی همهٔ آن context را به ابزار بدهی. دادهٔ حساس، secret، اطلاعات مشتری یا بخشهای نامرتبط باید فقط در حد نیاز وارد task شوند. «قادر بودن» ابزار، مجوز استفاده از هر داده یا هر access را ایجاد نمیکند.
سه مثال: تولید نامزد را از authority جدا کن
مثال اول: skeleton کد، رفتار از specification
قرار است یک تابع کوچک برای تبدیل داده ساخته شود. requirement ورودی، خروجی و دو حالت خطا را مشخص کرده است. AI میتواند skeleton، نامگذاریهای پیشنهادی و حتی چند test candidate بسازد.
مرز درست:
- AI Role: تولید candidate؛
- Oracle: specification و expected behavior تأییدشده؛
- Evidence: تستهای مرتبط با requirement و بررسی رفتار واقعی؛
- Decision Owner: توسعهدهنده یا reviewer مسئول؛
- Non-claim: عبور این تستها، کیفیت کل معماری یا امنیت کل سامانه را ثابت نمیکند.
مثال دوم: patch و test یک اشتباه را تکرار میکنند
در یک باگ، AI هم patch مینویسد و هم تست regression. هر دو pass میشوند. اما بعد معلوم میشود test همان فرض اشتباه patch را تکرار کرده و یک حالت edge از requirement را حذف کرده است.
نتیجه این نیست که «تست AI بیارزش است». نتیجه این است که منشأ evidence باید بهاندازهٔ claim مستقل باشد. یک test پیشنهادی میتواند مفید باشد، ولی برای acceptance باید بدانیم expected behavior از کجا آمده است.
مثال سوم: دادهٔ حساس و ابزار write-capable
برای بررسی یک خطای تولید، log واقعی شامل اطلاعاتی است که برای تشخیص همهٔ آنها لازم نیست. ابزار هم قابلیت خواندن فایل و اعمال تغییر دارد.
مرز مناسب میتواند این باشد:
- context فقط به بخش لازم و مجاز محدود شود؛
- ابتدا حالت read-only برای تحلیل کافی باشد؛
- هر تغییر write-capable جداگانه ثبت و قابل بازگشت باشد؛
- پذیرش تغییر با evidence سیستم و owner مشخص انجام شود.
حتی اگر ابزار بتواند کار بیشتری انجام دهد، boundary باید از نیاز task و ریسک آن بیاید.
چهار خطای رایج در واگذاری
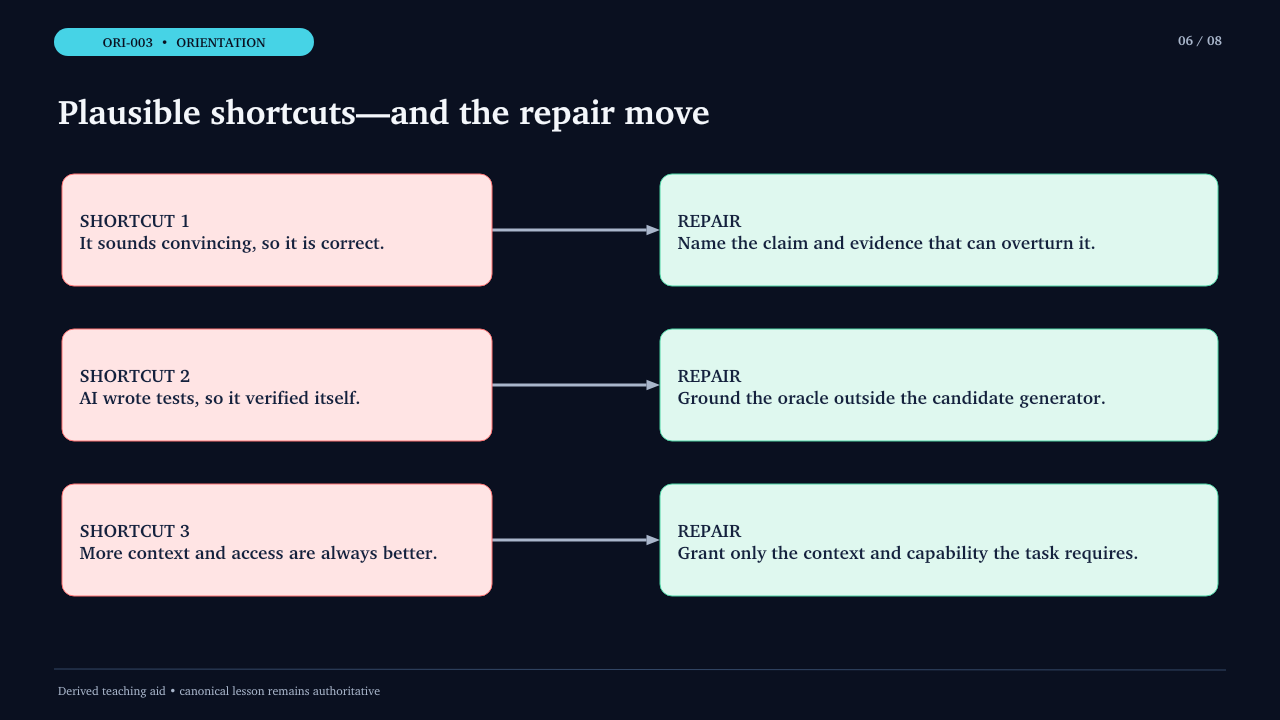
خطای اول: «چون جواب قانعکننده است، پس درست است»
اعتماد به لحن، طول توضیح یا شباهت به کد حرفهای evidence نیست.
ترمیم: claim را نام ببر و بگو چه شاهدی واقعاً آن را میسنجد.
خطای دوم: «AI test هم نوشته، پس خودش را verify کرده»
ممکن است candidate و test از یک فرض مشترک آمده باشند.
ترمیم: oracle را مستقل تعریف کن و دستکم یک check مهم را به requirement، invariant یا evidence بیرونی متصل کن.
خطای سوم: «context بیشتر همیشه بهتر است»
context اضافی ممکن است نامرتبط، حساس یا حتی گمراهکننده باشد.
ترمیم: فقط context لازم برای task را بده و access را به حداقل موردنیاز آن outcome محدود کن.
خطای چهارم: «انسان باید همهچیز را دستی بررسی کند»
این هم برداشت اشتباه است. هدف حذف automation نیست.
ترمیم: automated evidence را استفاده کن، اما owner تصمیم و claim boundary را روشن نگه دار.
اگر باتجربهای، مرز را بر اساس risk و reversibility فشردهتر کن
برای یک کار کمریسک و برگشتپذیر، ممکن است جریان مناسب این باشد: AI نامزد میسازد، تستهای از قبل موجود اجرا میشوند، diff بررسی میشود و تغییر کوچک پذیرفته میشود.
برای یک تغییر پرریسکتر، همان مدل شاید access محدودتر، evidence بیشتر، reviewer مستقل یا مرحلهٔ rollback مشخص بخواهد. تفاوت از «هوش بیشتر یا کمتر AI» نمیآید؛ از پیامد خطا، قابلیت بازگشت و کیفیت evidence موردنیاز میآید.
یک برنامهنویس باتجربه باید بتواند این trade-off را کوتاه اما صریح ثبت کند، نه اینکه صرفاً به تجربهٔ شخصی یا اعتماد به ابزار تکیه کند.
سه حالت ابزار، یک اصل ثابت
همان task را در سه وضعیت مقایسه کن:
بدون ابزار
AI به ابزار یا محیط واقعی دسترسی ندارد، اما همچنان میتواند از context دادهشده candidate یا چند گزینه تولید کند. evidence باید از مبنایی متناسب با claim بهدست بیاید؛ مثلاً specification پذیرفتهشده، check مستقل، رفتار مشاهدهشده یا review انسانی. human ownership تصمیم نهایی همچنان روشن میماند.
ابزار Read-only
AI میتواند context مجاز را بخواند، الگوها یا خطاهای محتمل را پیشنهاد کند و evidence موجود را خلاصه کند. چون چیزی را تغییر نمیدهد، ریسک mutation کمتر است؛ اما پیشنهاد هنوز authority نیست.
ابزار Write-capable
AI میتواند candidate را مستقیماً در محیط اعمال کند. این ممکن است اصطکاک را کم کند، ولی acceptance gate نباید ناپدید شود. محدودهٔ write، ثبت تغییر، reversibility و evidence باید روشن باشند.
اصل ثابت در هر سه حالت این است: تولید نامزد، جمعآوری شاهد و تصمیم پذیرش سه نقش متفاوتاند. ابزار میتواند در بیش از یکی کمک کند، اما مرز authority باید قابلدیدن بماند.
تمرین: برای یک task واقعی مرز واگذاری بساز
دور اول: outcome را محدود کن
یک task واقعی کوچک انتخاب کن؛ مثلاً «نوشتن parser کامل» خیلی بزرگ است، اما «پشتیبانی از یک format مشخص با سه حالت خطای تعریفشده» بهتر است.
دور دوم: نقش AI و access را تعیین کن
بنویس AI فقط پیشنهاد میدهد، read-only میخواند یا write-capable است. اگر بخشی از context لازم نیست، آن را وارد نکن.
دور سوم: قبل از candidate، evidence را تعریف کن
بگو برای پذیرش چه چیزی باید درست باشد. requirement، test مستقل، invariant، compile/type check، رفتار runtime یا review میتواند بخشی از evidence باشد؛ فقط claim مناسبش را مشخص کن.
دور چهارم: تصمیم و مرز ادعا را ثبت کن
بعد از دیدن evidence، یکی از این تصمیمها را بگیر: accept، modify، defer یا route for review. سپس بنویس این پذیرش چه چیزی را ثابت نمیکند.
دور پنجم: انتقال در سه context
همین task را برای سه حالت زیر بازطراحی کن:
- بدون ابزار؛
- ابزار read-only؛
- ابزار write-capable.
در هر حالت مشخص کن چه چیزی تغییر میکند و چه چیزی ثابت میماند. اگر answer فقط «AI بیشتر یا کمتر کار میکند» باشد، authority boundary هنوز کافی نیست. باید تغییر access، evidence و ownership را هم توضیح بدهی.
قبل از پذیرش، پنج سؤال بپرس
- آیا task و outcome محدود و قابلبررسیاند؟
- آیا نقش AI از decision authority جدا شده است؟
- آیا access و context فقط به اندازهٔ لازم تعریف شدهاند؟
- آیا acceptance evidence واقعاً claim را میسنجد و فقط تأیید مجدد همان candidate نیست؟
- آیا owner تصمیم، non-claim و شرط تغییر boundary روشن است؟
اگر یکی از اینها مبهم است، مرز واگذاری هنوز برای تصمیم blocking کافی نیست.
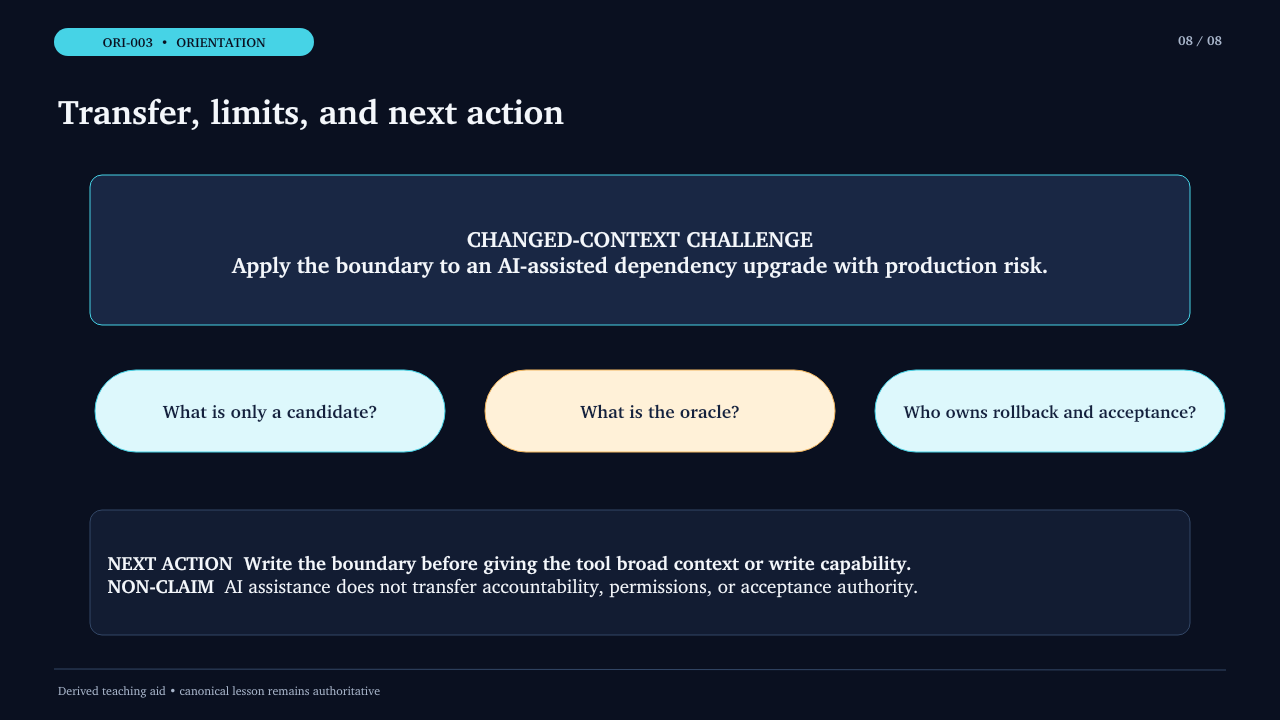
ارزیابی اصلی: boundary را در یک زمینهٔ تغییرکرده دفاع کن
در ارزیابی، یک task جدید میگیری که AI میتواند برایش candidate تولید کند. باید مشخص کنی:
- outcome محدود چیست؛
- AI چه نقشی دارد؛
- چه context/accessی مجاز است؛
- چه چیزی candidate است؛
- oracle یا evidence مستقل چیست؛
- decision owner کیست؛
- چه چیزی باعث accept، modify، defer یا escalation میشود؛
- این تصمیم چه چیزی را ثابت نمیکند.
سپس همان task را بین حالت بدون ابزار، read-only و write-capable منتقل میکنی. موفقیت در این ارزیابی فقط نشان میدهد میتوانی یک مرز واگذاری محدود و قابلدفاع بسازی؛ نه اینکه بهطور کلی در امنیت، معماری یا همهٔ کارهای برنامهنویسی مسلطی.
چرا نام مدلها و قابلیتهای روز را فهرست نمیکنیم؟
قابلیت ابزارها تغییر میکند، اما سؤال این درس پایدارتر است: چه چیزی candidate است، چه evidence لازم است و authority نهایی کجاست؟ اگر بعداً برای یک مدل، نسخه یا provider مشخص ادعای جاری وارد این درس شود، همان claim باید با منبع رسمی و تاریخ بازبینی جداگانه بررسی شود. در نسخهٔ فعلی عمداً هیچ ادعای provider-specific دربارهٔ قابلیتهای روز وارد نشده است.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
Q1 retrieval
تفاوت Candidate، Evidence و Acceptance Decision چیست؟
Q2 application
AI برای یک تابع هم patch و هم test تولید کرده و هر دو با هم سازگارند. یک AI Delegation Boundary بساز که مشخص کند چه چیزی هنوز candidate است، oracle از کجا میآید و چه evidence برای پذیرش لازم است.
Q3 diagnosis
این استدلال را عیبیابی کن: «اگر ابزار write access دارد و تغییر را خودش اعمال کرده، بهتر است خودش هم تصمیم بگیرد تغییر درست بوده.»
Q4 decision
برای یک task واقعی، مرز کامل واگذاری را بنویس: outcome، role، context/access، candidate، evidence/oracle، owner، rollback، claim boundary و update condition. سپس تصمیم accept/modify/defer/route را دفاع کن.
Q5 transfer
همان task را در سه حالت مقایسه کن: بدون ابزار، یعنی AI میتواند فقط از context دادهشده candidate پیشنهاد کند و به ابزار/محیط واقعی دسترسی ندارد؛ read-only؛ و write-capable. توضیح بده چه چیزی در access، evidence و safeguards/rollback تغییر میکند و کدام اصل authority ثابت میماند.
ملاکهای ارزیابی (rubric)
Critical dimensions
1. Decision and scope correctness — critical
The task is bounded. AI role, access, and decision authority are separated. The response does not generalize into a permanent claim about all AI tools.
2. Evidence adequacy — critical
Acceptance evidence matches the exact claim. A generated patch, explanation, or test is not treated as sufficient merely because it agrees with another output from the same reasoning path.
3. Human accountability and non-claim — critical
A named human decision owner remains responsible for the final acceptance decision. The artifact states what acceptance does not prove.
4. Transfer — critical
The learner adapts the boundary across no-tool, read-only, and write-capable modes while preserving the separation between candidate, evidence, and acceptance authority.
Blocking failure conditions
- final acceptance is delegated to the same generator without an independent acceptance basis;
- AI output is used as its own oracle;
- access is unspecified for a task where access materially changes the risk;
- decision is made without claim-relevant evidence;
- claim boundary or decision owner is missing in a blocking artifact;
- transfer treats write capability as automatic permission or automatic correctness.
Human decision policy
AI may generate candidates, propose tests, critique, summarize evidence, or perform an authorized action. Automated evidence is allowed. The final acceptance decision remains owned by an accountable human role.
What passing does not prove
Passing this lesson does not prove technical programming mastery, security mastery, architecture mastery, job readiness, or whole-program mastery.
منابع و تازگی
مطالعهٔ موارد (case studies)
تصاویر درس
نمودار مسیر Task به AI Role و Access، سپس Candidate، Evidence/Oracle و در پایان Human Decision؛ فلش بازخورد نشان میدهد شکست evidence میتواند candidate را برای اصلاح برگرداند.
Where are candidate generation, evidence/oracle, and human decision separated?
سه ستون بدون ابزار، read-only و write-capable؛ در هر سه، Candidate، Evidence/Oracle و Human Decision از هم جدا میمانند. با تغییر حالت، access، mutation risk، safeguards/rollback و در صورت نیاز نوع یا آستانهٔ Evidence متناسب با claim تغییر میکند.
What changes between no-tool, read-only, and write-capable modes, and what authority principle remains invariant?
اسکریپت ویدیوی اختیاری
سناریو
AI یک patch و چند test میدهد. سؤال ویدئو این نیست که «AI خوب بود یا بد؟»؛ سؤال این است که چه چیزی هنوز Candidate است و پذیرش از چه Evidenceای میآید.
مدل
Task را محدود میکنیم، Role و Access را مینویسیم، Candidate را جدا نگه میداریم، Oracle را از specification یا invariant میگیریم و Decision Owner را مشخص میکنیم.
خطای قابلباور
Patch و test هر دو یک برداشت غلط از requirement دارند. passشدن test فقط سازگاری این دو را نشان میدهد، نه درستبودن requirement interpretation را.
ترمیم
Expected behavior را از مرجع مستقل میگیریم و check را به همان claim متصل میکنیم.
انتقال
همین task را در حالت بدون ابزار، read-only و write-capable مقایسه میکنیم. Access تغییر میکند، اما جدایی Candidate، Evidence و Human Decision ثابت میماند.
موفقیت در این تمرین، تسلط کلی برنامهنویسی یا امنیت را ثابت نمیکند.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)