امنیت، هویت، استقرار و تابآوری · فصل ۷ — Dependency، Contract، Event و Network Failure · 117
Network Partition
failure را بعد از وقوع و بهصورت موردی تحلیل میکند و هنوز detection، containment و repair path از قبل طراحی نشده است. موضوع جاری: «Network Partition». میتواند failure family «Network Partition» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
خلاصهٔ درس
failure را بعد از وقوع و بهصورت موردی تحلیل میکند و هنوز detection، containment و repair path از قبل طراحی نشده است. موضوع جاری: «Network Partition».
میتواند failure family «Network Partition» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
خروجی این درس
میتواند failure family «Network Partition» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
1. Timeout فقط یک مشاهده است، نه حکم علت
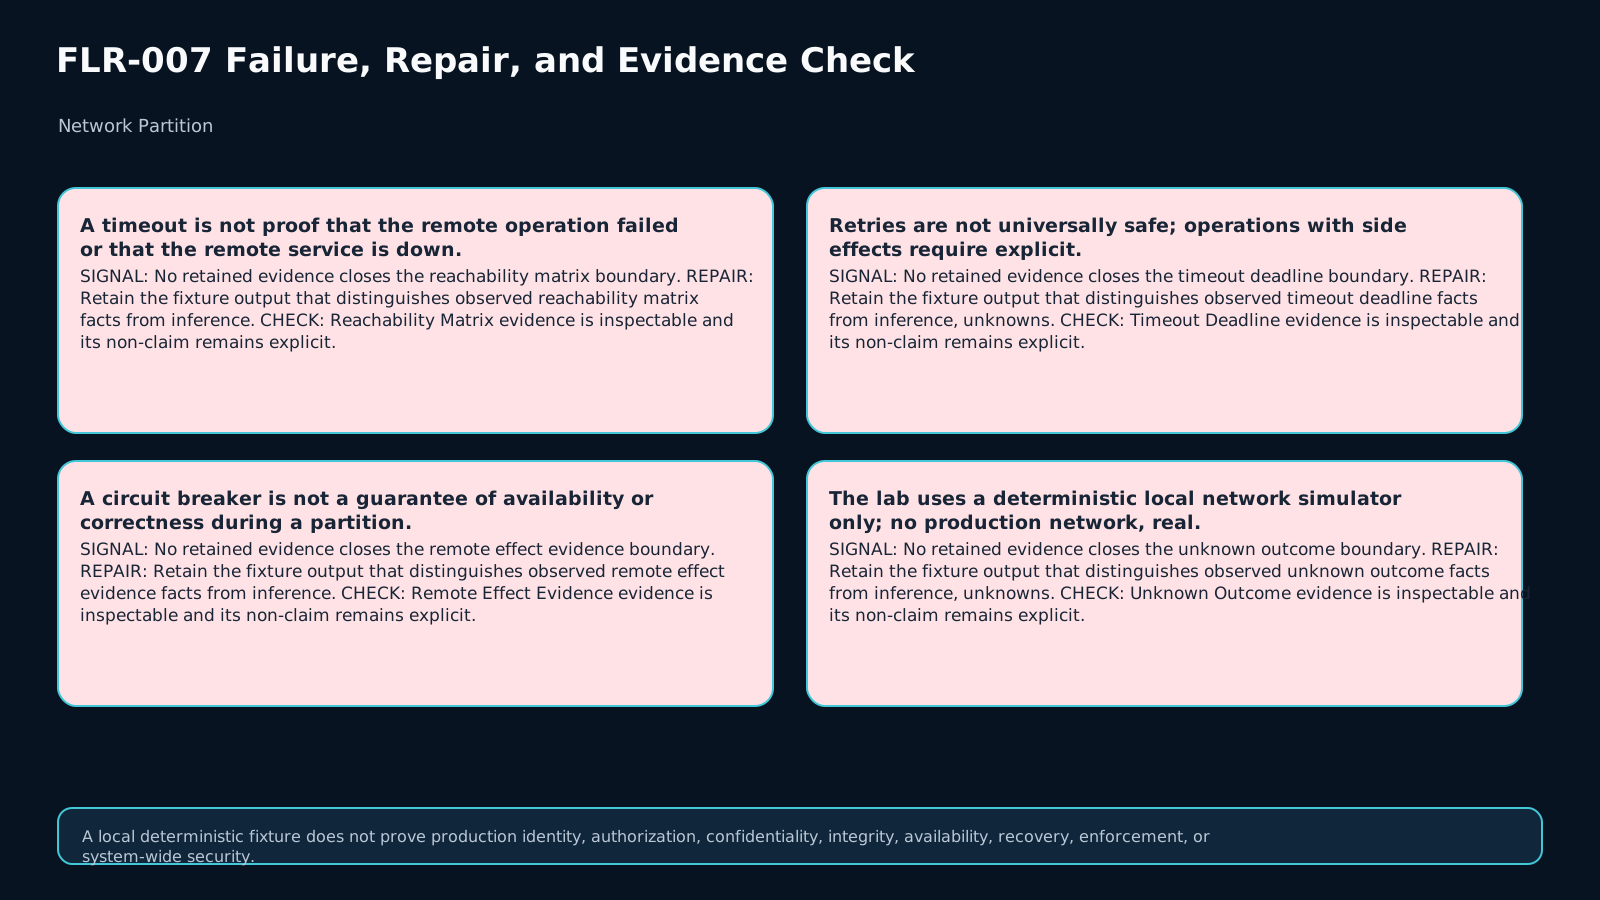
در یک سیستم توزیعشده، caller ممکن است timeout ببیند در حالی که درخواست اصلاً نرسیده، رسیده ولی پاسخ برنگشته، یا operation در remote side انجام شده اما نتیجه به caller نرسیده است. AWS این مرز را بهعنوان حالت «UNKNOWN» در network operation توضیح میدهد. [AWS-DISTSYS] پس اولین قاعده این درس این است: timeout را با remote failure یا remote non-execution یکی نکنید.
2. Partition را بهصورت reachability matrix ببینید
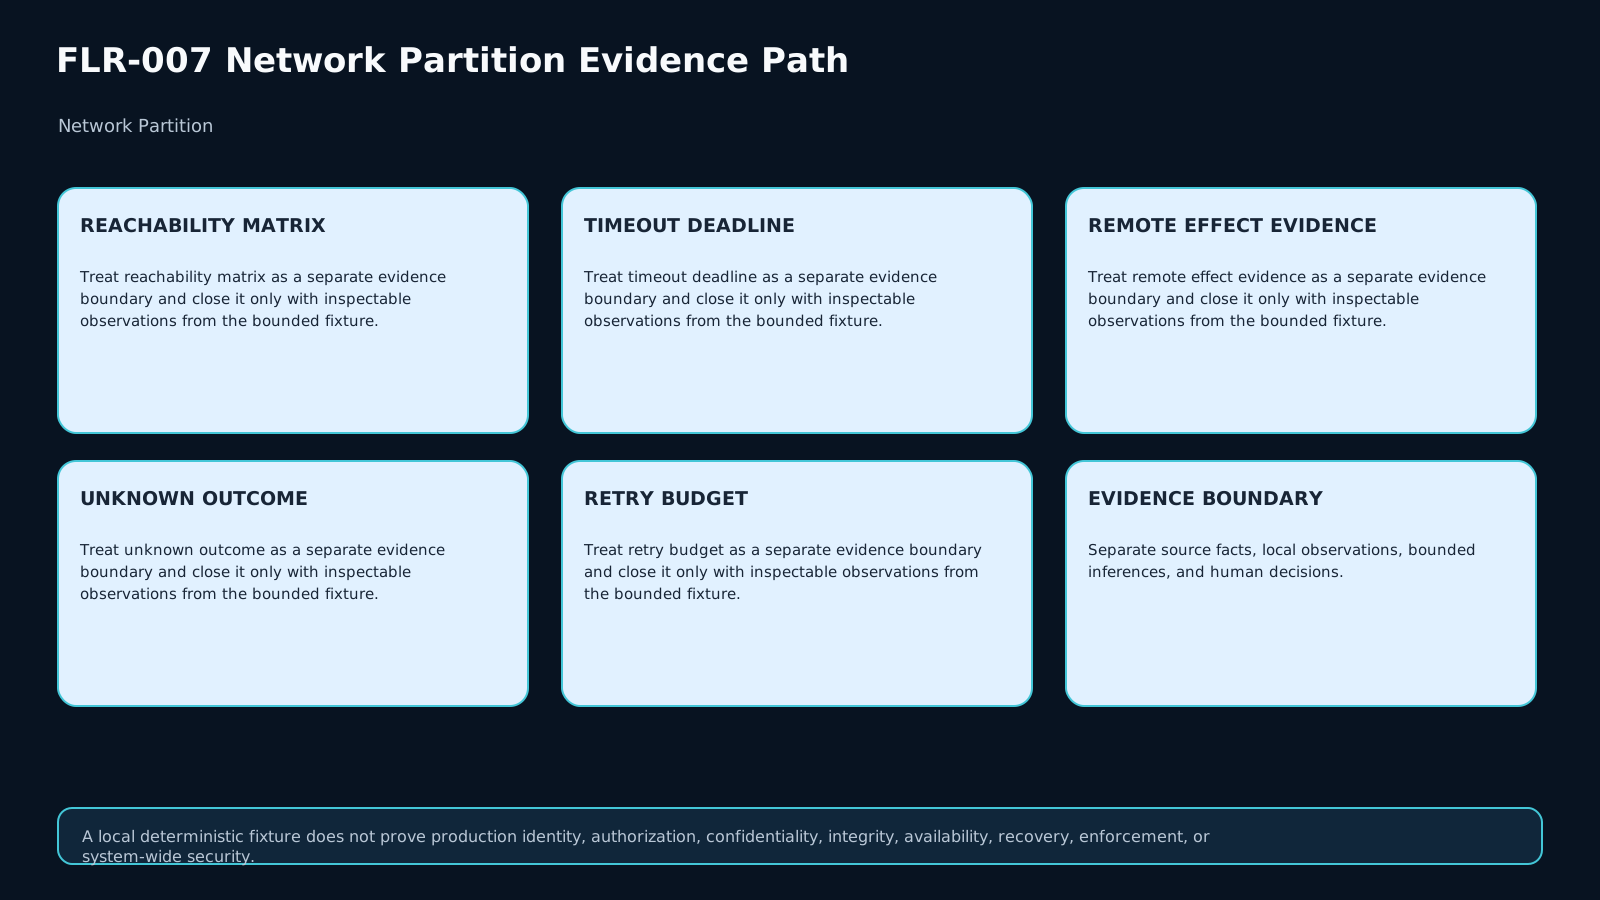
بهجای یک برچسب کلی «شبکه قطع است»، جهتها را جدا ثبت کنید: client→service، service→client، service A→service B و مسیرهای probe. partition میتواند symmetric یا asymmetric باشد. ممکن است A بتواند B را ببیند ولی B پاسخ را به A نرساند. record باید جهت هر مشاهده را صریح نگه دارد.
3. Remote outcome میتواند UNKNOWN بماند
اگر caller درخواست write را ارسال کرده و timeout گرفته، بدون ledger، idempotency key، remote trace یا evidence معادل نمیتوان گفت write انجام نشده است. AWS Builders’ Library دقیقاً هشدار میدهد که نتیجه یک network operation ممکن است برای client نامعلوم باشد. [AWS-DISTSYS] در این درس، UNKNOWN یک شکست تحلیلی نیست؛ یک state معتبر است.
4. Timeout و deadline را از retry جدا کنید
Timeout محدود میکند هر attempt چقدر منتظر بماند؛ deadline بودجه کل operation را محدود میکند؛ retry budget تعداد/هزینه تلاشهای بعدی را محدود میکند. اگر این سه با هم طراحی نشوند، یک outage کوچک میتواند به queueing، thread exhaustion یا cascading load تبدیل شود.
5. Retry مفید است، اما میتواند outage را تشدید کند
AWS توصیه میکند retry محدود باشد و با backoff و jitter انجام شود، چون retryهای زیاد میتوانند بار dependency ناسالم را افزایش دهند. [AWS-RETRY] اگر operation side effect دارد، retry بدون idempotency میتواند اثر تکراری بسازد. بنابراین «timeout شد، دوباره بزن» policy کافی نیست.
6. Finite retry و circuit breaker مرز containment هستند
Azure نیز برای transient faults روی timeout، retry محدود و circuit breaker برای failureهای پایدار تأکید میکند. [AZURE-TRANSIENT] Circuit breaker availability را تضمین نمیکند؛ فقط یک containment mechanism است تا caller بینهایت تلاش نکند و dependency فرصت recovery داشته باشد.
7. Service failure را با network partition قاطی نکنید
اگر reachability سالم است و service پاسخ قطعی 5xx یا application error میدهد، evidence بیشتر به service failure اشاره میکند تا partition. این lesson یک negative-control دارد تا learner مجبور شود symptom «درخواست ناموفق» را از failure family واقعی جدا کند.
8. Asymmetric partition مهمتر از چیزی است که dashboard نشان میدهد
یک health check از سمت A ممکن است سبز باشد در حالی که path برگشت یا مسیر B→A خراب است. یک aggregate metric نمیتواند جهت failure را ثابت کند. برای تشخیص partition باید حداقل دو observation مستقل و directional داشته باشید.
9. Degraded mode باید write boundary مشخص داشته باشد
در partition، read-only degraded mode ممکن است قابلقبول باشد، اما stale read یا write روی replica قدیمی میتواند inconsistency بسازد. اگر consistency requirement روشن نیست، write را آزاد نکنید. Containment باید مشخص کند کدام operationها fail-fast، queue، degrade یا fence میشوند.
10. Recovery با «ping برگشت» تمام نمیشود
بازگشت connectivity فقط شروع recovery است. باید recovery probe، state reconciliation و convergence evidence داشته باشید. اگر یک replica stale است، system ممکن است reachable باشد ولی هنوز safe نباشد. closure قبل از convergence یعنی اشتباه گرفتن transport recovery با application recovery.
11. Retry amplification را اندازه بگیرید
در fixture این درس retry budget صریح است. اگر چند caller همزمان timeout بگیرند و synchronized retry انجام دهند، load میتواند چند برابر شود. Backoff و jitter برای شکستن همین همبستگیاند. [AWS-RETRY] record باید retry count، budget exhaustion و breaker/degraded state را ثبت کند.
12. Alternative hypothesis را واقعاً رد کنید
حداقل یک alternative باید با negative evidence رد شود: service crash، application rejection، local client failure یا stale replica بدون partition. صرفاً نوشتن «احتمالاً network» کافی نیست. classification باید به reachability و remote-effect evidence متصل باشد.
13. Closure به independent convergence proof نیاز دارد
پس از restore، همان timeout قبلی را فقط دوباره اجرا نکنید. reachability را دوباره بسنجید، remote effect یا ledger را verify کنید، stale state را reconcile کنید و سپس یک independent request انجام دهید. اگر convergence ثابت نشده، state باید RECOVERY_NOT_CONVERGED یا OPEN باقی بماند.
14. Lab: هشت fixture و ۶۴ assertion
Lab کاملاً local و deterministic است. هشت case شامل baseline سالم، symmetric request drop، response loss با remote effect، one-way partition، deadline delay، retry-budget exhaustion، adjacent service failure، evidence ناقص و transfer با response loss + stale replica است. evaluator مخفی برای هر case هشت خروجی را میسنجد؛ مجموعاً ۶۴ assertion.
15. Exit checklist و مرز ادعا
برای خروج باید بتوانید reachability matrix بسازید؛ timeout را از remote outcome جدا کنید؛ UNKNOWN را حفظ کنید؛ retry/deadline/breaker را محدود کنید؛ یک alternative را رد کنید؛ recovery را از convergence جدا کنید؛ transfer case را از صفر تحلیل کنید؛ و صریح بگویید که موفقیت این fixture فقط reasoning همین محیط synthetic را ثابت میکند، نه رفتار همه شبکهها یا همه distributed systems.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
FLR-007-AF1 formative
FLR-007-AF2 formative
FLR-007-AF3 formative
FLR-007-AS1 summative
FLR-007-AS2 transfer
ملاکهای ارزیابی (rubric)
A passing submission must: (1) preserve directional reachability evidence; (2) keep remote effect UNKNOWN when no oracle exists; (3) reject at least one adjacent hypothesis with negative evidence; (4) use finite timeout/retry/degradation containment; (5) distinguish transport restoration from application-state convergence; (6) use an independent recovery oracle; and (7) rebuild the transfer fixture from fresh evidence.
A submission fails if one timeout is generalized into remote failure/non-execution, if retries are unbounded, or if connectivity restoration is treated as proof of state convergence.
منابع و تازگی
مطالعهٔ موارد (case studies)
فایلهای آزمایشگاه
Implement a bounded evaluate(case) function over eight synthetic cases. Treat direction, timeout/deadline, remote effect, retry budget, containment, restoration, and convergence as separate evidence dimensions.
Do not infer remote failure or non-execution from timeout alone. Preserve OPEN_BOUNDARY_UNRESOLVED when evidence is incomplete. The transfer case deliberately restores connectivity while leaving one replica stale, so closure requires convergence evidence rather than a green transport probe.
The lab is fully local and deterministic; no production network, credential, customer data, destructive action, or external target is involved.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)