امنیت، هویت، استقرار و تابآوری · فصل ۷ — Dependency، Contract، Event و Network Failure · 116
Crash After Side Effect
failure را بعد از وقوع و بهصورت موردی تحلیل میکند و هنوز detection، containment و repair path از قبل طراحی نشده است. موضوع جاری: «Crash After Side Effect». میتواند failure family «Crash After Side Effect» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
خلاصهٔ درس
failure را بعد از وقوع و بهصورت موردی تحلیل میکند و هنوز detection، containment و repair path از قبل طراحی نشده است. موضوع جاری: «Crash After Side Effect».
میتواند failure family «Crash After Side Effect» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
خروجی این درس
میتواند failure family «Crash After Side Effect» را بازتولید/تشخیص دهد و detection، containment و recovery مناسب را تعیین کند.
1. مسئله اصلی: process میمیرد، اثر ممکن است زنده مانده باشد
در این failure family، worker میتواند یک side effect پایدار یا بیرونی را commit کند و قبل از ثبت completion marker یا ارسال acknowledgement crash کند. بعد از restart، caller فقط میداند پاسخ کامل نشده است؛ از این علامت بهتنهایی نمیتوان نتیجه گرفت effect انجام نشده. اولین اصل درس این است: عدم دریافت پاسخ را با عدم وقوع اثر یکی نکن.
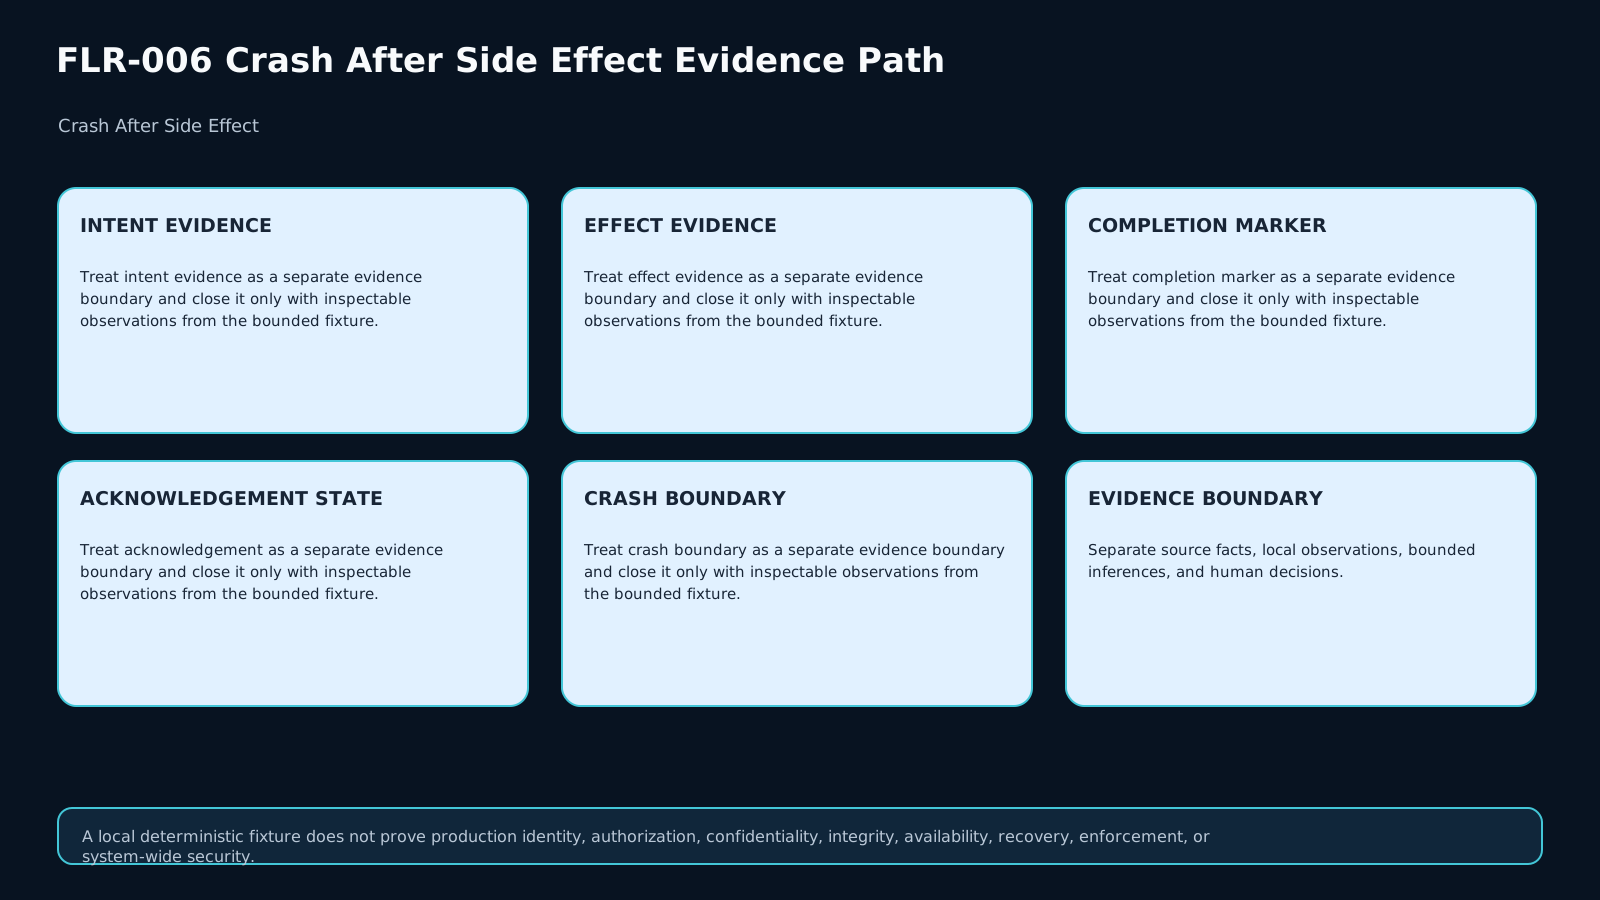
2. چهار boundary را جدا ثبت کن: intent، effect، marker، acknowledgement
برای هر operation باید حداقل چهار مرز مستقل داشته باشی: آیا intent ثبت شد؟ آیا side effect evidence وجود دارد؟ آیا completion marker ثبت شد؟ آیا caller acknowledgement را دید؟ اگر این چهار مورد در یک status کلی فشرده شوند، crash بین مرزها ambiguity ایجاد میکند و علت واقعی پنهان میشود.
3. Dual write یک مرز شکست واقعی میسازد
اگر business state و event/effect در دو write مستقل ثبت شوند، crash بین آنها میتواند state را ناسازگار بگذارد. نمونه رسمی Azure برای transactional outbox همین dual-write anomaly را نشان میدهد و state change + event را در یک atomic batch در یک logical partition نگه میدارد، سپس relay را جدا انجام میدهد. [AZURE-OUTBOX] این الگو مرز همان transaction را قوی میکند؛ unrelated external effects را globally atomic نمیکند.
4. Crash قبل از effect با crash بعد از effect یک recovery ندارد
اگر evidence معتبر نشان دهد effect هنوز رخ نداده، retry با همان operation identity میتواند قابلدفاع باشد. اما اگر effect رخ داده و marker جا مانده، blind retry ممکن است همان business effect را دوباره بسازد. بنابراین recovery باید از crash boundary شروع شود، نه از symptom «job failed».
5. UNKNOWN یک state معتبر است
گاهی intent ثبت شده، worker crash کرده، اما effect ledger یا remote oracle در دسترس نیست. در این حالت outcome باید UNKNOWN بماند. پر کردن خلا با «احتمالاً انجام نشده» یا «حتماً انجام شده» شواهد نیست. record خوب unknown را نگه میدارد و مشخص میکند چه observation بعدی آن را حل میکند.
6. Idempotency identity فقط وقتی مفید است که semantic intent هم ثابت باشد
AWS برای retryهای امنتر از client request identifier/idempotency token استفاده میکند تا repeated request قابل شناسایی باشد و side effect اضافه ایجاد نشود. [AWS-IDEMPOTENT] اما reuse همان key برای intent متفاوت نباید silent dedupe شود؛ باید conflict ایجاد شود. key بدون semantic equivalence یک مجوز عمومی برای retry نیست.
7. Successful retry اثبات exactly-once نیست
اگر retry سبز شد، فقط میدانیم مسیر retry در این مشاهده موفق بوده است. هنوز باید بررسی کنیم effect قبلی وجود داشته یا نه و آیا duplicate ساخته شده است. یک green response causal proof نیست. به همین دلیل evaluator این درس effect count و reconciliation evidence را جدا از response میسنجد.
8. Transactional outbox مرز خودش را دارد
Outbox state change و event record را در یک transaction مشترک نگه میدارد و relay بعداً آن event را منتشر میکند. Azure صریحاً atomicity را در محدوده transactional batch توضیح میدهد و delivery downstream را at-least-once در نظر میگیرد. [AZURE-OUTBOX] پس consumer همچنان ممکن است به dedupe/idempotency نیاز داشته باشد.
9. Reconciliation قبل از retry کور
وقتی effect ممکن است انجام شده باشد، اول با operation ID یا domain key به effect ledger/remote service query بزن. سه outcome اصلی داری: effect وجود ندارد، effect دقیقاً یکبار وجود دارد، یا evidence ناکافی است. فقط بعد از این مرحله میتوان درباره retry، marker repair یا compensation تصمیم گرفت.
10. Completion marker evidence مهم است، ولی همیشه effect oracle نیست
Marker میتواند بگوید workflow از یک مرز عبور کرده، اما اگر marker و external effect atomic نیستند، marker نبودن لزوماً effect نبودن را ثابت نمیکند. برعکس، marker موجود با ack گمشده معمولاً نشان میدهد caller باید result را reconcile کند، نه اینکه business effect را دوباره اجرا کند.
11. Compensation با retry فرق دارد
Retry تلاش میکند intended operation را به completion برساند؛ compensation یک effect قبلاً پذیرفتهشده را با operation دیگری خنثی یا متعادل میکند. اگر business domain compensation دارد، باید operation identity، evidence و residual risk آن جدا ثبت شود. compensation هم rollback جهانی و تضمینی نیست.
12. Negative control: response loss بدون process crash
اگر remote effect و completion marker هر دو موجودند ولی فقط response در مسیر شبکه گم شده، failure family اصلی Network Partition/response loss است، نه Crash After Side Effect. این negative control جلوی این اشتباه را میگیرد که هر «پاسخ نرسید» را crash داخلی بنامیم.
13. Transfer: side effect را به service جدا منتقل کن
در transfer fixture، effect در یک service محلی جدا ثبت میشود و completion marker در worker اصلی با تأخیر میآید. دیگر نمیتوان فرض کرد local ledger و marker در یک atomic boundary هستند. learner باید remote evidence را با operation ID reconcile کند و سپس local completion را repair کند.
14. Lab: هشت fixture و ۶۴ assertion
Lab کاملاً local، deterministic و synthetic است. هشت case شامل baseline، crash-before-effect، crash-after-effect-before-marker، crash-after-marker-before-ack، idempotency conflict، negative-control network response loss، evidence ناقص و transfer cross-service است. evaluator مخفی برای هر case هشت خروجی را میسنجد؛ مجموعاً ۶۴ assertion.
15. Exit checklist و مرز ادعا
برای خروج باید بتوانی intent/effect/marker/ack را جدا کنی؛ crash boundary را با evidence تعیین کنی؛ UNKNOWN را حفظ کنی؛ retry را فقط پس از reconciliation/idempotency انتخاب کنی؛ same key + different intent را conflict بدانی؛ outbox را به atomic boundary واقعیاش محدود کنی؛ transfer را از صفر تحلیل کنی؛ و صریح بگویی این fixture فقط reasoning همین محیط synthetic را ثابت میکند، نه exactly-once جهانی.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
FLR-006-AF1 formative
FLR-006-AF2 formative
FLR-006-AF3 formative
FLR-006-AS1 summative
FLR-006-AS2 transfer
ملاکهای ارزیابی (rubric)
| Dimension | Sufficient evidence | Blocking failure |
|---|---|---|
| Boundary reproduction | Intent/effect/marker/ack boundaries are explicit | Generic “job failed” diagnosis |
| Evidence discrimination | Direct evidence and UNKNOWN are separated from inference | Guessing effect state from response alone |
| Idempotency judgment | Same identity is tied to semantic intent; conflicts are rejected | Blind key reuse or blind retry |
| Recovery | Reconciliation precedes retry where effect may exist; closure uses independent evidence | Green retry treated as proof |
| Transfer | Cross-service boundary is rebuilt from new evidence | Assumes first fixture atomicity |
منابع و تازگی
مطالعهٔ موارد (case studies)
فایلهای آزمایشگاه
Use only the supplied synthetic local fixtures. For each case, build Side-Effect Crash Reconciliation Record v1 from observable evidence.
Your record must distinguish intent, durable/remote effect evidence, completion marker, acknowledgement, crash boundary, idempotency identity, reconciliation, recovery action, and residual ambiguity. Preserve UNKNOWN when evidence is insufficient. Do not assume a missing response means the effect did not happen.
The transfer fixture moves the effect to a separate local-service simulation; do not assume it shares an atomic boundary with the worker’s completion marker.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)