وب مدرن، رابط کاربری و تجربهی وب · فصل ۲ — HTML، CSS، Responsive و RTL · 40
Unicode، RTL و Bidi در یک محصول فارسی
میتواند «Unicode, RTL و Bidi در محصول فارسی» را در یک feature محدود طراحی/پیادهسازی کند و correctness، accessibility یا failure behavior مرتبط را اثبات کند.
خلاصهٔ درس
میتواند «Unicode, RTL و Bidi در محصول فارسی» را در یک feature محدود طراحی/پیادهسازی کند و correctness، accessibility یا failure behavior مرتبط را اثبات کند.
خروجی این درس
میتواند «Unicode, RTL و Bidi در محصول فارسی» را در یک feature محدود طراحی/پیادهسازی کند و correctness، accessibility یا failure behavior مرتبط را اثبات کند.
ممکن است صفحه فارسی درست به نظر برسد، اما مدل جهت متن آن غلط باشد
یک ردیف اعلان را در صفحه حساب کاربری فارسی تصور کنید: جمله با متن فارسی شروع میشود، در میانه نام کاربری alex_dev قرار دارد، سپس کد سفارش AB-2048 دیده میشود و جمله با نشانهگذاری تمام میشود. توسعهدهنده ممکن است فقط container را text-align: right کند و در نمونه اول نتیجه ظاهراً قابل قبول باشد. همین پیادهسازی با یک نام کاربری عربی، یک مقدار شروعشونده با عدد، یک ایمیل یا رشتهای که حروف فارسی و لاتین را مخلوط میکند میتواند بههم بریزد. نقطه، پرانتز یا خط تیره ممکن است کنار run اشتباه دیده شود و یک «اصلاح» عجولانه حتی ممکن است ترتیب داده یا DOM را معکوس کند تا فقط اسکرینشات خوب شود.
در این درس direction یک قرارداد داده و ساختار است، نه افکت ظاهری. متن Unicode در logical order ذخیره میشود؛ یعنی همان ترتیبی که معنای داده و جمله اقتضا میکند. الگوریتم Unicode Bidirectional Algorithm نمایش دیداری runهای راستبهچپ و چپبهراست را از روی ویژگیهای جهت و context تعیین میکند. در HTML، metadata جهت مانند dir جهت پایه سند یا یک subtree محدود را مشخص میکند. محتوای inline ناشناخته یا با جهت مخالف ممکن است نیاز به isolation داشته باشد تا کاراکترهای قوی داخل آن، punctuation اطراف را مختل نکنند. جهت layout و CSS logical properties مهماند، اما جای semantics مربوط به bidi را نمیگیرند.
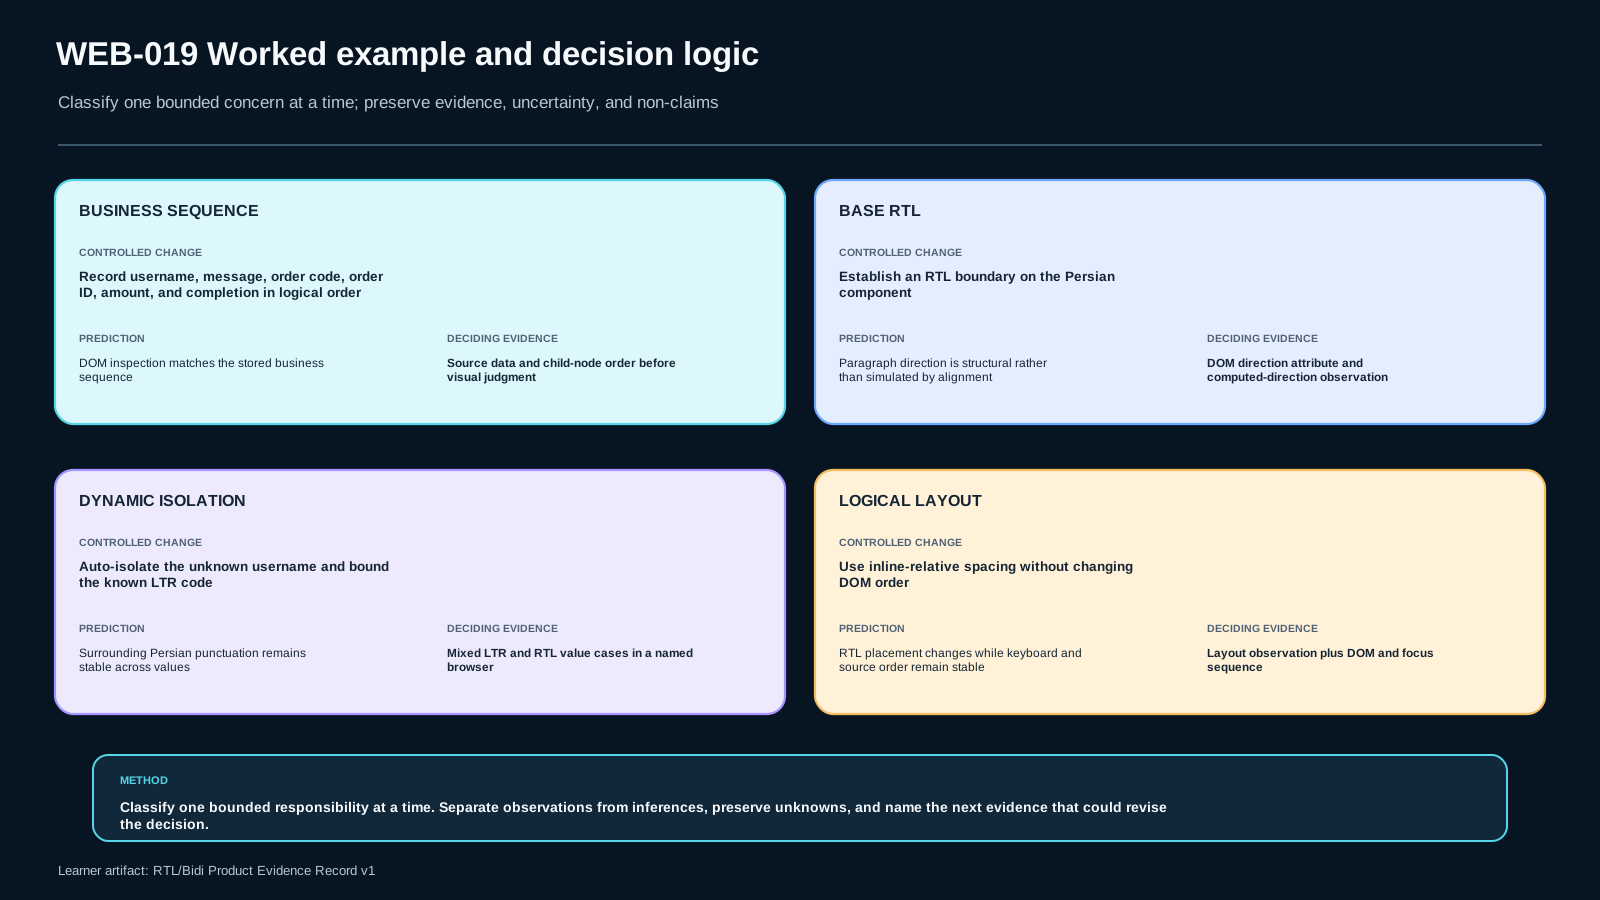
Artifact این درس RTL/Bidi Product Evidence Record v1 است. این رکورد باید implementation artifact، رفتار قابل مشاهده browser/DOM، حداقل یک failure mutation عمدی، نتیجه repair، یک changed-context transfer و یک residual limitation را ثبت کند. اسکرینشات بهتنهایی کافی نیست؛ چون یک خروجی دیداری قابل قبول ممکن است روی logical order معکوس یا markup شکننده ساخته شده باشد.
چهار claim درس مرز کار را تعیین میکنند: logical storage order با visual presentation یکی نیست؛ base direction باید از metadata ساختاری مثل dir بیاید و نه از alignment hack؛ runهای inline ناشناخته یا با جهت مخالف در شرایط لازم باید isolate شوند؛ و محصول فارسی باید با دادههای واقعی شامل username، code، number، punctuation و user-generated text آزمایش شود، نه فقط با lorem فارسی راحت.
Non-goalها نیز صریحاند: RTL به معنی reverse کردن string یا DOM نیست؛ text-align:right معادل dir="rtl" نیست؛ CSS logical properties ترتیب bidi داخل متن را حل نمیکنند؛ و <bdo> راهحل عمومی mixed-direction text نیست.
WEB019-LAB1 یک fixture محلی HTML/CSS/JavaScript است که عمداً با shortcutهای دیداری شروع میشود. قبل از repair قرارداد را بنویسید، فقط boundary متعلق به این درس را اصلاح کنید، یک mutation را اجرا کنید و سپس همان روش را روی اعلان متفاوت انتقال دهید. در authoring هیچ نتیجه browser از پیش ادعا نمیشود؛ evidence شما باید observation واقعی را از inference جدا کند.
سه مسیر یادگیری، یک استاندارد evidence
مسیر Foundation. قبل از code چهار مفهوم را جدا کنید: logical source order، base direction، bidi isolation و layout direction. ابتدا data و DOM starter را بدون توجه به CSS ببینید. با یک جمله فارسی و یک token لاتین شروع کنید و بعد به notification واقعی برسید. از نسخههای ظاهری مانند «روی همهچیز direction:rtl بگذار» اجتناب کنید؛ هدف فهمیدن boundary است، نه حفظ recipe.
مسیر Repair. از symptom شروع کنید: punctuation در جای عجیبی افتاده، username ترتیب بصری اطراف را به هم زده، یا کل صفحه راستچین است ولی base direction هنوز LTR است. مسئله را به کوچکترین رشته بازتولیدپذیر کاهش دهید. سپس تشخیص دهید cause اصلی کدام است: base direction، نبود isolation، corruption در source order، یا انتخاب layout. فقط همان cause را repair کنید و evidence row قبلی را دوباره اجرا کنید.
مسیر Experienced. از واژگان ابتدایی عبور کنید و مستقیماً ownership component را تعریف کنید: کدام subtree مالک Persian base direction است، کدام value جهت معلوم دارد، کدام user-generated value جهت ناشناخته دارد و چگونه ثابت میکنید source/DOM order هرگز برای ظاهر معکوس نشده است. تجربه framework جای baseline، mutation و transfer را نمیگیرد.
دو prerequisite محدود میمانند. WEB-009 hard prerequisite است: semantic HTML باید از قبل قابل دفاع باشد. این درس قرار نیست ساختار نامناسب را با پراکندن dir روی هر node جبران کند. WEB-013 soft prerequisite است: focus و keyboard behavior نباید در repair جهت خراب شوند، اما focus management و keyboard pattern دوباره تدریس نمیشوند.
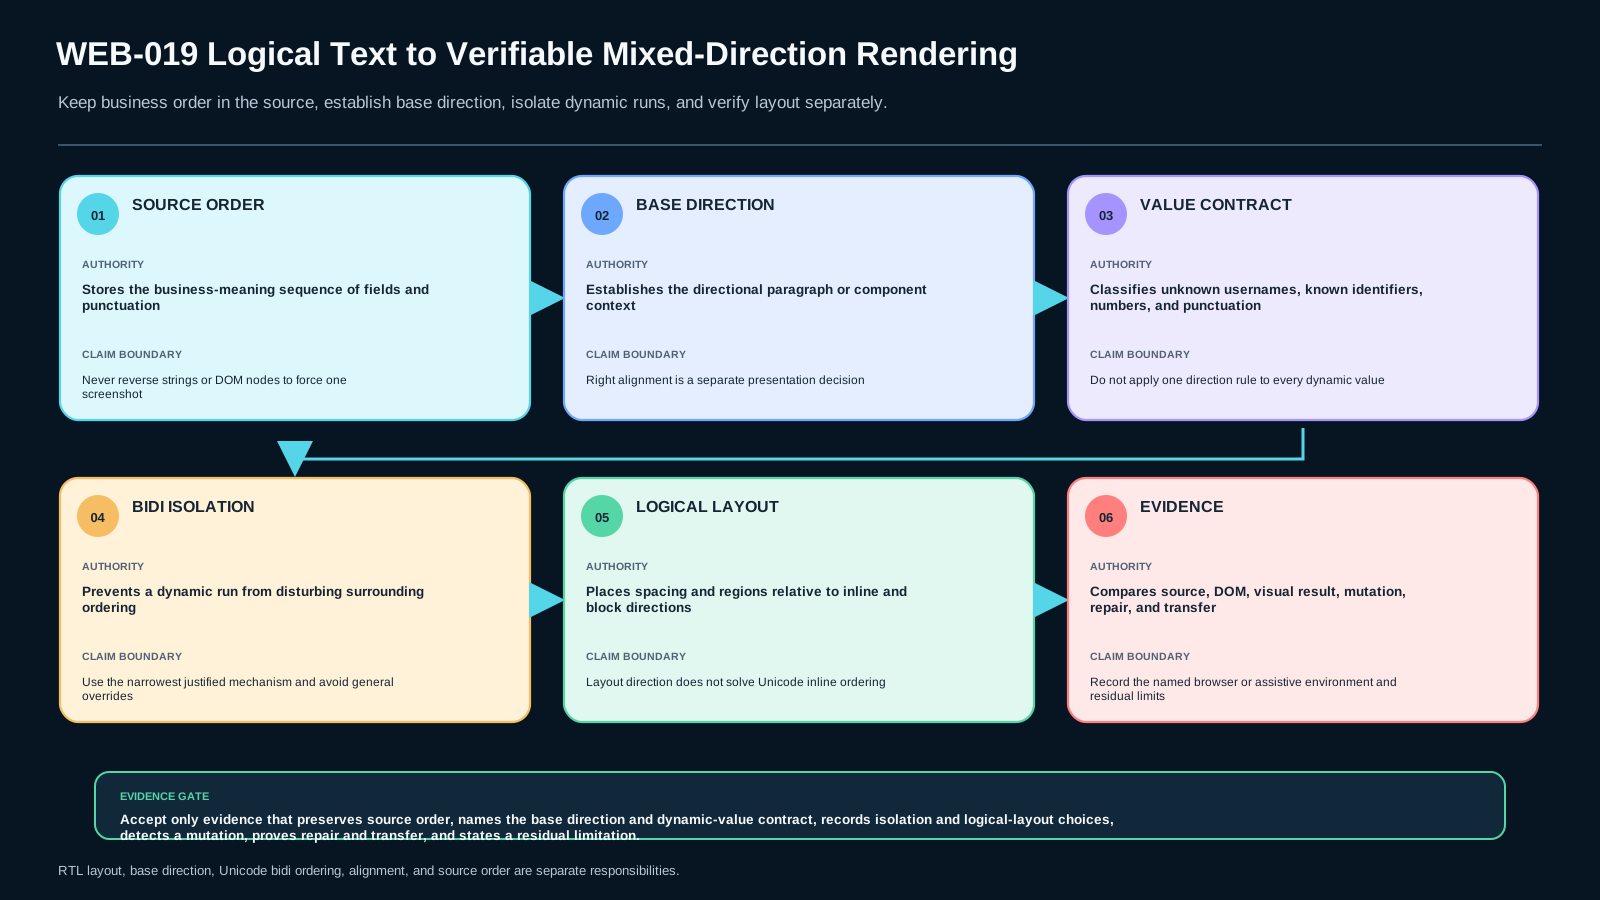
قاعده عملی درس این است: logical data order را حفظ کن؛ base direction را ساختاری اعلام کن؛ فقط runهای inline لازم را isolate کن؛ و با رشتههای mixed واقعی verify کن. این قاعده مانع از قاطیکردن سه لایه میشود: جهت کاراکتر/run، جهت پایه paragraph/component و چینش فیزیکی boxها در layout.
مدل ذهنی: source order → base direction → isolation → visual order → evidence
Logical order منبع حقیقت است
متن Unicode «به ترتیبی که روی صفحه دیده میشود» ذخیره نمیشود. یک پیام فارسی که username لاتین و order code دارد باید در data و DOM همان ترتیب معنایی کسبوکار را حفظ کند. هیچ substring یا DOM node را صرفاً برای خوبشدن تصویر reverse نکنید. اولین evidence checkpoint، raw sequence قبل از rendering است. source fields یا DOM sequence را ثبت کنید. اگر UI فقط وقتی خوب میشود که business order تغییر کند، قرارداد قبل از visual test شکسته شده است.
Base direction context میسازد
یک document عمدتاً فارسی معمولاً به RTL base direction نیاز دارد. HTML این metadata را با dir فراهم میکند. در سطح document یک نمونه معمول این است:
<html lang="fa" dir="rtl">نکته اصلی boundary معنایی است، نه اینکه همیشه فقط <html> انتخاب شود. اگر shell اصلی LTR است و فقط یک component فارسی داریم، میتوان dir="rtl" را روی همان subtree محدود کرد. lang زبان را مشخص میکند و dir جهت را؛ این دو مسئله متفاوتاند. text-align:right فقط محل قرارگیری محتوای خط را تغییر میدهد و base direction الگوریتم bidi را تعریف نمیکند.
Isolation از context اطراف محافظت میکند
user-generated inline content را نمیتوان از روی نمونه امروز طبقهبندی کرد. username ممکن است لاتین، عربی، عددی یا mixed باشد. اگر value مستقیماً وارد bidi context جمله شود، strong characterهای داخل آن میتوانند neutral punctuation مجاور را تحت تأثیر بگذارند. HTML عنصر <bdi> را برای isolation دارد:
<span>کاربر <bdi dir="auto">${displayName}</bdi> سفارش</span>value از surrounding text isolate میشود و dir="auto" جهت خودش را از content میگیرد. اگر code طبق contract همیشه LTR است، میتوان همان known direction را صریح ثبت کرد؛ نیاز نیست حدس زده شود.
Visual order خروجی است، نه storage plan
Unicode Bidirectional Algorithm runها را برای نمایش resolve میکند. application code معمولاً باید logical order و boundaryهای درست را فراهم کند، نه اینکه خودش display reordering را بازسازی کند. یک sample ممکن است اتفاقی درست باشد ولی sample دیگر با digit، hyphen، parentheses یا RTL username شکست را آشکار کند.
Layout direction لایه دیگری است
CSS logical propertyهایی مثل padding-inline, margin-inline-start, border-inline-start و inset-inline-end کمک میکنند layout نسبت به writing direction بیان شود. اما token mixed را isolate نمیکنند و جای base direction HTML را نمیگیرند. همینطور reverse کردن flex row فقط چون locale فارسی است، ممکن است visual order و DOM order را از هم دور کند. layout reversal درمان bidi text نیست.
Evidence observation و inference را جدا میکند
Observation چیزی است که واقعاً inspect کردهاید: source order، dir boundary، DOM structure یا rendering یک test string در environment مشخص. Inference نتیجهای است که از آن observations میگیرید. یک evidence خوب این دو را جدا ثبت میکند و یک browser run را به همه browserها، fontها، assistive technologyها یا رشتههای Unicode تعمیم نمیدهد.
لایه پایه: حداقل واژگان markup و CSS
برای یک subtree فارسی، ساختار ساده میتواند چنین باشد:
<main lang="fa" dir="rtl">
<h1>سفارشهای من</h1>
</main>اگر کل document فارسی است، قرار دادن lang="fa" dir="rtl" روی <html> معمولاً ownership را واضحتر میکند چون descendants context را inherit میکنند. اگر فقط بخشی فارسی است، direction را همانجا scope کنید. از dir="auto" برای value محدود با جهت ناشناخته استفاده کنید، نه بهصورت blanket روی هر element.
در notification، dynamic tokenها میتوانند مستقل isolate شوند:
<p class="notice" dir="rtl">
  کاربر <bdi dir="auto">alex_dev</bdi>
  سفارش <bdi dir="ltr">AB-2048</bdi> را ثبت کرد.
</p>
username unknown-direction است؛ code در این مثال bounded known-LTR است؛ جمله فارسی logical source order خودش را حفظ میکند. <bdo> برعکس، override اجباری میدهد و فقط وقتی مناسب است که product واقعاً قصد override دارد. برای «این رشته mixed عجیب دیده میشود» پاسخ پیشفرض نیست.
CSS logical properties edgeهای layout را direction-aware میکنند:
.notification {
  padding-inline: 1rem;
  border-inline-start: 4px solid currentColor;
}
.notification__code { margin-inline-start: .5rem; }
این کار duplicate کردن left/right ruleها را کم میکند، اما semantics متن را اصلاح نمیکند. در debugging علاوه بر screenshot، data source و DOM text را inspect کنید. یک logging کوتاه از displayName, orderCode و sequence nodeها میتواند فوراً نشان دهد که آیا کسی برای ظاهر، data order را تغییر داده است.
نکته مهم درباره entityها و escaping نیز خارج از scope نیست اما باید درست مرزبندی شود: user-generated content باید طبق قواعد امنیتی و rendering platform escape شود، ولی این درس security/sanitization lesson نیست. isolation را نباید با sanitization اشتباه گرفت. یک value هم میتواند امن encode شده باشد و هم از نظر bidi نیاز به boundary داشته باشد.
توضیح عمیق: چرا neutralها و boundaryها مسئله را پیچیده میکنند
در mixed text همه characterها «جهت مستقل و واضح» ندارند. حروف فارسی strong RTL و بسیاری از حروف لاتین strong LTR هستند، اما punctuation و بعضی separatorها یا symbols میتوانند neutral یا context-sensitive باشند. همین وابستگی به context باعث میشود یک نقطه یا پرانتز در کنار username و code متفاوت از انتظار ساده developer قرار بگیرد. بنابراین تشخیص درست از «همه حروف را راستبهچپ کن» شروع نمیشود؛ از boundary و directional runs شروع میشود.
Base direction تعیین میکند paragraph یا bounded region از چه context پایهای برای حل ترتیب دیداری استفاده کند. اگر base direction اشتباه باشد، حتی وقتی text-align ظاهراً راست است، algorithm context دیگری دارد. سپس isolation مشخص میکند یک inline run تا چه حد باید از surrounding sequence مستقل باشد. unknown-direction user value مثال کلاسیک است: product نمیداند اولین strong character مقدار بعدی چیست، پس باید contract آن را بهعنوان data ناشناخته طراحی کند نه اینکه ltr یا rtl را از امروز hard-code کند.
Known-direction value وضع متفاوتی دارد. مثلاً product ممکن است order code را صریحاً ASCII/Latin تعریف کرده باشد. در این boundary میتوان known LTR را اعلام کرد. نکته این است که direction از قرارداد value میآید، نه از «این نمونه در screenshot لاتین بود». اگر فردا schema اجازه Arabic letters داد، همان assumption باید بازبینی شود.
Unicode Bidi Algorithm را application معمولی نباید دوباره پیادهسازی کند. نقش developer این است که logical sequence معتبر، semantic base direction و isolation درست را فراهم کند. دستیکردن reordering معمولاً data semantics، copy/paste، selection، accessibility و maintenance را شکننده میکند. همچنین یک browser screenshot بهتنهایی logical correctness را ثابت نمیکند؛ برای همین evidence record علاوه بر visual observation، source order و DOM observation را لازم دارد.
برای layout، فرق بین inline direction و box arrangement را نگه دارید. flex-direction, grid placement یا logical margins میتوانند layout را تغییر دهند ولی قرار نیست الگوریتم inline bidi را جایگزین کنند. اگر interaction order اهمیت دارد، DOM order باید بر اساس semantics و interaction طراحی شود؛ visual repositioning نباید بهانهای برای reverse کردن source باشد. این نقطه به prerequisite accessibility مربوط است، ولی scope درس هنوز bidi/product evidence است.
مثالهای حلشده: از تشخیص تا evidence
مثال ۱: صفحه راستچین است ولی base direction غلط است
فرض کنید <html lang="fa"> داریم و CSS روی body text-align:right گذاشته است. symptom در یک رشته mixed با code و punctuation دیده میشود. diagnosis این نیست که «راستچین بیشتری لازم است»؛ ابتدا inspect میکنیم آیا semantic base direction وجود دارد. اگر document واقعاً فارسی است، repair bounded میتواند افزودن dir="rtl" در boundary مالک باشد. سپس همان input قبل و بعد اجرا و source order بدون تغییر ثبت میشود. مشاهده باید در environment واقعی learner نوشته شود؛ این متن نتیجه render را از پیش تعیین نمیکند.
مثال ۲: username ناشناخته punctuation اطراف را بههم میزند
Template منطقی این است: «کاربر [displayName] سفارش [orderCode] را ثبت کرد.» displayName user-generated و unknown-direction است؛ code طبق contract LTR. repair مناسب میتواند displayName را با <bdi dir="auto"> و code را با boundary LTR isolate کند، بدون اینکه ترتیب sentence یا data تغییر کند. evidence شامل input string، raw source order، mechanism انتخابشده و visual/DOM observation واقعی است.
مثال ۳: developer source order را reverse کرده است
برای «درستشدن» کارت RTL، markup بهصورت code → message → actor نوشته شده، چون visually چیزی شبیه نیاز دیده میشود. این راهحل failure است حتی اگر screenshot فعلی خوب باشد. source business meaning باید actor → message → code باقی بماند؛ box layout در لایه layout حل میشود و inline bidi در لایه direction/isolation. mutation reverse-source عمداً همین خطا را بازسازی میکند تا learner بتواند فرق visual success و contract failure را ثبت کند.
مثال ۴: <bdo> بهعنوان چکش عمومی
اگر developer روی mixed token <bdo dir="ltr"> بگذارد فقط چون «ترتیب درست شد»، باید سؤال کند آیا واقعاً قصد override character ordering وجود دارد یا فقط isolation لازم است. برای unknown user value، isolation معمولاً boundary مرتبطتری است. decision evidence باید requirement را ثبت کند؛ «در browser من بهتر شد» بهتنهایی design contract نیست.
Failure modeها و علائم تشخیصی
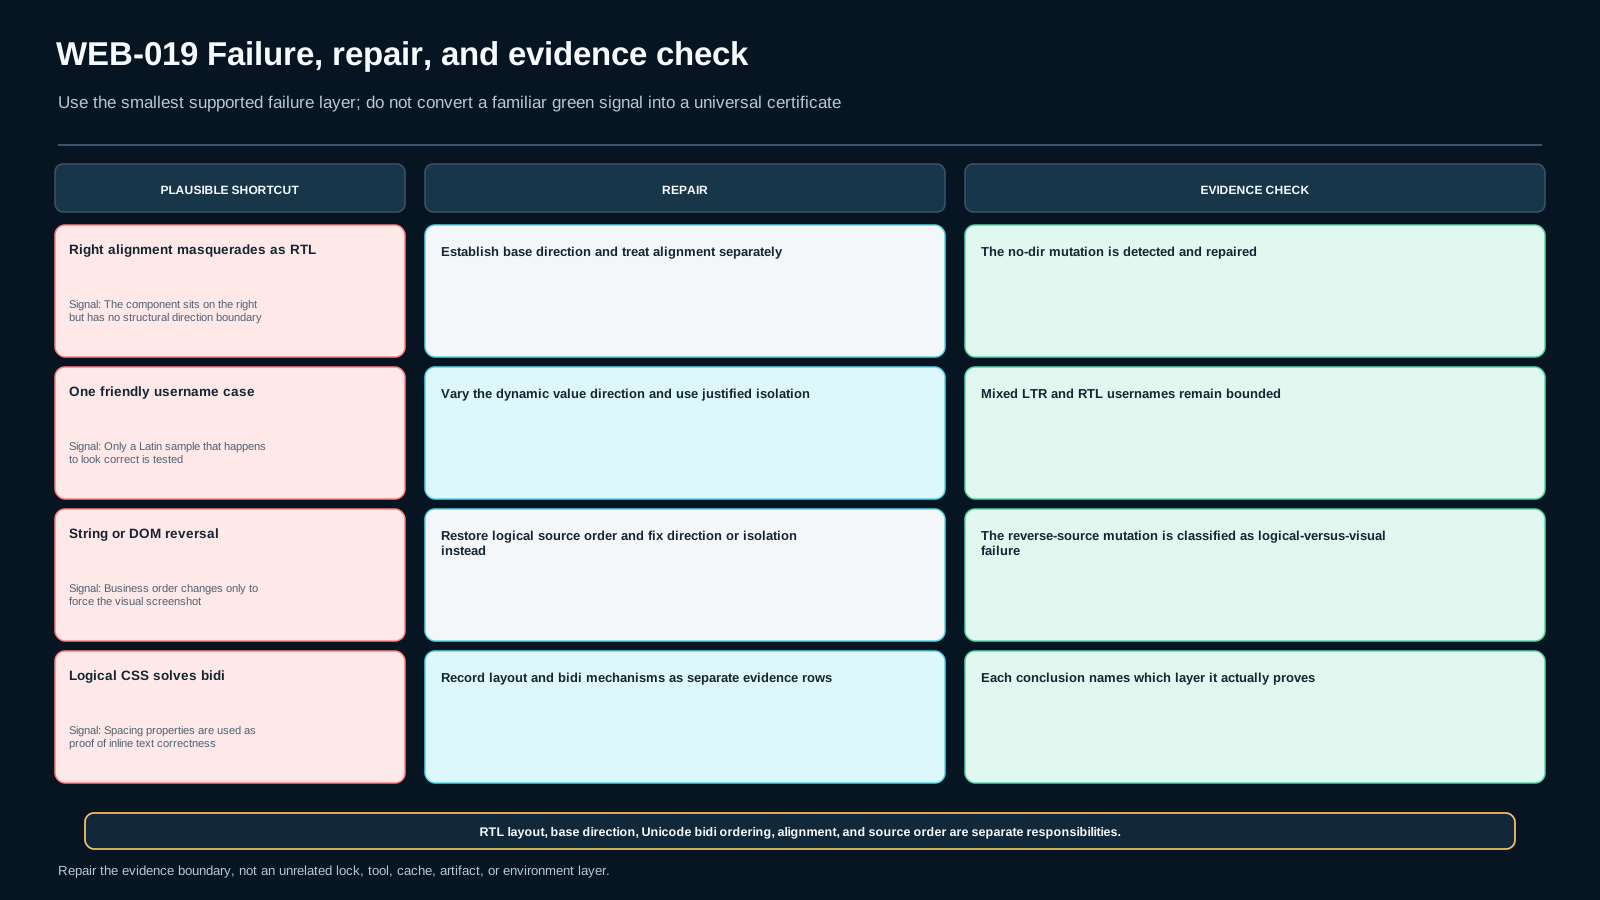
Alignment-only repair. علامت: صفحه از راست شروع میشود ولی mixed punctuation یا runها هنوز شکنندهاند. تشخیص: text-align presentation را جابهجا کرده اما base direction را تعریف نکرده است.
Blanket direction rule. علامت: developer direction:rtl را روی selectorهای متعدد پخش کرده و componentهای code/email نیز رفتار نامناسب دارند. تشخیص: ownership base direction روشن نیست و known/unknown inline boundaries با subtree direction یکی فرض شدهاند.
Missing isolation. علامت: با تغییر username یا code، punctuation اطراف یا ترتیب visual unexpected میشود. تشخیص: dynamic run بخشی از surrounding bidi context شده و boundary مناسب ندارد.
Hard-coded direction from one sample. علامت: username امروز Latin است پس همیشه dir=ltr گرفته، ولی data contract اجازه value RTL یا mixed میدهد. تشخیص: implementation به sample وابسته است، نه schema/value contract.
Source or DOM reversal. علامت: screenshot قابل قبول است اما copy/paste، reading/interaction sequence یا data inspection ترتیب غیرمعنایی نشان میدهد. تشخیص: developer visual order را به storage plan تبدیل کرده است.
Logical CSS as bidi cure. علامت: margin-inline-start و padding-inline اضافه شده ولی inline text failure باقی است. تشخیص: layout edges درستتر شدهاند اما isolation/base-direction مسئله دیگری است.
Universalizing one browser observation. علامت: evidence میگوید «همیشه درست است» در حالی که فقط یک browser/font/input آزمایش شده. repair evidence: environment را نام ببرید، observation را محدود کنید و residual limitation را صریح نگه دارید.
در تمام failure modeها rule یکسان است: symptom را به critical dimension وصل کنید، mutation یا case بازتولیدپذیر بسازید، prediction را قبل از اجرا ثبت کنید و repair را فقط در owned boundary انجام دهید.
پل برای توسعهدهنده باتجربه: component API را direction-aware طراحی کن
در design system مسئله bidi بهتر است در API component دیده شود، نه بهعنوان patch لحظه آخر. container فارسی میتواند base direction را از application shell یا locale boundary بگیرد. dynamic text component باید مشخص کند value «known LTR»، «known RTL» یا «unknown user content» است. این classification باید از data contract بیاید. component نباید بهطور مخفی string را reverse کند یا punctuation اضافه کند تا یک screenshot خاص را درست کند.
در frameworkهای component-based، همان semantics HTML پابرجاست. abstraction نباید dir و <bdi> را به CSS imitation تبدیل کند. اگر component prop مانند dir="auto" یا wrapper برای isolated value فراهم میکنید، testهای آن باید چند content class داشته باشند: Latin username، Persian/Arabic username، numeric-leading value، mixed display name و code با punctuation. هدف test این نیست که pixel order را برای همه engineها hard-code کند؛ هدف این است که structural contract، source order و bounded observations ثابت بمانند.
SSR/hydration نیز reason برای دستکاری دستی bidi نیست. server و client باید logical source یکسان داشته باشند. اگر direction از user data مشتق میشود، derivation باید deterministic باشد و mismatch ایجاد نکند. این درس وارد معماری SSR نمیشود، اما evidence باید نشان دهد repair وابسته به reorder تصادفی runtime نیست.
برای localization pipeline، bidi controls یا invisible characterها میتوانند بحث جداگانه و پرریسکی باشند. این lesson عمداً روی semantic HTML direction markup و isolation محدود تمرکز دارد. اضافهکردن control characterهای Unicode به translation string بدون contract روشن، scope را بیدلیل گسترش میدهد. frozen source boundary نیز همین محدودیت را حفظ میکند.
Alternativeها و trade-offها
Document-level dir="rtl" در برابر component-level direction. اگر کل experience فارسی است، document-level ownership ساده و قابل inheritance است. اگر shell چندجهته یا embedded component داریم، local boundary دقیقتر است. هیچکدام universal winner نیست؛ انتخاب از product boundary میآید.
<bdi dir="auto"> در برابر known explicit direction. برای value واقعاً ناشناخته، auto isolation به contract نزدیک است. برای identifierی که schema صریحاً ASCII/LTR تضمین میکند، explicit LTR میتواند واضحتر باشد. خطا زمانی رخ میدهد که unknown را known فرض کنیم یا known را بدون دلیل auto کنیم.
CSS direction در برابر HTML dir. CSS میتواند presentation direction را کنترل کند، اما frozen source boundary این درس semantic HTML direction metadata را برای content direction ترجیح میدهد. دلیل pedagogical این است که structure باید مستقل از stylesheet قابل فهم باشد. این به معنی ممنوعیت مطلق CSS direction در همه productها نیست؛ تصمیم باید bounded و مستند باشد.
Isolation در برابر override. <bdi> context را isolate میکند؛ <bdo> ordering را override میکند. اگر requirement فقط جلوگیری از تأثیر dynamic token بر surrounding text است، override بیش از نیاز مداخله میکند. override فقط وقتی defendable است که intentional override خود requirement باشد.
Physical left/right در برابر logical properties. در UI چندجهته، logical properties maintenance را بهتر میکنند، اما migration باید regression layout را جدا از bidi text evidence بسنجد. یک refactor CSS logical نباید بهعنوان اثبات درستشدن inline bidi گزارش شود.
Visual snapshot در برابر evidence record. snapshot سریع است و regression ظاهری را نشان میدهد، اما logical source order، DOM boundary و inference را ثبت نمیکند. artifact این درس به همین دلیل چندنوع evidence را کنار هم میخواهد.
تمرین هدایتشده و تمرین مستقل
در بخش هدایتشده WEB019-LAB1 را باز کنید و قبل از هر edit سه چیز را ثبت کنید: logical message order در data، direction boundary فعلی و dynamic valueهایی که known یا unknown هستند. starter عمداً dir="rtl" semantic را ندارد و با right alignment تلاش میکند ظاهر فارسی بسازد. آن را بهعنوان failure fixture ببینید، نه template production.
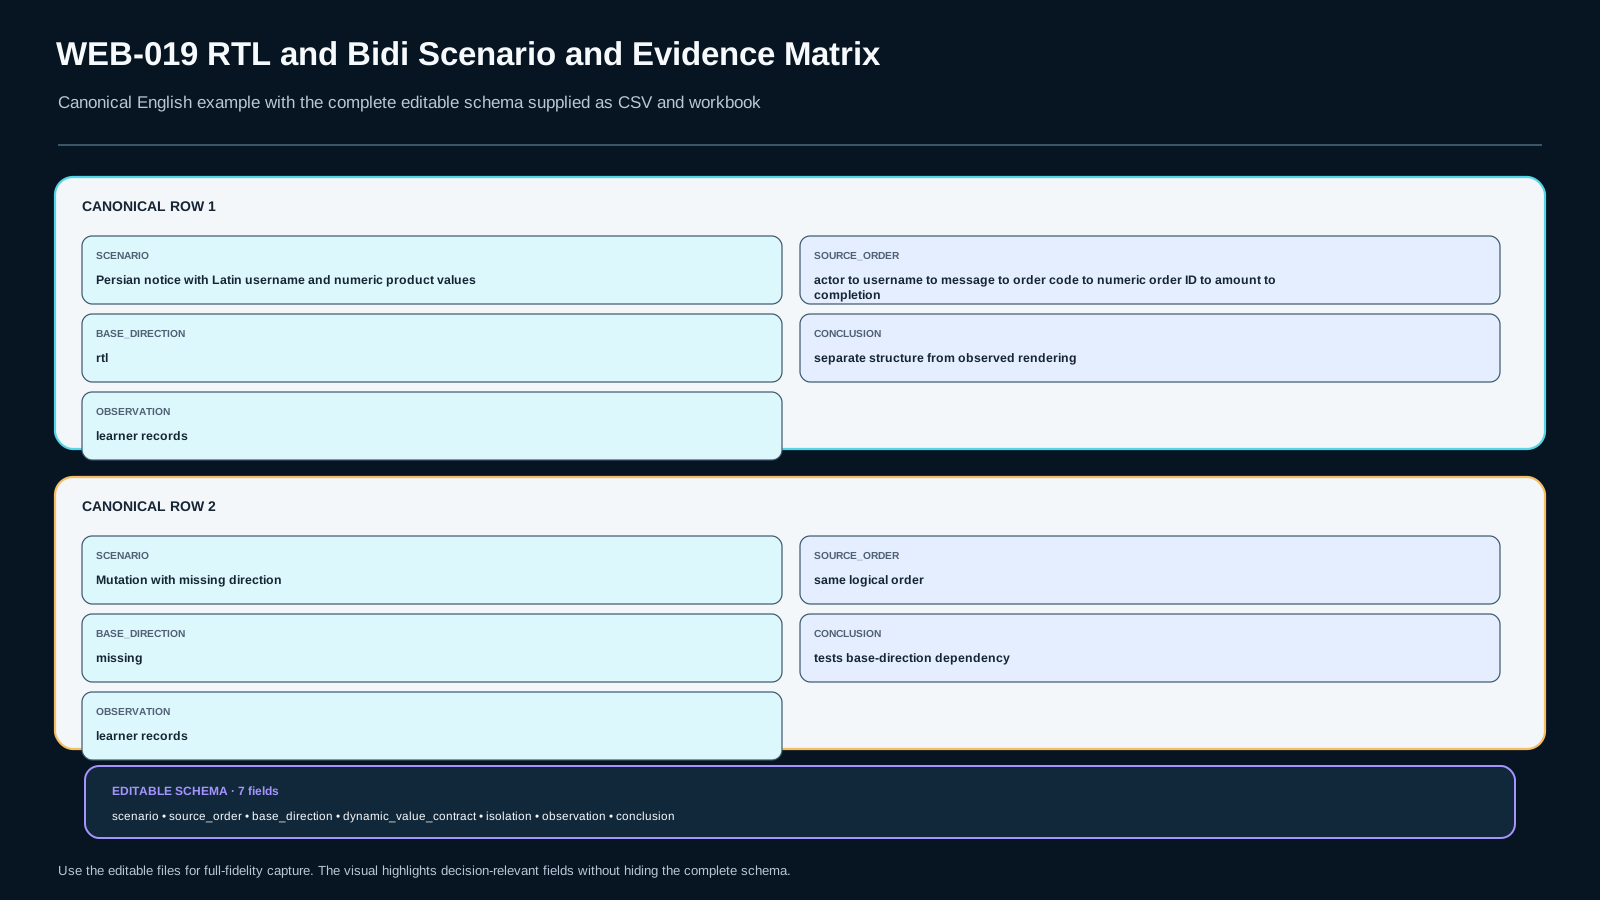
مرحله بعد یک baseline case با Persian sentence + Latin username + LTR order code + numeric-only order ID + amount-like numeric value است. Prediction بنویسید که semantic repair چه چیزی را تغییر میدهد و چه چیزی نباید تغییر کند. سپس base direction را در owned boundary اصلاح کنید و برای dynamic valueهای لازم isolation مناسب قرار دهید. business/source order یعنی actor → username → message → order code → numeric order ID → amount → completion نباید تغییر کند. browser/DOM observation را فقط پس از اجرا و در evidence file وارد کنید.
برای diagnosis یکی از سه mutation را انتخاب کنید: no-dir، no-isolation یا reverse-source. قبل از اجرا observable failure را پیشبینی کنید. mutation را روی copy disposable از repaired submission اجرا کنید، نه روی source اصلی. سپس مشخص کنید کدام critical dimension شکسته شد: logical_vs_visual، base_direction، bidi_isolation یا rtl_product_evidence. repair باید فقط همان boundary را بازگرداند.
در transfer، یک support-ticket notification متفاوت دارید. valueها و punctuation تغییر کردهاند و نباید جواب baseline را mechanically copy کنید. دوباره contract valueها را طبقهبندی کنید و source order را مستقل verify کنید. هدف این است که نشان دهید reasoning منتقل شده است، نه اینکه markup خاص را حفظ کردهاید.
Evidence Record حداقل یک baseline row، یک mutation row و یک changed-context row میخواهد. هر row باید observation و inference را جدا کند، environment را ثبت کند و residual limitation داشته باشد. اگر فقط static checker اجرا کردهاید، حق ندارید visual/browser behavior را «مشاهدهشده» بنویسید.
Verification: چه چیزی واقعاً اثبات شده است؟
Evidence این درس چند لایه است. Implementation evidence فایلهای HTML/CSS/JS و direction/isolation boundaryهای انتخابی را نشان میدهد. Source/DOM evidence ثابت میکند logical order برای ظاهر reverse نشده است. Browser observation فقط چیزی را ثبت میکند که learner واقعاً در environment نامبرده مشاهده کرده است. Mutation evidence نشان میدهد اگر یک critical dimension را عمداً حذف کنیم، conclusion باید تغییر کند. Repair evidence نشان میدهد همان boundary بدون scope creep بازگردانده شده است. Transfer evidence روش را در context متفاوت آزمایش میکند.
Static public checker فقط integrity آموزشی fixture را میسنجد: required files حاضرند، external dependency نداریم، starter هنوز intentional failure است و evidence template معتبر است. پاسشدن این checker به معنی درستبودن rendering یا accessibility نیست. hidden evaluator نیز evidence completeness را ارزیابی میکند و نباید به learner surface راه پیدا کند.
یک evidence row خوب باید input string و source order را ثبت کند؛ base direction و isolation mechanism را توضیح دهد؛ DOM observation و visual observation را از هم جدا کند؛ mutation و prediction را قبل از outcome نگه دارد؛ observed failure، diagnosis، repair و post-repair observation را بنویسد؛ changed context را مشخص کند؛ و observation_vs_inference، environment و residual limitation را خالی نگذارد.
برای residual limitation میتوانید بنویسید که نتیجه به browser/font/test strings مشخص محدود است و همه Unicode sequenceها یا assistive technologyها را پوشش نمیدهد. این limitation شکست نیست؛ نشانه bounded claim است. ادعای «این راهحل برای تمام رشتهها و تمام engineها قطعی است» خارج از evidence موجود است.
Assessment و انتقال یادگیری
S1 — Retrieval، nonblocking. توضیح دهید logical order، visual order، base direction و isolation چه تفاوتی دارند. حداقل یک non-claim بنویسید: right alignment base direction نیست، logical properties bidi isolation نیستند، یا RTL به معنی reverse source نیست.
S2 — Application، blocking. WEB019-LAB1 را repair کنید تا base direction ساختاری و isolation dynamic values مطابق contract باشد، بدون تغییر business/source order. RTL/Bidi Product Evidence Record v1 را با observation واقعی baseline کامل کنید.
S3 — Diagnosis، blocking. یک mutation از no-dir, no-isolation, reverse-source اجرا کنید. prediction را قبل از اجرا ثبت کنید، observed failure را به critical dimension وصل کنید و repair محدود ارائه دهید. assertion بدون observation یا repair خارج از scope قابل قبول نیست.
S4 — Decision، nonblocking. برای یک dynamic value بین bdi dir=auto و explicit known direction تصمیم بگیرید. contract value، alternative، trade-off و evidenceای که ممکن است تصمیم شما را عوض کند ثبت کنید. universal winner claim ندهید.
S5 — Transfer، blocking. changed-context support notification را مستقل حل کنید. content class و punctuation جدید است. logical source order را حفظ کنید، direction/isolation را از contract جدید استنتاج کنید، یک residual limitation بنویسید و نشان دهید که baseline markup را بدون reasoning کپی نکردهاید.
برای عبور از lesson، S2، S3 و S5 blocking هستند. پاسخ متنی بدون executable artifact/evidence برای این سه کافی نیست. S1 و S4 برای تشخیص کیفیت mental model و judgment استفاده میشوند ولی gating مستقیم ندارند.
References و freshness boundary
این درس دقیقاً چهار منبع frozen دارد و authoring اجازه source expansion ندارد:
- Unicode Standard Annex #9 — Unicode Bidirectional Algorithm:
https://www.unicode.org/reports/tr9/ - W3C Internationalization — Structural markup and direction (
dir):https://www.w3.org/International/questions/qa-html-dir - W3C Internationalization — Inline bidi markup and isolation:
https://www.w3.org/International/articles/inline-bidi-markup/ - W3C Internationalization — Bidi markup versus CSS guidance:
https://www.w3.org/International/questions/qa-bidi-css-markup
Source set در Bible در 2026-09-02 بازیابی شده و review_due آن 2026-12-31 است. Profile درس FRESHNESS_SENSITIVE=false دارد؛ بنابراین در این Query network recheck انجام نشده و frozen source set عیناً حفظ شده است. این تصمیم به معنی ادعای availability لحظهای URLها نیست؛ فقط یعنی contract تولید اجازه گسترش یا جایگزینی منابع را در این مرحله نمیدهد و review window هنوز باز است.
هر claim باید در همین boundary بماند. درس وارد spec-level edge caseهای همه bidi control characterها، تمام browser differences یا accessibility behaviorهای platform-specific نمیشود. اگر evidence learner رفتار محیط خاصی را ثبت کند، آن observation باید با environment و limitation همراه باشد و به source authority عمومی تبدیل نشود.
نتیجه درس یک recipe ثابت نیست؛ یک روش قابل دفاع است: logical order را بهعنوان source of truth حفظ کنید، base direction را در semantic boundary اعلام کنید، inline valueهای لازم را isolate کنید، layout را در لایه خودش نگه دارید و correctness را با baseline + mutation + transfer + bounded evidence ثابت کنید.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
WEB-019-S1 retrieval
logical order، visual order، base direction و bidi isolation را در یک component فارسی mixed-text از هم جدا کنید. یک non-claim صریح درباره right alignment، CSS logical properties، source reversal یا bdo بنویسید.
WEB-019-S2 application
WEB019-LAB1 را repair کنید تا notification فارسی base direction ساختاری داشته باشد و dynamic valueهای unknown/opposite-direction با isolation یا explicit direction موجه مدیریت شوند، در حالی که business/source order تغییر نکند. baseline evidence را کامل کنید.
WEB-019-S3 diagnosis
یک mutation عمدی اجرا کنید: حذف structural RTL direction، حذف isolation از dynamic value یا reverse کردن source/DOM order. ابتدا prediction، سپس observation، diagnosis critical dimension، repair محدود و re-observation را ثبت کنید.
WEB-019-S4 decision
برای یک dynamic identifier بین bdi dir=auto، explicit known direction یا نداشتن bidi boundary اضافه تصمیم بگیرید. انتخاب را از value contract دفاع کنید و evidence تغییردهنده تصمیم را بنویسید.
WEB-019-S5 transfer
changed-context support-ticket notification را با user content و punctuation متفاوت مستقل حل کنید. logical source order را حفظ کنید، direction/isolation boundary را از contract جدید انتخاب کنید و changed-context evidence و یک residual limitation ثبت کنید.
ملاکهای ارزیابی (rubric)
Blocking assessments are S2, S3 and S5. Passing evidence must preserve logical source order, establish the owned base-direction boundary structurally, justify isolation/known direction from the value contract, and distinguish direct observation from inference. S3 additionally requires a pre-run prediction, an observed mutation result, diagnosis of one critical dimension, bounded repair and post-repair observation. S5 must use the changed-context transfer fixture independently and include a residual limitation.
S1 and S4 are nonblocking but must not repeat the lesson non-goals as positive guidance. No assessment key is exposed to the learner. Static structure checks are not browser or assistive-technology evidence.
منابع و تازگی
مطالعهٔ موارد (case studies)
فایلهای آزمایشگاه
این fixture عمداً ناقص است. right alignment ظاهری آن را پیادهسازی صحیح RTL فرض نکنید.
- از مسیر
WEB019-LAB1دستورpython run_checks.py --structure-onlyرا اجرا کنید. این حالت فقط failure fixture را میسنجد و rendering را تأیید نمیکند. - پوشه
learner/starter/را در کنار خودش با نامlearner/submission/کپی کنید. فقط submission را repair کنید؛ starter باید دستنخورده بماند. - logical baseline sequence را ثبت کنید:
actor → username → message → order code → numeric order ID → amount → completion. fixture عمداً Latin username، کد alphanumeric، شناسه فقطعددی2048، مقدار amount-like برابر1,250,000و punctuation دارد. - base-direction boundary فارسی را ساختاری repair کنید؛ string یا DOM را reverse نکنید. dynamic valueها را از data contract طبقهبندی کنید و unknown/opposite-direction inline valueها را در صورت نیاز isolate کنید.
- baseline repairشده را در browser خود اجرا کنید و DOM/visual observation مستقیم را در
learner/evidence/learner_evidence.jsonثبت کنید. observation ساختگی ننویسید. - دقیقاً یک mutation را با
python mutation_probe.py --mutation <no-dir|no-isolation|reverse-source>اجرا کنید. ابزار بهصورت پیشفرضlearner/submission/را میخواند و یک copy موقت درmutated/میسازد. ابتدا prediction، سپس observation، diagnosis، repair روی submission اصلی و re-observation را ثبت کنید. - baseline، mutation و changed-context transfer را در سه evidence row مجزا نگه دارید. support-ticket transfer را مستقل حل کنید و آن row را با
changed_context: trueعلامت بزنید. - environment آزمایش و یک residual limitation را بنویسید.
- برای validation محدود ساختار/evidence submission،
python run_checks.pyرا اجرا کنید. PASS این دستور به معنی browser یا assistive-technology correctness نیست.
run_checks.py هیچگاه static check را جایگزین browser/AT observation مستقیم نمیکند. هر ادعای browser/AT فقط باید از observation واقعی learner در environment نامگذاریشده بیاید.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)