وب مدرن، رابط کاربری و تجربهی وب · فصل ۶ — Static-first، SEO و Performance · 54
Technical SEO برای سایت محتوایی
syntax یا framework را میشناسد اما contract، runtime behavior، accessibility و failure boundary را یکپارچه نمیکند. موضوع جاری: «Technical SEO برای سایت محتوایی». میتواند «Technical SEO برای سایت محتوایی» را در یک feature محدود طراحی/پیادهسازی کند و correctness، accessibility یا failure behavior مرتبط را اثبات کند.
خلاصهٔ درس
syntax یا framework را میشناسد اما contract، runtime behavior، accessibility و failure boundary را یکپارچه نمیکند. موضوع جاری: «Technical SEO برای سایت محتوایی».
میتواند «Technical SEO برای سایت محتوایی» را در یک feature محدود طراحی/پیادهسازی کند و correctness، accessibility یا failure behavior مرتبط را اثبات کند.
خروجی این درس
میتواند «Technical SEO برای سایت محتوایی» را در یک feature محدود طراحی/پیادهسازی کند و correctness، accessibility یا failure behavior مرتبط را اثبات کند.
پیشنیازها
۱. صفحه اول: محتوای خوب هم میتواند سیگنالهای متناقض بسازد
فرض کنید یک ناشر مقالهای قوی در مسیر /articles/agent-evaluation دارد، اما همان محتوا از URLهای دارای پارامترهای tracking و sort هم در دسترس است. صفحه از Home لینک شده، Sitemap چند URL را فهرست کرده، robots.txt قواعد Crawl دارد و هر صفحه HTML متادیتا تولید میکند. در مرورگر همهچیز ظاهراً سالم است؛ با این حال قرارداد فنی میتواند ناسازگار باشد: Sitemap ممکن است یک URL رهگیریشده را معرفی کند ولی HTML به Canonical دیگری اشاره کند، یک مسیر در robots.txt مسدود شود و تیم اشتباهاً آن را «حتماً deindex شده» بداند، یا صفحه duplicate خودش را Canonical اعلام کند.
هدف این درس «بالا بردن رتبه در Google» نیست. هدف مهندسی محدود این است که یک Crawl & Index Contract سازگار بسازید که بهصورت محلی قابل بازرسی باشد. مشخص میکنید کدام URL نماینده مطلوب است، کدام مسیر برای crawler قابل دسترسی است، چه URLهایی باید در Sitemap باشند، Rendered HTML چه metadataای دارد و چه لینکهای معمولی HTML مسیر discovery را میسازند. سپس سازگاری این اجزا را با evidence نشان میدهید.
Artifact این درس Technical SEO Crawl & Index Contract Record v1 است. این رکورد observation ثبت میکند، نه پیشبینی traffic. قبولی Lab فقط نشان میدهد fixture محلی از نظر سیگنالهای فنی تعریفشده سازگار است؛ ثابت نمیکند موتور جستوجو URL خاصی را crawl، index، canonical یا rank خواهد کرد.
۲. جهتگیری مسیر: توضیح میتواند کمتر شود، evidence نه
مسیر Foundation: از URL inventory شروع کنید. برای هر URL، canonical موردنظر، crawl access، عضویت در Sitemap، وضعیت title/description در Rendered HTML و منبع internal link را ثبت کنید. هر row باید با یک فایل یا خروجی قابل مشاهده پشتیبانی شود.
مسیر Repair: اگر واژگان SEO را میدانید اما سایت failure دارد، کل سایت را یکجا «SEO» نکنید. یک تناقض را جدا کنید: مشکل در crawl access است، canonical consistency، sitemap coverage، rendered metadata یا link discoverability؟ کوچکترین مرز معیوب را اصلاح و check را دوباره اجرا کنید.
مسیر Experienced: تعریفهای مقدماتی را رد کنید و URL matrix را مثل یک production change review کنید. برای هر Canonical، Sitemap entry و blocked path evidence بخواهید. Mutation suite را اجرا کنید و توضیح دهید چرا هر failure یک contradiction واقعی است، نه صرفاً اختلاف سلیقه.
هر سه مسیر پنج dimension را حفظ میکنند: crawl_index_distinction، canonicalization، sitemap، rendered_metadata و no_ranking_promise.
۳. مدل ذهنی: پنج لایه، یک زنجیره Evidence
Technical SEO را مجموعهای از tagهای پراکنده نبینید. از یک زنجیره استفاده کنید:
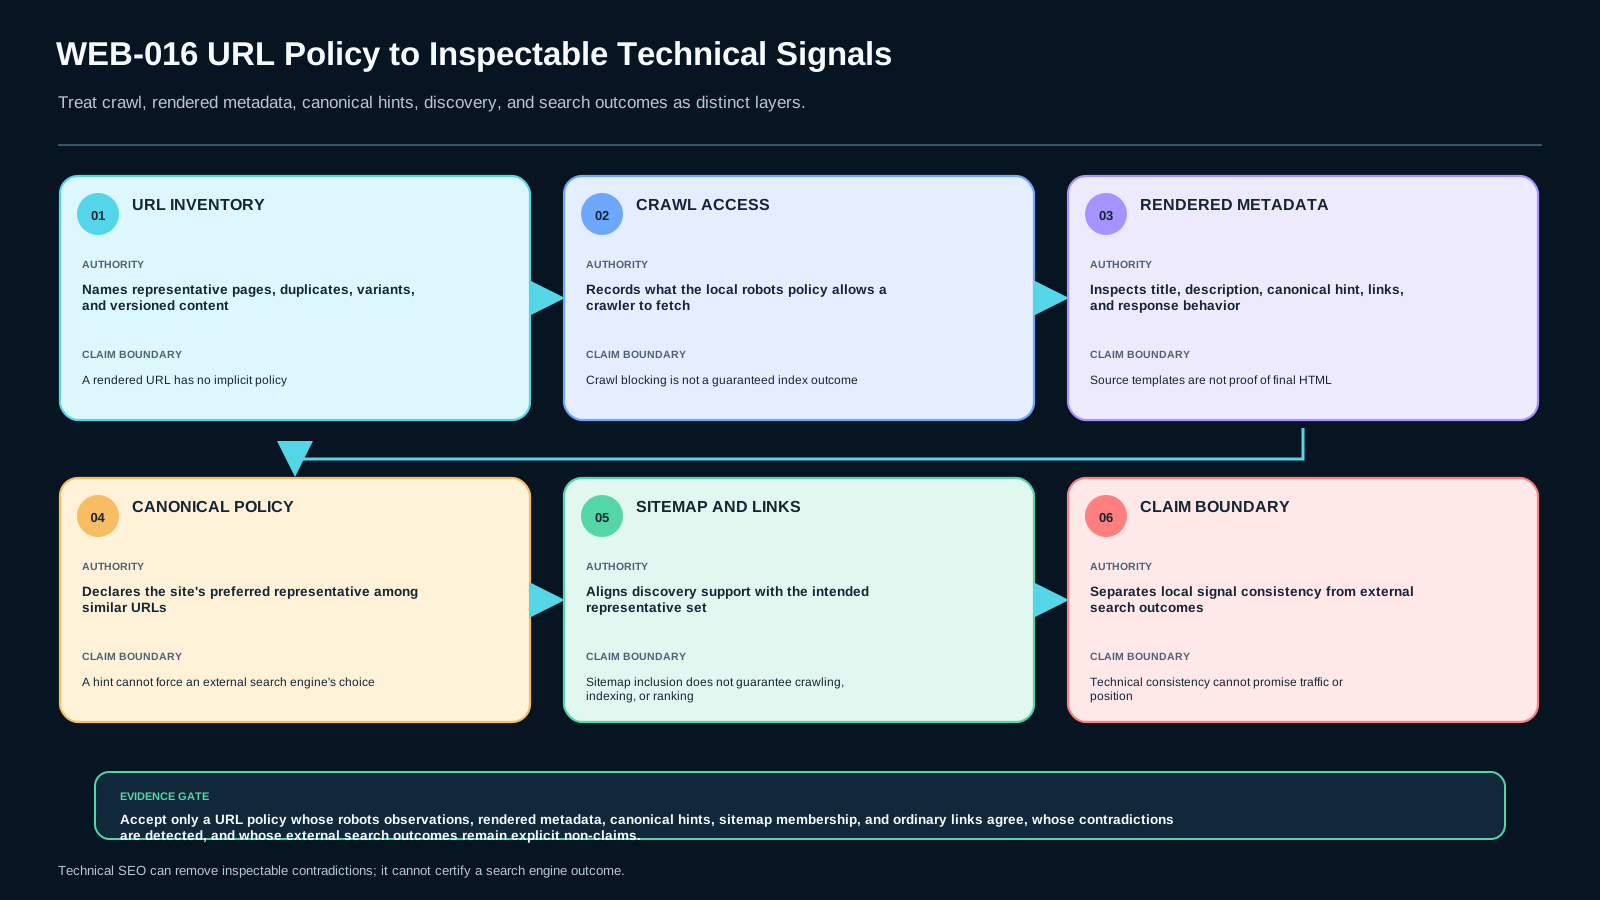
URL inventory → crawl access → rendered metadata → canonical relationship → sitemap/discovery support → observed audit evidence
URL inventory میگوید چه چیزهایی وجود دارند. Crawl access میگوید طبق policy محلی، crawler اجازه fetch کردن یک path را دارد یا نه. این سؤال با «آیا URL در index خواهد بود؟» یکی نیست. تمایز مهم است چون robots.txt ابزار کنترل Crawl است، نه فرمان قطعی و عمومی برای no-index. مستندات فعلی Google این دو مفهوم را از هم جدا نگه میدارند. [S-GSC-ROBOTS]
Rendered metadata همان چیزی است که response نهایی واقعاً دارد. وجود title یا canonical در template کافی نیست اگر HTML نهایی چیز دیگری تولید کند. در fixture این درس <title>، description، canonical link و لینکهای HTML معمولی را بازرسی میکنید.
Canonicalization تعیین میکند کدام URL نماینده ترجیحی مجموعهای از URLهای duplicate یا بسیار مشابه است. Google Canonical را یک signal/preference میداند، نه دستور غیرقابلتخطی؛ redirect، حضور در Sitemap و rel="canonical" میتوانند از این انتخاب پشتیبانی کنند. [S-GSC-CANONICAL]
Sitemap در این درس نقش discovery/coverage دارد. قرارداد محلی ساده است: URLهایی را فهرست کنید که قرار است نماینده Canonical باشند و tracking variantهای شناختهشده را مثل محتوای Canonical مستقل تبلیغ نکنید.
۴. لایه پایه: Crawl Access با Indexability یکی نیست
مهمترین جداسازی این درس بین اجازه fetch شدن URL و نتیجه نهایی Index است. Fixture محلی میتواند اولی را مستقیم بررسی کند: robots.txt را parse کند، path را با ruleها تطبیق دهد و گزارش کند آیا در policy تعریفشده crawl مجاز است. اما دومی را نمیتواند اثبات کند، چون هیچ موتور جستوجوی زندهای در acceptance run وجود ندارد.
برای همین Evidence Record سه label دارد: Observed، Inferred و Not observed. نمونه: «Observed: مسیر /articles/agent-evaluation توسط ruleهای fixture مسدود نشده است.» «Inferred: طبق policy محلی، این صفحه برای crawl باز گذاشته شده.» «Not observed: fetch واقعی Googlebot، وضعیت Index یا Search Console.»
این مدل جلوی یک خطای رایج را میگیرد: مسدود کردن URL در robots.txt و نوشتن «پس حتماً deindex شده است». راهنمای فعلی Google میگوید محتوای صفحه مسدودشده crawl نمیشود، اما خود URL ممکن است بدون snippet در نتایج دیده شود. [S-GSC-ROBOTS] پس conclusion امن فقط این است: path طبق robots policy برای crawl مسدود است. Lab آفلاین حق ندارد این observation را به تضمین Index تبدیل کند.
همین انضباط درباره metadata هم لازم است. Lab فقط حضور یا نبود signal را در Rendered HTML اثبات میکند، نه واکنش قطعی downstream search engine.
۵. توضیح عمیق: Canonical Signalها باید با هم سازگار باشند
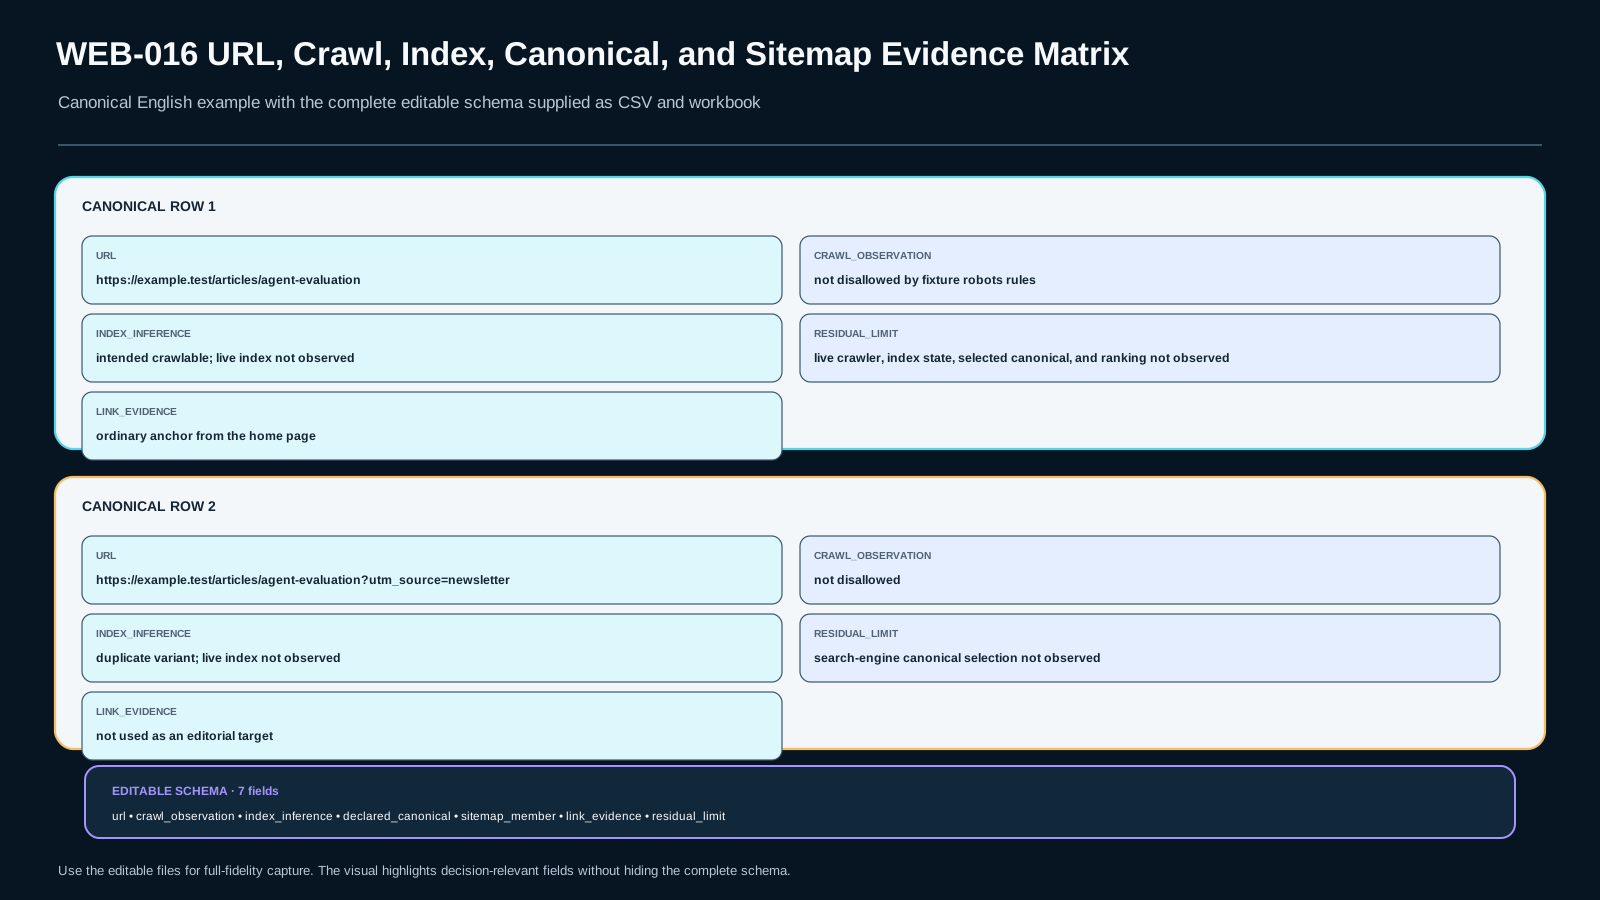
فرض کنید مقاله Canonical در /articles/agent-evaluation است و URL کمپین مانند /articles/agent-evaluation?utm_source=newsletter همان محتوای اصلی را نشان میدهد. در fixture، URL تمیز نماینده مطلوب است. Tracking variant باید Canonical خود را به URL تمیز اشاره دهد؛ Sitemap باید URL تمیز را فهرست کند؛ internal linkهای تحریریه هم باید تا حد ممکن به همان نماینده اشاره کنند.
چرا این هماهنگی مهم است؟ چون signalهای متناقض سیستم را مبهم میکنند. اگر Sitemap یک tracking URL را تبلیغ کند ولی Canonical صفحه URL دیگری باشد، operator باید توضیح دهد کدام intent معتبر است. اگر duplicate خودش را canonical کند، تناقض دیگری میسازید. Lab الگوریتم انتخاب Canonical گوگل را شبیهسازی نمیکند؛ فقط بررسی میکند signalهای اعلامشده توسط خود سایت coherent باشند.
مستندات فعلی Google میگویند Canonicalization فرآیند انتخاب URL نماینده است و signalهایی مانند redirects، sitemap inclusion و rel="canonical" در آن نقش دارند. همان مستندات تأکید میکنند Google ممکن است Canonical دیگری را انتخاب کند. [S-GSC-CANONICAL] بنابراین در Evidence Record بنویسید «preferred canonical declared by the site»، نه «canonical forced on Google».
سطح inspection همان Rendered HTML است. برای هر صفحه مهم، یک Canonical URL absolute، title معنیدار، description در جایی که content policy میخواهد، و لینک HTML معمولی به representative را بررسی کنید. این درس ادعا نمیکند metadata خوب جای content ضعیف را میگیرد.
۶. مثال کارشده: یک مقاله و یک Tracking Variant
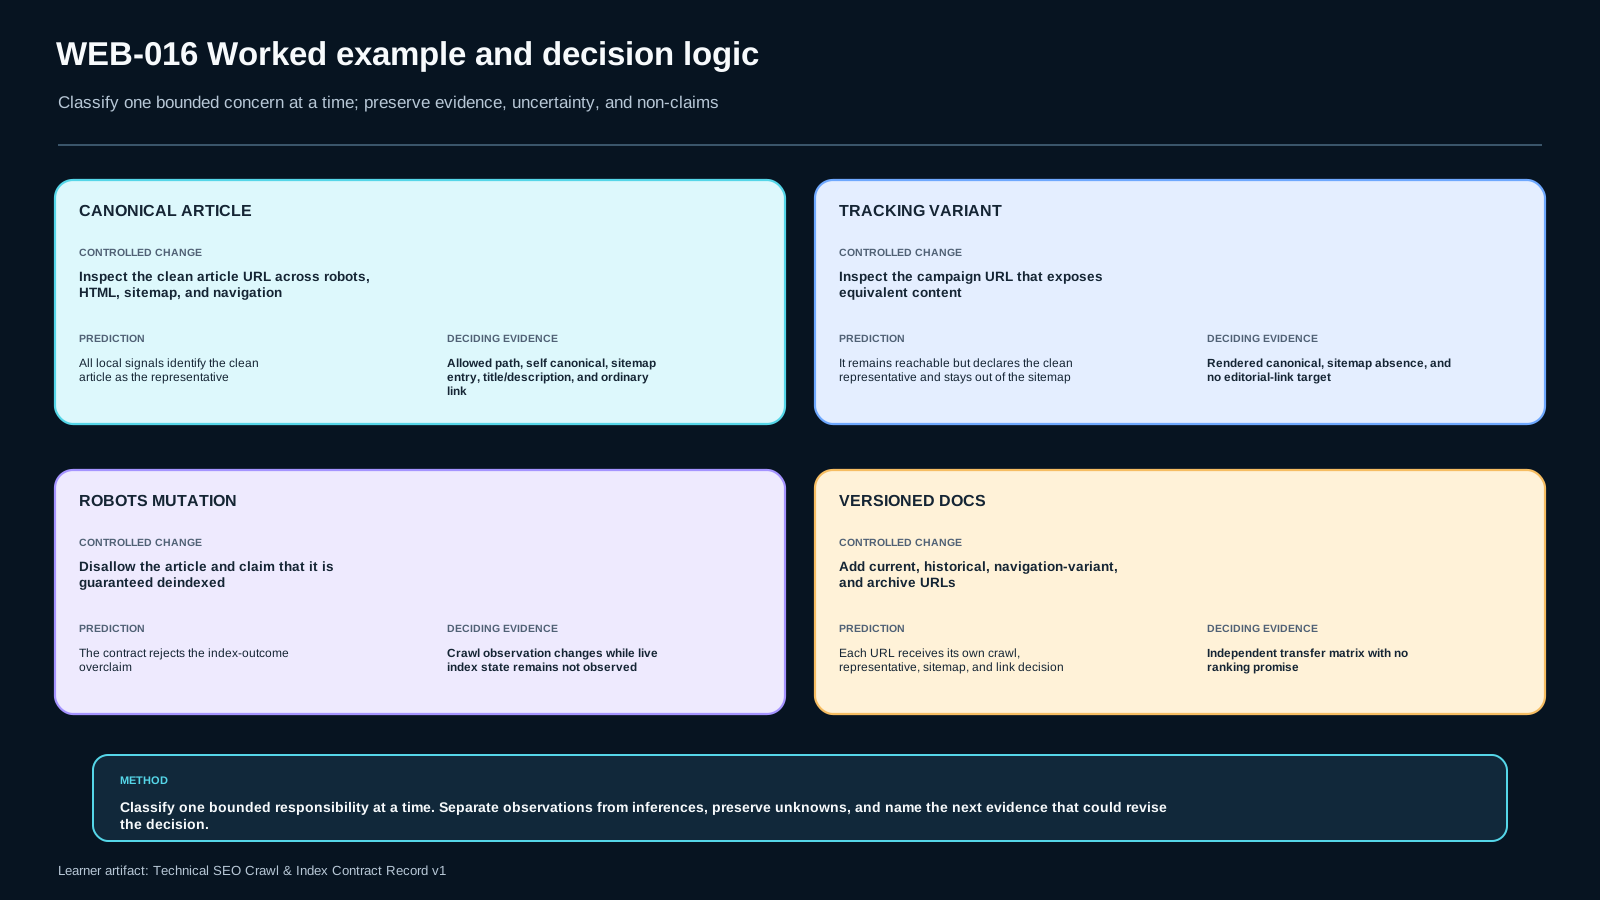
Fixture مرجع یک مقاله Canonical و یک tracking variant دارد. صفحه Canonical این fragment را تولید میکند:
<title>Evaluating AI Agents: A Practical Checklist</title>
<meta name="description" content="A bounded checklist for evaluating agent behavior and evidence." />
<link rel="canonical" href="https://example.test/articles/agent-evaluation" />
Duplicate tracking fixture هم به همین preferred canonical اشاره میکند. Sitemap فقط URL Canonical را دارد:
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url><loc>https://example.test/articles/agent-evaluation</loc></url>
</urlset>
Home page یک <a href="/articles/agent-evaluation"> معمولی دارد. robots.txt baseline هم مسیر مقاله را disallow نمیکند. این چهار observation یک statement محدود را پشتیبانی میکنند: fixture یک مقاله crawlable با Canonical مشخص، duplicate همسو، Sitemap سازگار و مسیر discovery در HTML دارد.
اما همین evidence اجازه نمیدهد بگوییم «صفحه index شده»، «رتبه میگیرد» یا «Google مجبور است همین Canonical را انتخاب کند». این outcomes خارج از Lab آفلاین هستند.
۷. Failure Modeها: تناقض باید قابل مشاهده باشد
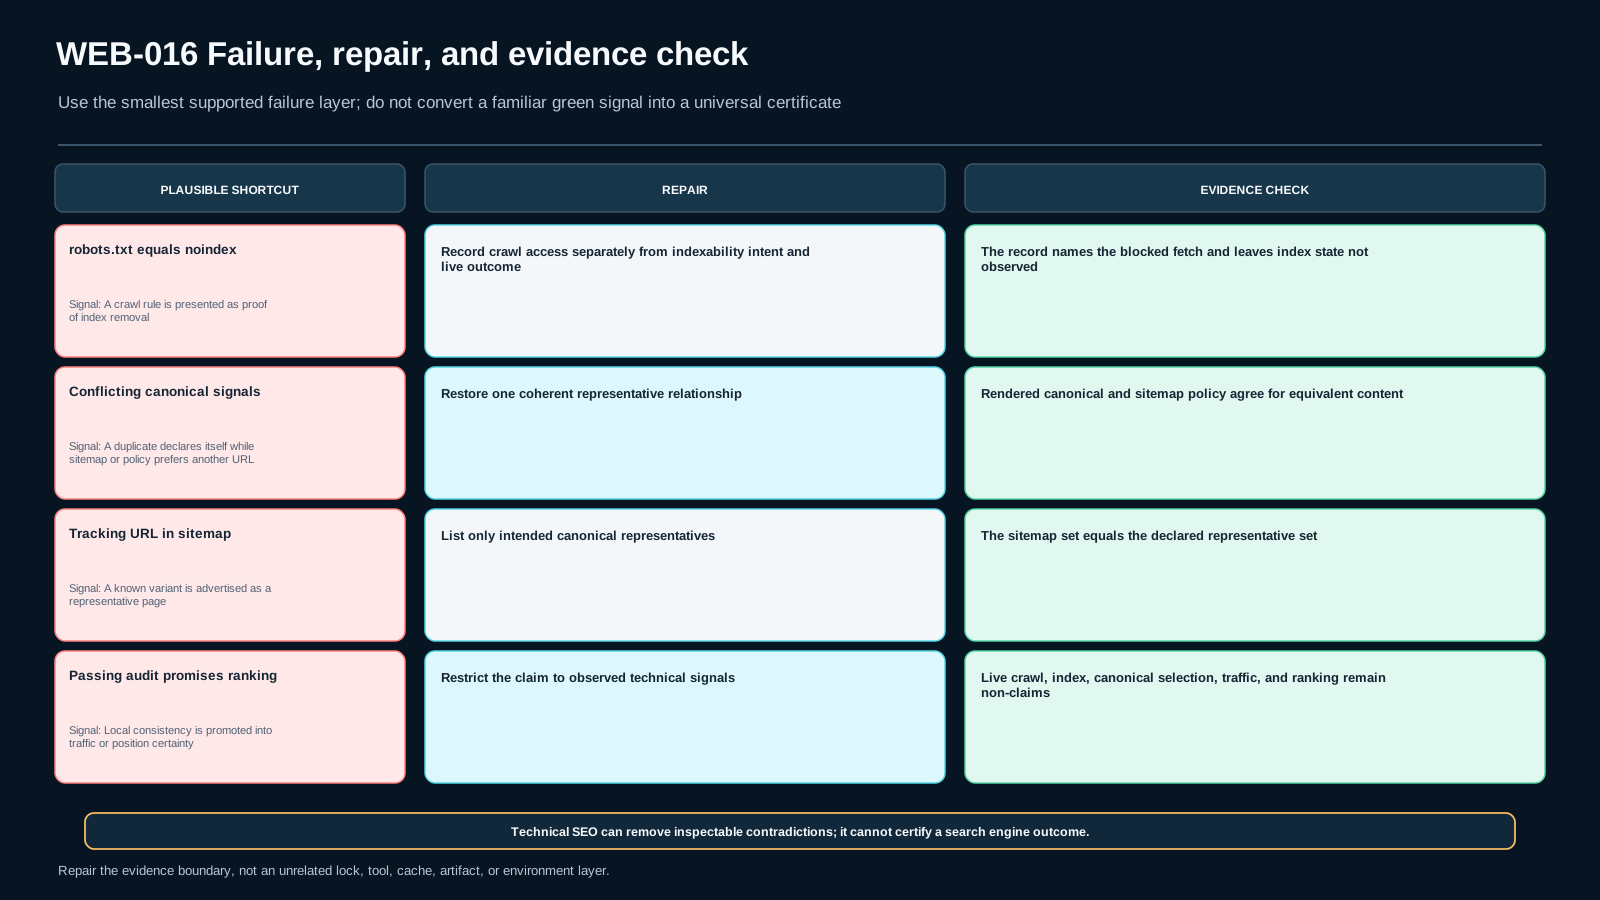
Mutation A — robots shortcut. مسیر مقاله را Disallow کنید و همزمان نتیجه بگیرید «صفحه قطعاً deindex است». Audit باید conclusion را رد کند، چون crawl blocking و index outcome دو موضوع جدا هستند.
Mutation B — conflicting canonical. Tracking variant را self-canonical کنید در حالی که مقاله اصلی URL تمیز را Canonical میداند. Audit باید disagreement را برای محتوای duplicate گزارش کند.
Mutation C — misleading sitemap. Tracking URL را وارد Sitemap کنید در حالی که Canonical آن به URL تمیز اشاره دارد. Sitemap حالا URLی خارج از intended canonical set را تبلیغ میکند.
Mutation D — client-only discovery. لینک HTML معمولی مقاله را حذف کنید و فقط یک marker از client-only state باقی بگذارید. Audit محلی باید فقدان crawlable-link evidence را گزارش کند. این درس ادعا نمیکند تمام JavaScript linkها غیرقابل discovery هستند؛ فقط قرارداد صریح fixture را enforce میکند.
Mutation E — ranking promise. در Evidence Record بنویسید «همه checkها pass شدند، پس صفحه rank خواهد گرفت». رکورد fail است چون consistency فنی، evidence رتبه نیست.
هر mutation باید حداقل یک evidence dimension را تغییر دهد. اگر mutation وارد شود ولی conclusion شما همان بماند، روش verification ضعیف است.
۸. پل حرفهای: URL Policy را مثل Configuration Review کنید
در تیمهای بزرگ، Technical SEO اغلب با configuration drift خراب میشود. CMS مسیر جدید تولید میکند، analytics پارامتر اضافه میکند، migration یک host قدیمی را باز میگذارد، و Sitemap generator جدا از templateهای صفحه کار میکند. پس unit مناسب review یک tag منفرد نیست؛ یک URL-policy diff است.
وقتی URL pattern تازه ظاهر میشود، پنج سؤال بپرسید: آیا باید crawlable باشد؟ آیا representative است یا variant؟ Rendered response چه Canonicalی اعلام میکند؟ آیا باید در Sitemap باشد؟ کدام ordinary internal link نماینده را discoverable میکند؟
Evidence Matrix این سؤالها را به change-control data تبدیل میکند. تغییر CMS که /archive?page=2 یا نسخه جدید documentation route میسازد فقط چون render میشود نباید accept شود؛ باید در URL policy جای مشخص داشته باشد. این موضوع وقتی robots، metadata، sitemap و navigation مال سیستمهای مختلفاند اهمیت بیشتری دارد.
Fast path همچنان یک mutation و یک transfer مستقل میخواهد. تجربه فقط زمان آموزش را کم میکند؛ evidence bar را پایین نمیآورد.
۹. گزینهها و Trade-offها
Redirect وقتی مناسب است که URL واقعاً جابهجا شده و میخواهید user و crawler به مقصد جدید برسند. Canonical annotation میتواند نماینده ترجیحی را بیان کند در حالی که alternate URL همچنان reachable است. این دو mechanism در همه سناریوها interchangeable نیستند. این درس strategy عمومی migration درس نمیدهد؛ فقط میخواهد رابطه representative در سناریوی محدود شفاف و سازگار باشد.
Sitemap برای discovery/coverage مفید است، اما نباید تبدیل به URL policy دوم و متناقض شود. اگر Sitemap generator و canonical generator از normalization ruleهای مختلف استفاده میکنند، policy مشترک را اصلاح کنید، نه اینکه entryها را دستی patch کنید.
Crawl blocking ممکن است دسترسی crawler به path را محدود کند، ولی ابزار مناسبی برای جمله «حتماً deindex میشود» نیست. همینطور audit کامل metadata اثبات content value یا ranking نیست. Contract این درس عمداً محدود است: contradiction فنی قابل مشاهده را حذف کنید و بعد دقیقاً بنویسید چه چیزی هنوز مشاهده نشده است.
۱۰. تمرین هدایتشده و مستقل
داخل learner fixture دستور node --test test/public-contract.test.mjs را اجرا کنید. سپس node src/audit-seo.mjs را اجرا کنید تا audit snapshot deterministic دوباره ساخته شود.
مراحل را به این ترتیب انجام دهید:
seo-plan.jsonرا بخوانید و representative URL هر variant را مشخص کنید.robots.txtرا بررسی کنید و crawl access را جدا از indexability inference بنویسید.- Rendered HTML را برای title، description، canonical و ordinary link بررسی کنید.
- URLهای Sitemap را با intended canonical set مقایسه کنید.
- Public checkها را اجرا و output را در Evidence Record ثبت کنید.
- قبل از هر mutation پیشبینی کنید کدام row باید fail شود.
- fixture را repair و checkها را دوباره اجرا کنید.
- transfer مربوط به documentation site را مستقل تکمیل کنید.
در Transfer، مسیرهایی مثل /docs/v1/guide، /docs/v2/guide و archive اضافه میشوند. نباید solution مقاله را کپی کنید. مشخص کنید کدام URL محتوای مستقل فعلی است، کدام historical ولی معتبر، کدام discoverable، و Canonical/Sitemap/Link evidence چگونه coherent میماند. نتیجه را بدون ranking promise ببندید.
۱۱. Verification و Evidence Record
رکورد شش dimension دارد: implementation artifact، observable generated-output behavior، failure mutation result، repair result، changed-context transfer و residual limitation.
یک row قوی چنین است: «Observed: tracking variant Canonical را https://example.test/articles/agent-evaluation اعلام میکند؛ Sitemap فقط URL تمیز را دارد؛ Home به URL تمیز لینک میدهد. Inferred: representative ترجیحی سایت URL تمیز است. Not observed: Google-selected canonical یا index state.»
یک row ضعیف میگوید «Canonical SEO درست است.» نه فایل inspectشده را نشان میدهد، نه value را، نه مرز uncertainty را.
Environment تست را هم ثبت کنید. Acceptance در Macro-A از Node محلی بدون dependency خارجی و فایلهای static fixture استفاده میکند. هیچ outbound network request و هیچ URL submission به search engine انجام نمیشود. Sourceهای رسمی جداگانه برای freshness recheck شدهاند، اما learner lab کاملاً deterministic و offline باقی میماند.
Residual limitation اجباری است: قبولی این artifact live crawl frequency، index inclusion، canonical selection، rich-result eligibility، traffic یا ranking را اثبات نمیکند.
۱۲. Assessment و Transfer
Retrieval: تفاوت crawl control، index outcome، canonical preference و sitemap discovery support را بدون تعریف موفقیت بر اساس ranking توضیح دهید.
Application: fixture مقاله را coherent کنید و Technical SEO Crawl & Index Contract Record v1 را کامل کنید.
Diagnosis: یک mutation را انتخاب کنید، قبل از اجرا اولین evidence row معیوب را پیشبینی کنید، check را اجرا و علت failure را توضیح دهید.
Decision: یک representative URL را در برابر alternative قابلقبول دفاع کنید. استدلال باید به content identity و evidence consistency تکیه کند، نه جملههای شعاری مانند «Google URL تمیز را دوست دارد».
Transfer: URL policy برای documentation versioning و archive را طراحی کنید. نتیجه باید Canonical representativeها، crawl-access intent، Sitemap membership و discovery linkها را مشخص کند و یک residual uncertainty داشته باشد.
Completion به evidence quality، scope discipline و transfer independence نیاز دارد. پاسخ فنی ظاهراً درست که ranking promise بدهد یا live index evidence جعل کند قبول نیست.
۱۳. منابع و مرز Freshness
Claimهای evolving این درس فقط به سه source رسمی Google در Bible frozen متصلاند. در recheck تاریخ 2026-09-13، مستند canonicalization همچنان Canonical را انتخاب URL نماینده توضیح میدهد و signalهایی مثل redirect، Sitemap inclusion و rel="canonical" را preference میداند، نه فرمانی که Google را مجبور کند. [S-GSC-CANONICAL]
مستند فعلی robots همچنان robots.txt را کنترل دسترسی crawler میداند و میگوید URL مسدودشده ممکن است بدون snippet در index/نتایج ظاهر شود. [S-GSC-ROBOTS] صفحه Search documentation updates فقط freshness anchor برای تشخیص تغییر guidance است و evidence رتبه محسوب نمیشود. [S-GSC-UPDATES]
Review due همان 2026-12-31 باقی میماند. اگر guidance رسمی تغییر کرد یا fixture دیگر boundary مستند را نمایش نداد، زودتر recheck کنید. Source scope را بیسروصدا گسترش ندهید. این درس یک روش inspectable برای technical-SEO consistency را اثبات میکند، نه behavior موتور جستوجو خارج از evidence مشاهدهشده.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
WEB-016-S1 retrieval
قرارداد محدود Technical SEO را بیان کنید: crawl access را از index outcome جدا کنید، canonical preference را یک signal و نه تضمین توضیح دهید و یک non-goal صریح را نام ببرید.
WEB-016-S2 application
fixture محدود سه-URL سایت محتوایی را پیادهسازی کنید: URL نمایندهٔ تمیز، variant تکراری tracking، evidence سازگار برای title/description/canonical/link در خروجی، robots policy و عضویت sitemap؛ evidence record را بدون ادعای live indexing کامل کنید.
WEB-016-S3 diagnosis
یک mutation عمدی در robots access، سازگاری canonical، عضویت sitemap، discovery link، rendered metadata یا مرز evidence/claim را پیشبینی، اجرا، Diagnose و Repair کنید.
WEB-016-S4 decision
مکانیزم انتخابی crawl/canonical/sitemap/metadata را در برابر یک گزینهٔ محتمل دفاع کنید، یک residual uncertainty بیان کنید و توضیح دهید چرا قبولی audit رتبه یا ترافیک را اثبات نمیکند.
WEB-016-S5 transfer
transfer مربوط به documentation نسخهبندیشده را مستقل حل کنید: برای URLهای current، historical و navigation-variant، crawl intent، canonical preference و sitemap membership را تعیین کنید؛ روش evidence و residual limitation را تعریف کنید.
ملاکهای ارزیابی (rubric)
Critical dimensions:
- CRAWL_INDEX_DISTINCTION — Crawl control is observed separately from any unobserved index outcome.
- CANONICALIZATION — Representative-URL preference is supported by coherent local canonical signals without treating
rel=canonicalas a command. - SITEMAP — Sitemap membership aligns with the intended representative URL set and is treated as discovery support, not an indexing guarantee.
- RENDERED_METADATA — Meaningful title, description, canonical and ordinary-link evidence is inspectable in generated/rendered HTML rather than comment-only or template-only facades.
- NO_RANKING_PROMISE / TRANSFER — Evidence stays bounded to local deterministic observations, states residual uncertainty, and transfers independently to versioned documentation without promising live crawling, indexing, canonical selection, traffic or ranking.
Blocking assessments: S2, S3 and S5. S1 and S4 remain non-blocking but must preserve scope discipline and the observation/inference boundary.
The internal synthetic oracle is not a live search-engine observation. No browser/assistive-technology or real-provider network outcome is claimed.
منابع و تازگی
مطالعهٔ موارد (case studies)
فایلهای آزمایشگاه
هدف: یک fixture محتوایی deterministic را از نظر crawl access، rendered metadata، canonical preference، Sitemap membership و ordinary-link discovery بررسی کنید، بدون اینکه live search-engine outcome ادعا شود.
اجرا:
node --test test/public-contract.test.mjs
node src/audit-seo.mjs
Observationها را در evidence/Technical_SEO_Crawl_Index_Contract_Record_v1.json ثبت کنید. قبل از هر mutation نتیجه مورد انتظار را پیشبینی کنید. هیچ account یا URL submission زنده لازم نیست.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)