وب مدرن، رابط کاربری و تجربهی وب · فصل ۳ — Type System، Runtime، Async و Build · 43
Async JavaScript, Timeout و Concurrency Limit
میتواند «Async JavaScript, Timeout و Concurrency Limit» را در یک feature محدود طراحی/پیادهسازی کند و correctness، accessibility یا failure behavior مرتبط را اثبات کند.
خلاصهٔ درس
میتواند «Async JavaScript, Timeout و Concurrency Limit» را در یک feature محدود طراحی/پیادهسازی کند و correctness، accessibility یا failure behavior مرتبط را اثبات کند.
خروجی این درس
میتواند «Async JavaScript, Timeout و Concurrency Limit» را در یک feature محدود طراحی/پیادهسازی کند و correctness، accessibility یا failure behavior مرتبط را اثبات کند.
سریع بودن با کنترلشده بودن یکی نیست
فرض کنید یک صفحه باید تعداد زیادی کار محلی را پردازش کند. کارها به هم وابسته نیستند، هرکدام یک deadline دارند و منبع پاییندستی فقط میتواند تعداد محدودی عملیات فعال را همزمان تحمل کند. دو پیادهسازی ممکن است هر دو از async/await استفاده کنند اما رفتارشان کاملاً متفاوت باشد: یکی ناخواسته همه کارها را سری میکند، دیگری همه را یکباره شروع میکند و بودجه منبع را میشکند. حالت سوم حتی میتواند پیام «timeout» بدهد در حالی که عملیات اصلی هنوز در پسزمینه ادامه دارد.
مالکیت این درس دقیقاً همین مرز است. در پایان باید Async Failure & Concurrency Budget Record v1 را تکمیل کنید؛ سندی که چهار تصمیم را قابل بازرسی میکند: چه چیزی باید سری باشد و چه چیزی اجازه همپوشانی دارد، چند عملیات میتواند همزمان در حال اجرا باشد، نتیجه timeout دقیقاً چه معنایی دارد، و آیا cancellation واقعاً به عملیات زیرین رسیده است یا نه. تکمیل درس به اندازهگیری، mutation عمدی، repair و انتقال مستقل به یک بافت جدید نیاز دارد.
هدف این نیست که «Promiseها بالاخره تمام شوند». هدف ساختن قراردادی برای scheduling است که بتوانید از آن دفاع کنید. async و await ابزارهای کنترل جریان مبتنی بر Promise هستند؛ خودشان اعلام نمیکنند که کارها parallel هستند. Promise.all() مجموعهای از Promiseهای دادهشده را تجمیع میکند اما resource governor نیست. یک race با timer میتواند چیزی را که caller میبیند تغییر دهد، ولی بدون همکاری عملیات اصلی آن را متوقف نمیکند. [S-MDN-ASYNC] [S-MDN-PROMISE] [S-MDN-ABORT]
محدوده، پیشنیازها و مدرک تکمیل
WEB-001 پیشنیاز مفهومی سخت و WEB-002 پیشنیاز نرم است. هرجا به زمینه زبان یا runtime نیاز دارید از شواهد محدود همان درسها استفاده کنید؛ TypeScript یا module resolution را دوباره در این درس آموزش ندهید. WEB-014 مالک code splitting زمان build است. محدوده این درس scheduling در runtime، بودجه concurrency، مشاهده timeout، cancellation تعاونی و شواهد failure است.
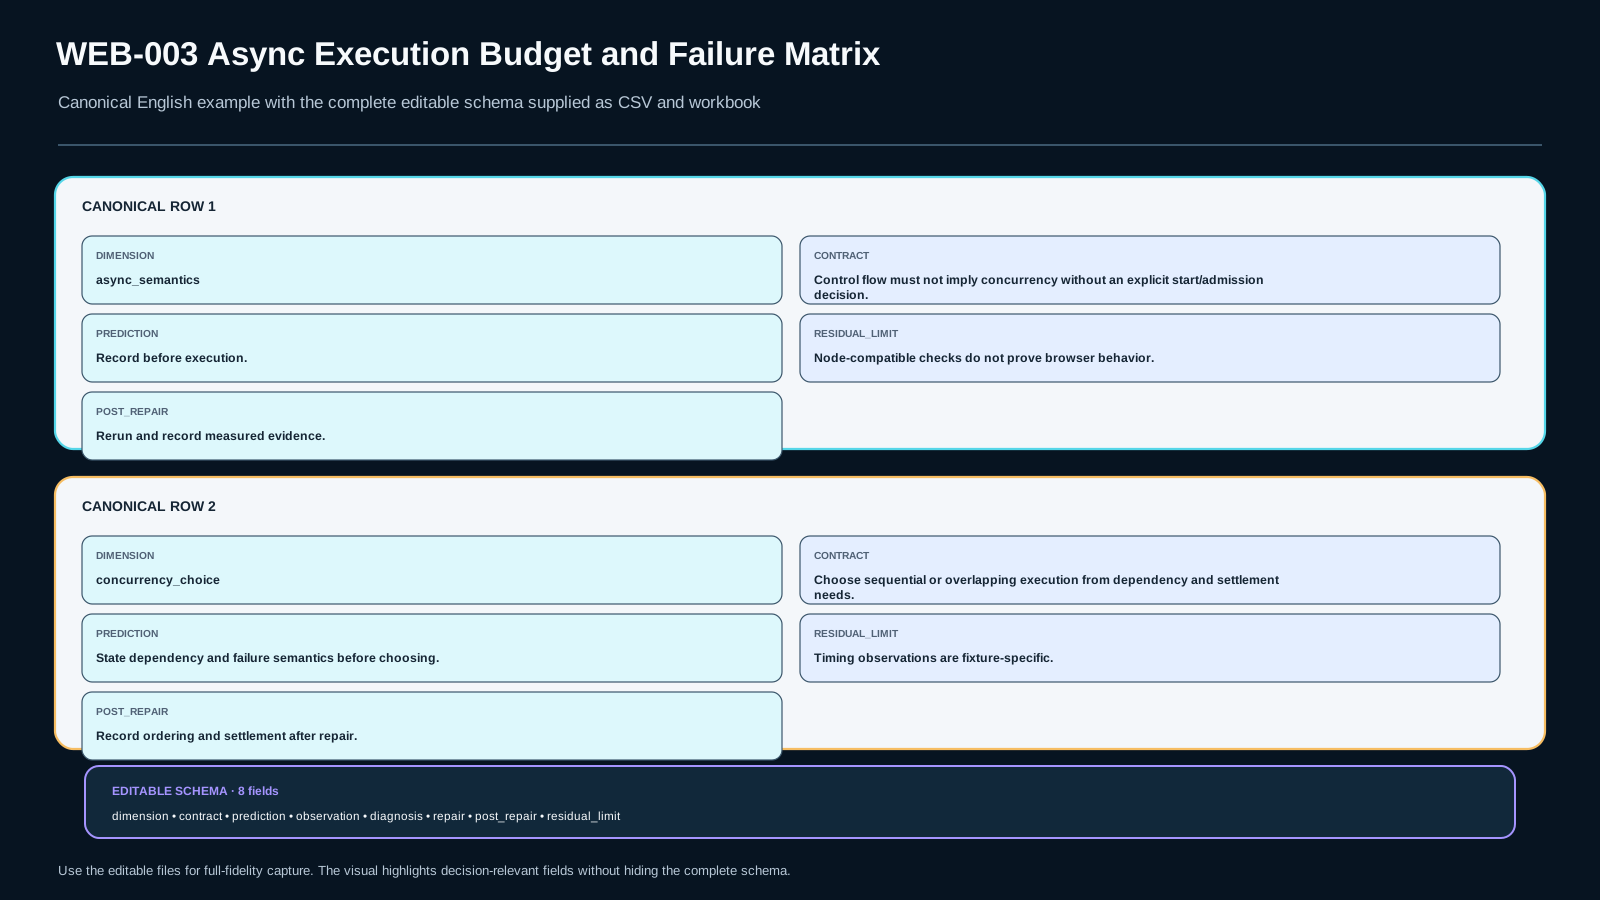
خروجی نهایی شما Async Failure & Concurrency Budget Record v1 است. این artifact باید strategy اجرا، concurrency limit تنظیمشده، peak واقعی عملیات in-flight، settlement behavior، سیاست timeout، مشاهده شدن یا نشدن signal توسط عملیات زیرین، حداقل یک چرخه کامل prediction/observation/diagnosis/repair، انتقال به بافت جدید و یک residual limitation را ثبت کند.
مسیر Foundation: checklist قرارداد را جلوی چشم نگه دارید و fixture راهنما را استفاده کنید. مسیر Repair: فقط یک dimension خراب را جدا کنید، کوچکترین probe را دوباره اجرا کنید و بعد حالت کامل را برگردانید. مسیر Experienced: مرور syntax را کوتاه کنید، اما اندازهگیری peak، تفکیک timeout از cancellation، mutation و transfer حذف نمیشود.
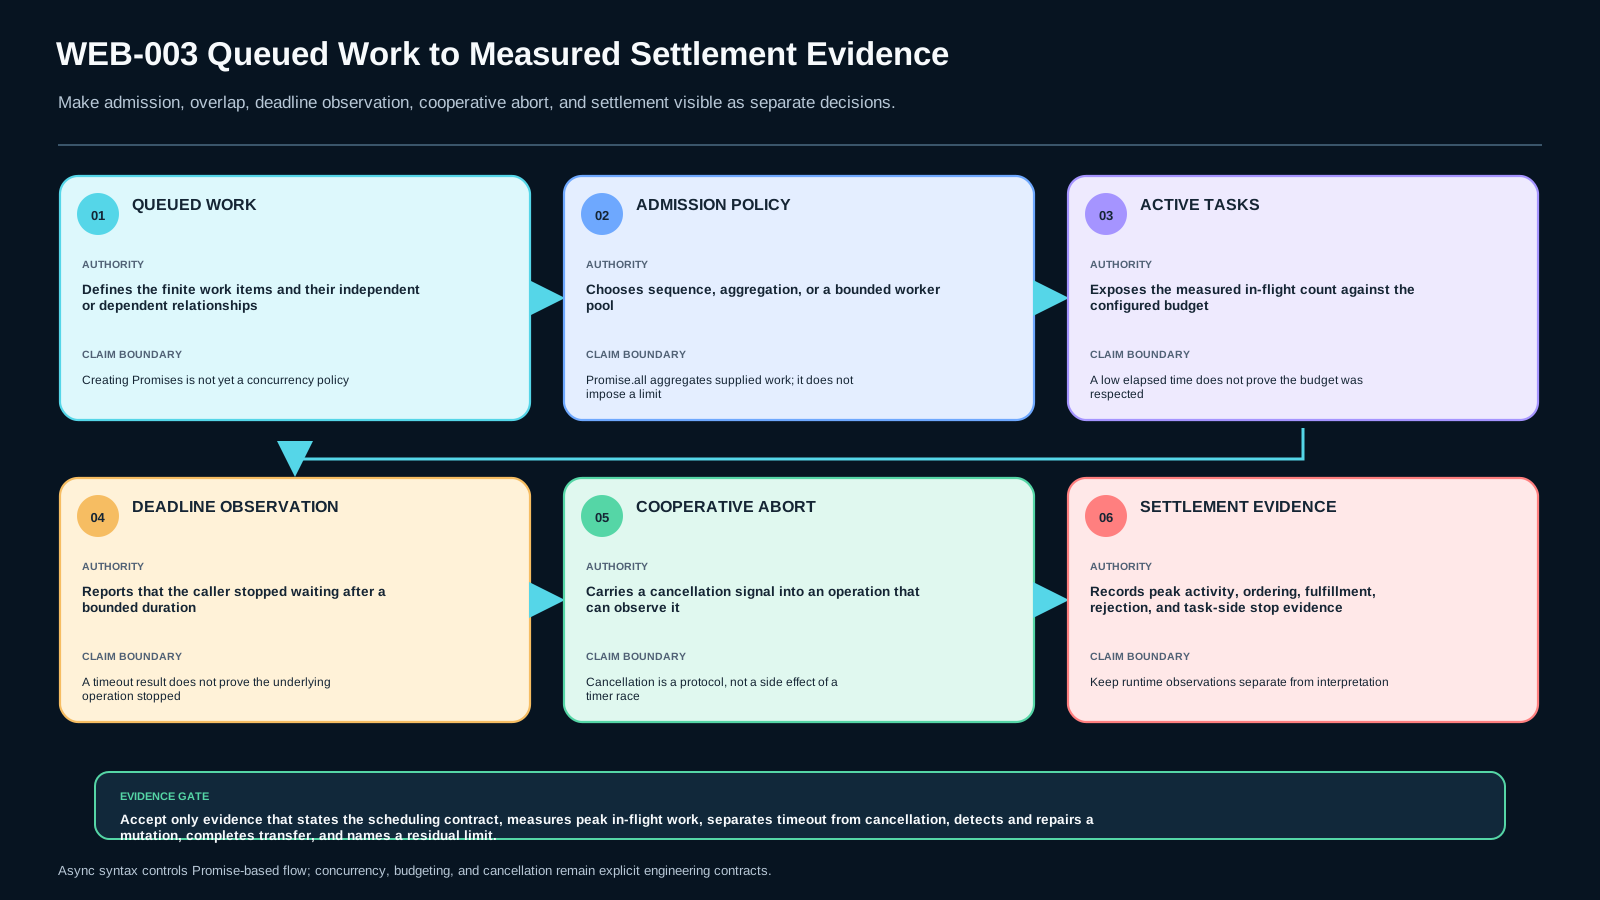
مدل ذهنی: صف → بودجه → کار فعال → deadline/cancel signal → settlement → evidence
قبل از کدنویسی این جریان را در ذهن نگه دارید:
Queued work → scheduler/budget → active promises → timeout/cancel signal → settlement → measured in-flight/failure evidence.
Queue شامل کارهایی است که هنوز شروع نشدهاند. Scheduler تصمیم میگیرد چه زمانی یک item وارد مجموعه active شود. Concurrency budget سقف تعداد عملیات active است، نه یک پیشنهاد. Deadline سیاستی درباره مدت زمانی است که caller حاضر است منتظر بماند. Cancellation یک signal جداگانه است که عملیات زیرین ممکن است پشتیبانی کند یا نکند. Settlement میگوید caller fulfillment یا rejection دیده است؛ بهتنهایی ثابت نمیکند کار پسزمینه متوقف شده است.
برای اندازهگیری دو counter داشته باشید: inFlight و peakInFlight. درست قبل از شروع عملیات منبع، inFlight را زیاد کنید و در مسیر finally کم کنید. این عدد از نگاه کردن به ترتیب logها معتبرتر است. اگر قرارداد میگوید limit = 3 ولی run واقعی peakInFlight = 7 ثبت میکند، حتی اگر همه itemها در نهایت موفق شوند قرارداد شکسته است.
در مورد deadline دو سؤال را جدا پاسخ دهید: caller چه چیزی دید؟ و برای عملیات چه اتفاقی افتاد؟ Promise.race میتواند باعث شود timeout زودتر settle شود؛ اگر عملیات اصلی abort-aware نباشد، کار همچنان ادامه مییابد. AbortSignal مسیر انتقال cancellation را فراهم میکند، اما عملیات باید آن signal را واقعاً بررسی یا مصرف کند تا cancellation اثر بگذارد. [S-MDN-ABORT]
پایه: چهار قرارداد مستقل
۱. قرارداد Async control flow
فراخوانی یک async function یک Promise برمیگرداند. await ادامه همان تابع async را تا settle شدن مقدار متوقف میکند؛ محیط JavaScript را متوقف نمیکند و تضمین parallel execution هم نیست. اگر داخل loop روی هر item await کنید، کارهای مستقل میتوانند عمداً یا ناخواسته سری شوند. اگر چند عملیات را قبل از await ساختید، ممکن است همپوشانی داشته باشند. تصمیم باید از dependency و failure semantics بیاید، نه از خود keyword. [S-MDN-ASYNC]
۲. قرارداد انتخاب concurrency
اجرای sequential زمانی مناسب است که B به A وابسته است، ترتیب بخشی از requirement است یا منبع فقط یک عملیات فعال را تحمل میکند. Concurrent aggregation برای کارهای مستقل مناسب است، به شرطی که resource overlap را بپذیرد. متدهای static مربوط به Promise مشخص میکنند گروه Promiseهای دادهشده چگونه settle شود؛ تعیین نمیکنند چند عملیات شروع شود. [S-MDN-PROMISE]
۳. قرارداد concurrency budget
وقتی یک سرویس، browser resource، device یا simulator محلی بودجه مشخص دارد، scheduler باید admission را کنترل کند. یک pattern ساده worker pool است: به تعداد limit worker بسازید؛ هر worker یک item از صف میگیرد، آن را await میکند و سپس item بعدی را برمیدارد. property مهم قابل مشاهده است: peakInFlight <= limit در همان مرز عملیاتی که اندازهگیری میکنید.
خود عدد limit تصمیم محصول یا resource است، نه ثابت جهانی JavaScript. عدد ۳ در lab فقط برای همین fixture است و نباید به گزاره «سه همیشه بهترین concurrency است» تبدیل شود.
۴. قرارداد timeout/cancellation
Timeout میتواند صرفاً یعنی «caller بعد از N میلیثانیه دیگر منتظر نمیماند». Cancellation یعنی «عملیات signal توقف را دریافت میکند و همکاری میکند». این دو میتوانند با هم استفاده شوند ولی مترادف نیستند. بنابراین evidence باید هم deadline outcome را ثبت کند و هم اینکه task signal را دیده یا نه. اگر task abort-aware نیست، timeout را گزارش کنید ولی ادعای cancellation نکنید.
توضیح عمیق: serialization ناخواسته و fan-out بیحد از کجا میآید؟
شش item مستقل را در نظر بگیرید. این loop خوانا است:
for (const item of items) {
  await doWork(item);
}
این کد property روشنی دارد: حداکثر یک doWork فعال است. هزینهاش هم روشن است: کارهای مستقل overlap ندارند. اگر هر item تقریباً 100ms زمان ببرد، شش item تقریباً شش موج زمانی میخواهند، در حالی که limit سه میتواند آنها را در حدود دو موج اجرا کند. اگر ordering لازم است همین رفتار درست است؛ اگر dependency ندارید ممکن است serialization تصادفی باشد.
حالا این کد را ببینید:
await Promise.all(items.map(doWork));map معمولاً doWork را برای همه itemها قبل از منتظر شدن Promise.all صدا میزند. در نتیجه برای شش item، peak میتواند شش باشد. سپس Promise.all وقتی همه fulfill شوند fulfill میشود و با اولین rejection قابل مشاهده reject میشود. این settlement semantics مفید است، اما concurrency limit نیست. [S-MDN-PROMISE]
Bounded scheduler ساختن کار را از admission به مجموعه active جدا میکند. هر worker بعد از پایان item فعلی سراغ بعدی میرود و چند worker میتوانند همزمان فعال باشند. با سه worker و شش item، peak باید حداکثر سه بماند. این contract قابل اندازهگیری و mutation است.
در timeout هم یک مرز پنهان مشابه وجود دارد. wrapper رایج doWork() را با timer race میدهد. اگر timer زودتر reject شود، wrapper timeout میدهد اما doWork() همچنان مالک timer، fetch، stream یا resource خودش است. برای ادعای cancellation باید signal را به عملیاتی بدهید که cancellation را پشتیبانی میکند و سپس مشاهده کنید مسیر abort اجرا شده است. AbortSignal.timeout() در محیطهای پشتیبان میتواند signal زمانمحور بسازد، اما اصل همان است: signal فقط وقتی اثر دارد که عملیات پاسخ دهد. [S-MDN-ABORT]
Error policy را هم صریح کنید. Promise.all از دید caller aggregate fail-fast است، ولی siblingهایی که شروع شدهاند خودکار rollback یا cancel نمیشوند. Worker pool میتواند بعد از failure پذیرش item جدید را متوقف کند، همه outcomeها را جمع کند، یا اگر operation پشتیبانی میکند active work را abort کند. این رفتار باید تصمیم باشد، نه تصادف implementation.
مثال کامل: شش job، limit سه، یک deadline
Fixture آزمایشگاه jobهای محلی deterministic با delay کوتاه و counter میسازد. ابتدا سه strategy را روی همان work list مقایسه کنید.
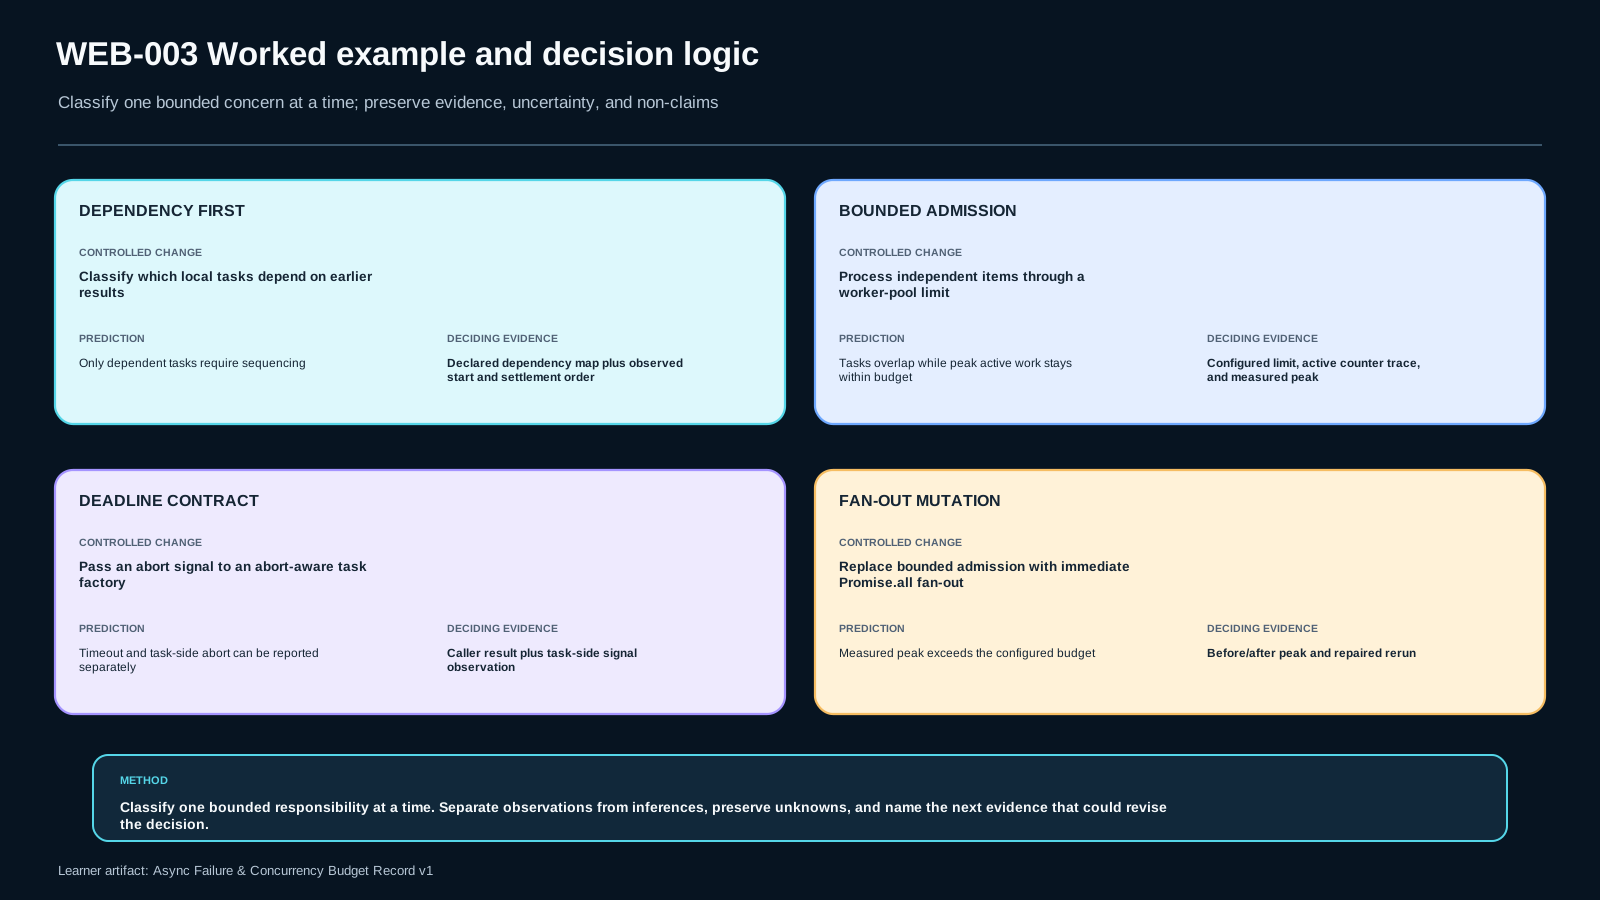
Sequential baseline. قبل از اجرا پیشبینی کنید peakInFlight = 1. elapsed time، completion order و settlementها را ثبت کنید. این baseline نمونه intentional serialization است.
Immediate aggregation. Scheduler را با fan-out مستقیم Promise.all جایگزین کنید. قبل از run پیشبینی کنید peak تا تعداد itemهای همزمان بالا میرود. Counter را مشاهده کنید. اگر limit سه و peak شش است، تشخیص درست «Promise.all بد است» نیست؛ تشخیص این است که این admission strategy بودجه همین fixture را نقض میکند.
Bounded worker pool. همان itemها را با limit = 3 اجرا کنید. peakInFlight را ثبت کنید. run موفق باید peak را در سه یا کمتر نگه دارد و همچنان اجازه overlap به کارهای مستقل بدهد.
بعد یک deadline case اضافه کنید. یک task abort-aware بسازید، signal را به آن بدهید و دو fact را ثبت کنید: caller نتیجه timeout/abort دیده است و task قبل از normal completion signal را مشاهده کرده است. سپس همان timeout را روی taskی اجرا کنید که signal را نادیده میگیرد. Caller ممکن است timeout ببیند، اما evidence باید نشان دهد کار زیرین ادامه یافته است. تفاوت این دو، هدف اصلی probe است.
جدول WEB-003-TAB1 را سطر به سطر تکمیل کنید: contract، mechanism، prediction، observation، diagnosis، repair، post-repair evidence و residual limitation. واژههایی مثل «سریع»، «ایمن» یا «cancelled» بدون observation دقیق evidence محسوب نمیشوند.
Failure modeها: سه mutation که باید نتیجه شما را تغییر دهند
Mutation A — fan-out بدون limit
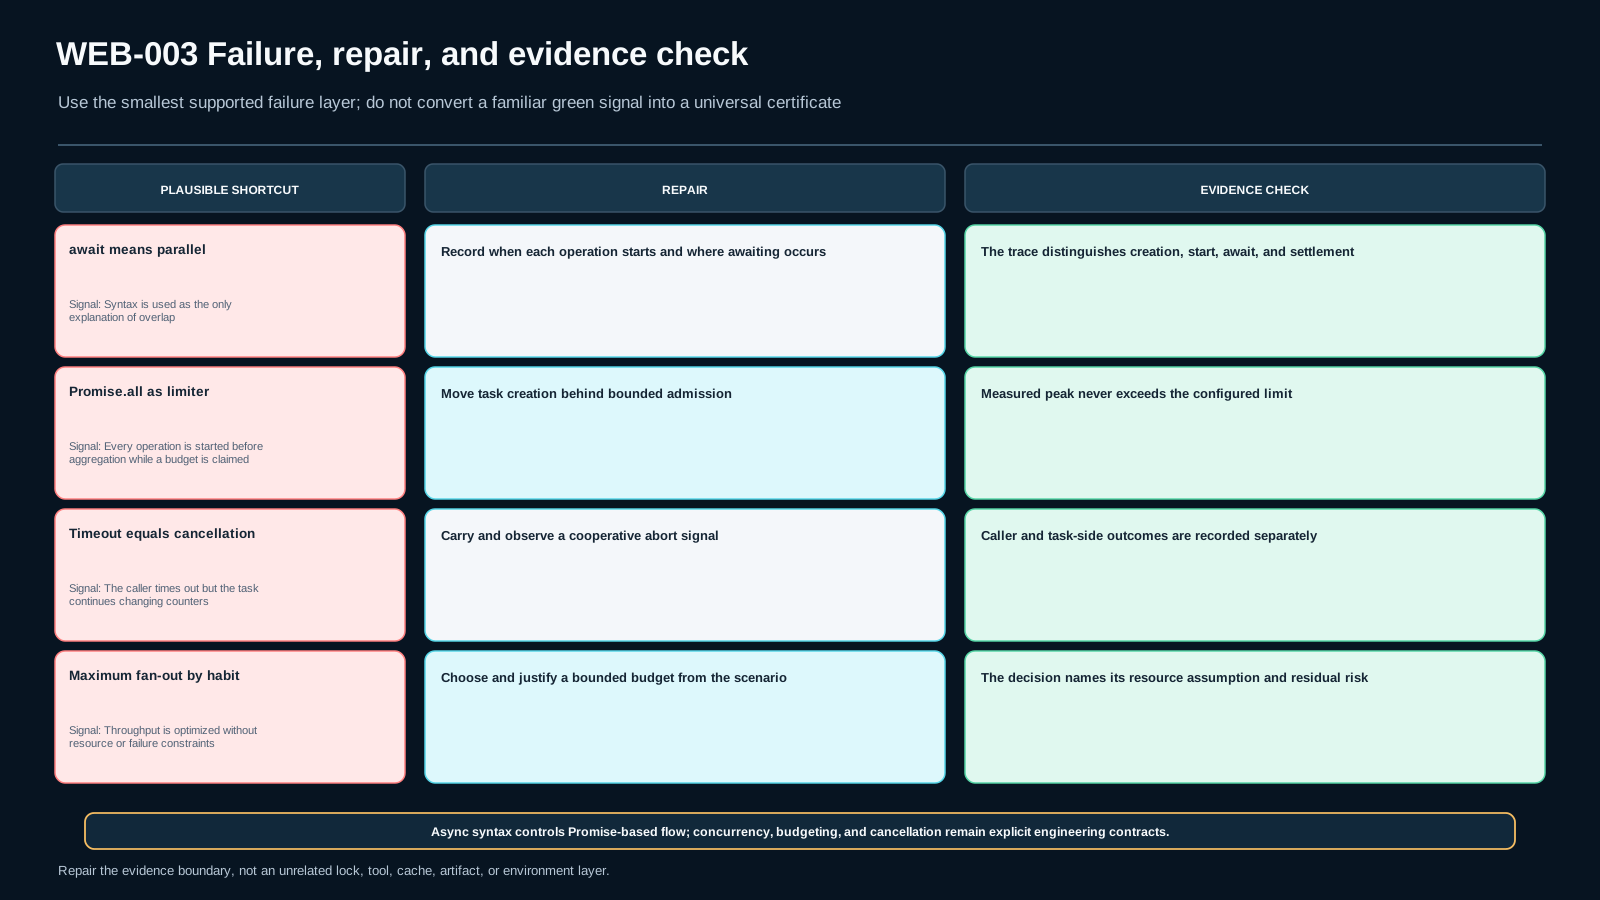
از baseline درست، bounded scheduler را bypass کنید و همه jobها را با Promise.all یکباره شروع کنید. Peak را قبل از اجرا پیشبینی کنید. اگر هشت item و budget سه است، peakInFlight باید از سه بالاتر برود. Repair یعنی admission control را برگردانید؛ پنهان کردن counter یا بالا بردن budget بعد از مشاهده failure repair معتبر نیست.
Mutation B — timeout بدون cooperation
Timeout wrapper را نگه دارید اما signal handling را از task حذف کنید. دو observation را پیشبینی کنید: caller همچنان deadline outcome میبیند و task آنقدر ادامه میدهد که normal completion ثبت شود. تشخیص: timeout without cancellation. Repair: signal را به operation پشتیبان cancellation وصل کنید و مسیر abort را مشاهده کنید.
Mutation C — serialization ناخواسته
روی کارهای مستقل await را داخل loop قرار دهید. peakInFlight = 1 و elapsed time بیشتر را پیشبینی کنید. این رفتار همیشه غلط نیست؛ فقط وقتی requirement اجازه overlap میدهد و انتظار استفاده از bounded budget را دارد defect است. Repair یعنی overlap محدود را برگردانید و سقف را حفظ کنید.
این probeها چهار shortcut را رد میکنند: «async یعنی parallel»، «Promise.all خودش limit میگذارد»، «timeout یعنی cancel شده»، و «هرچه concurrency بیشتر باشد بهتر است». Record نهایی باید به اندازهای evidence داشته باشد که هر چهار گزاره بدون سلیقه شخصی رد شوند.
مسیر Experienced: policy را قبل از syntax مشخص کنید
اگر هر روز با Promise کار میکنید، تمرکز را روی policy بگذارید. قبل از implementation این تصمیمها را بنویسید:
- کدام operationها آنقدر مستقل هستند که overlap داشته باشند؟
- چه resourceای concurrency budget را تعیین میکند؟
- Budget سقف است، target است یا هر دو؟ در این درس سقف بودن اجباری است.
- بعد از failure یک task چه میشود: admission متوقف، outcomeها جمع، یا active work abort میشود؟
- «timeout» برای caller دقیقاً چه معنی دارد؟
- کدام operation واقعاً cancellation را پشتیبانی میکند و evidence آن چیست؟
- چه چیزی را میتوانید بدون ساختن browser/network evidence اندازه بگیرید؟
بعد همان boundary را instrument کنید. Active resource operation را بشمارید، نه تعداد Promiseهای queue شده را. Settlement و abort event را با item ID ثبت کنید. مقایسه timing را فقط در حد fixture deterministic تفسیر کنید؛ برای نتیجهگیری performance عمومی به evidence وسیعتری نیاز دارید.
در codebase حرفهای scheduling ممکن است داخل helper، retry library، SDK یا request client پنهان شده باشد. این قرارداد را حذف نمیکند؛ فقط محل بازرسی را تغییر میدهد. اگر SDK خودش pool دارد، رفتار مستند/مشاهدهشده آن را بررسی کنید و بدون دلیل limiter دوم نسازید.
گزینهها و trade-offها
Sequential loop
مزیت: مدل ordering ساده، peak برابر یک، محل failure روشن. هزینه: کار مستقل overlap ندارد. وقتی dependency، order یا resource constraint توجیه میکند انتخابش کنید، نه فقط چون سادهترین محل قرار دادن await است.
Promise.all مستقیم
مزیت: aggregation کوتاه و semantics روشن برای گروه Promiseهای از قبل ساختهشده. هزینه: شروع عملیات را محدود نمیکند و یک rejection siblingهای شروعشده را خودکار cancel نمیکند. فقط وقتی fan-out متناسب با batch قابل قبول است یا لایه دیگری admission را کنترل میکند انتخابش کنید.
Worker pool محدود
مزیت: admission control صریح و peak قابل اندازهگیری. هزینه: scheduling code بیشتر و نیاز به failure policy. وقتی resource budget دارید مناسب است. Semaphore یا limiter library میتواند همین مفهوم را بدهد؛ lab implementation کوچک استفاده میکند تا evidence boundary واضح بماند.
Timer race در برابر deadline abort-aware
Timer race کافی است وقتی قرارداد محصول فقط «بعد از deadline دیگر منتظر نمان و late result را نادیده بگیر» باشد و ادامه عملیات ضرری نداشته باشد. وقتی قرارداد میگوید خود کار باید متوقف شود و operation cancellation را پشتیبانی میکند، deadline abort-aware لازم است. از mechanism ضعیفتر semantics قویتر نتیجه نگیرید.
Fail-fast در برابر collect-all
Promise.all aggregate را با اولین rejection قابل مشاهده reject میکند. Promise.allSettled برای همه Promiseهای دادهشده صبر میکند و outcome هرکدام را میدهد. هیچکدام concurrency budget نیستند. Settlement semantics و admission control دو تصمیم جدا هستند.
تمرین هدایتشده و سپس transfer مستقل
lab://WEB-003/WEB003-LAB1 را باز کنید. Starter عمداً دو mechanism ضعیف دارد: scheduler همهچیز-همزمان و timeout raceای که cancellation را به task منتقل نمیکند. قبل از edit، public structural check را اجرا کنید، simulator را بخوانید و peak و deadline behavior را پیشبینی کنید.
Guided repair: schedulerی بسازید که active count هرگز از limit بیشتر نشود. Interface عمومی function را ثابت نگه دارید. سپس deadline path را طوری اصلاح کنید که task abort-aware signal دریافت کند. Fixture را اجرا و baseline evidence را ثبت کنید. Mutation probe را اجرا کنید و حداقل یک زنجیره کامل prediction → observation → diagnosis → repair → post-repair را بنویسید.
Independent transfer: fixture انتقال تعداد item، delayها، محل failure و concurrency budget را تغییر میدهد. عددهای guided case را copy نکنید. Expected peak را دوباره استنتاج کنید، failure policy را انتخاب کنید، همان contract را در بافت جدید پیاده کنید و transfer block مستقل را کامل کنید.
اگر محیط شما browser واقعی برای observation ندارد، evidence ساختگی نسازید. Node-compatible checkها میتوانند scheduling core و counter را ثابت کنند؛ browser/DOM claim تا زمان مشاهده واقعی باید صریحاً unclaimed بماند.
Verification: چه چیزی evidence محسوب میشود؟
در record بین observation و inference فاصله بگذارید. «Counter در این run deterministic حداکثر ۳ شد» observation است. «Scheduler برای این fixture سقف تنظیمشده را enforce کرد» inference محدود و قابل دفاع است. «این کد هیچ API واقعی را overload نمیکند» بدون evidence کافی است.
حداقل سطرهای evidence:
- strategy sequential: peak مشاهدهشده و settlement؛
- mutation fan-out: peak پیشبینیشده و واقعی؛
- bounded scheduler: limit و peak واقعی؛
- timeout با signal تعاونی: caller outcome و مشاهده abort در task؛
- timeout بدون cooperation: timeout caller به همراه late completion عملیات؛
- یک failure تزریقشده: failure policy و رفتار siblingها؛
- repaired baseline: evidence بعد از repair؛
- changed-context transfer: measurement مستقل؛
- residual limitation: یک شرطی که fixture ثابت نمیکند.
این lab برای بررسی contract deterministic است، نه benchmark performance. Timer scheduling، load مرورگر، network واقعی، rate limit سرور و cancellation در سرویسهای ثالث میتواند متفاوت باشد. این boundary را در artifact بنویسید.
Assessment و transfer
S1 — retrieval. Core contract و یک non-goal را بیان کنید. پاسخ خوب async control flow را از concurrency جدا میکند. برای این سؤال retrieval-only، mutation/repair evidence شرط ذاتی پاسخ نیست.
S2 — application. Feature محدود را پیاده کنید و peak، settlement و timeout/cancellation evidence را در artifact ثبت کنید.
S3 — diagnosis. یک mutation عمدی اجرا کنید. قبل از run failure را پیشبینی کنید، observation را ثبت کنید، dimension خراب را نام ببرید، repair کنید و post-repair evidence نشان دهید.
S4 — decision. Mechanism انتخابی را در برابر alternative قابل قبول دفاع کنید. استدلال باید به dependency، resource budget، failure semantics و cancellation support وصل باشد؛ نه اینکه یک pattern JavaScript را همیشه بهترین بداند.
S5 — transfer. Fixture تغییرکرده را مستقل حل کنید. Bound و deadline behavior را از requirements جدید دوباره محاسبه کنید. Transfer blocking است؛ copy کردن اعداد guided case یا ادعای evidence مشاهدهنشده قبول نیست.
Submission کامل همچنان میتواند uncertainty داشته باشد و باید یک residual limitation مشخص داشته باشد؛ مثلاً cancellation در network واقعی تست نشده یا browser scheduling متغیر است. limitation باید آنقدر دقیق باشد که جلوی overclaim را بگیرد.
منابع و مرز freshness
این درس فقط از source set فریزشده Bible استفاده میکند:
- S-MDN-ASYNC — MDN،
async function: Promise-returning behavior و semantics مربوط بهawait. - S-MDN-PROMISE — MDN،
Promise: static concurrency methods و settlement semantics. - S-MDN-ABORT — MDN،
AbortSignal: cancellation signalling و signalهای زمانمحور.
Claimهای خارجی به همین boundaries محدود هستند؛ منابع در 2026-09-02 بازیابی شدهاند و review_due آنها 2026-10-17 است. از آنها نتیجه نمیگیریم که async یعنی parallel execution، Promise.all limiter است، timeout خودکار کار را cancel میکند یا concurrency بیشتر همیشه سریعتر/ایمنتر است.
خود Async Failure & Concurrency Budget Record v1 الزام طراحی آموزشی MAKNOW است و external JavaScript fact نیست. هیچ browser یا assistive-technology evidence بدون مشاهده واقعی ادعا نمیشود. با رسیدن review_due یا تغییر جدی guidance پلتفرم، claimهای cited باید دوباره review و در صورت نیاز محدود یا بهروز شوند.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
WEB-003-S1 retrieval
قرارداد اصلی scheduling در WEB-003 و یک non-goal را بیان کنید.
WEB-003-S2 application
برای کارهای مستقل محلی bounded scheduler پیادهسازی کنید و limit، peak واقعی in-flight، settlement و شواهد deadline/cancellation را ثبت کنید.
WEB-003-S3 diagnosis
یک mutation عمدی علیه concurrency budget یا timeout/cancellation اجرا کنید؛ prediction، observation، diagnosis، repair و post-repair evidence را ثبت کنید.
WEB-003-S4 decision
برای این سناریو bounded worker pool را در برابر Promise.all fan-out یا await-in-loop سری دفاع کنید.
WEB-003-S5 transfer
Fixture انتقال تغییرکرده را مستقل حل کنید و evidence block جدا با budget/deadline جدید بسازید.
ملاکهای ارزیابی (rubric)
Critical dimensions:
- Contract correctness — sequencing/concurrency choice, configured budget, timeout meaning and cancellation claim match the owned scenario.
- Evidence quality — measurements, mutation, diagnosis, repair and post-repair observations are traceable; appearance-only proof is insufficient.
- Scope discipline — TypeScript/module/bundler outcomes and unsupported production-performance claims are deferred.
- Transfer independence — changed-context work is solved without a decisive supplied implementation.
Blocking assessments: S2, S3, S5. S1 is retrieval-only and should not be failed solely for missing mutation/repair evidence when the stated contract and non-goal are correct. Owner acceptance is not fabricated by machine/local checks.
منابع و تازگی
مطالعهٔ موارد (case studies)
فایلهای آزمایشگاه
هدف: اثبات قرارداد bounded scheduling با simulator محلی deterministic؛ شبکه لازم نیست.
- در ریشه lab فرمان
python run_checks.py --self-testرا اجرا کنید. این مرحله فقط ساختار fixture را بررسی میکند و scheduler شما را تأیید نمیکند. learner/starter/index.htmlرا در مرورگر استاندارد باز کنید یا از core checkهای Node-compatible استفاده کنید. قبل از edit،scheduler-core.jsرا بخوانید و peak و timeout behavior را پیشبینی کنید.mapWithConcurrency(items, limit, worker)را طوری repair کنید که active work ازlimitبیشتر نشود و کارهای مستقل بتوانند overlap داشته باشند.runWithDeadline(taskFactory, timeoutMs)را طوری repair کنید که task abort-aware بتواند cancellation signal دریافت کند. از timer race بهتنهایی ادعای cancellation نکنید.python mutation_probe.py --submission-dir learner/starterرا اجرا و حداقل یک چرخه prediction/observation/diagnosis/repair را در evidence ثبت کنید.learner/transferرا مستقل repair کنید. تعداد item، delay، failure و budget آن متفاوت است.learner/evidence/learner_evidence.jsonرا با schema عمومی artifact کامل کنید. تا وقتی fixture را واقعاً در مرورگر مشاهده نکردهاید،browser_dom_observation.claimedرا false نگه دارید؛ در صورت claim، browser/environment، observation مستقیم و inference محدود را جدا ثبت کنید.
Browser observation فقط وقتی ثبت شود که واقعاً مشاهده شده باشد. Node-compatible checks scheduling core را اثبات میکنند، نه browser/AT behavior را.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)