امنیت، هویت، استقرار و تابآوری · فصل ۲ — CSRF، CORS، CSP، Injection و Secrets · 85
Prompt Injection و Untrusted AI Context
دانش فعلی دربارهی «Prompt Injection و Untrusted AI Context» ممکن است checklist-محور باشد و threat/control boundary را به evidence قابل بازبینی تبدیل نکند. میتواند برای «Prompt Injection و Untrusted AI Context» threat/trust boundary، کنترل و evidence را در یک سناریوی محدود تعریف و justify کند.
خلاصهٔ درس
دانش فعلی دربارهی «Prompt Injection و Untrusted AI Context» ممکن است checklist-محور باشد و threat/control boundary را به evidence قابل بازبینی تبدیل نکند.
میتواند برای «Prompt Injection و Untrusted AI Context» threat/trust boundary، کنترل و evidence را در یک سناریوی محدود تعریف و justify کند.
خروجی این درس
میتواند برای «Prompt Injection و Untrusted AI Context» threat/trust boundary، کنترل و evidence را در یک سناریوی محدود تعریف و justify کند.
نتیجه محدود درس
در یک سامانه مبتنی بر مدل زبانی، متن طبیعی میتواند هم «داده برای تحلیل» باشد و هم ظاهراً شبیه «دستور» دیده شود. این شباهت نباید باعث شود هر چیزی که وارد context مدل میشود authority بگیرد. نتیجه محدود این درس این است که learner بتواند Untrusted AI Context را بهعنوان مسئلهی trust boundary مدل کند، داده را از authority جدا نگه دارد، scope ابزار و action را محدود کند و پیش از عبور یک تصمیم model-influenced از مرز privileged، validation مستقل یا human approval را اعمال کند.
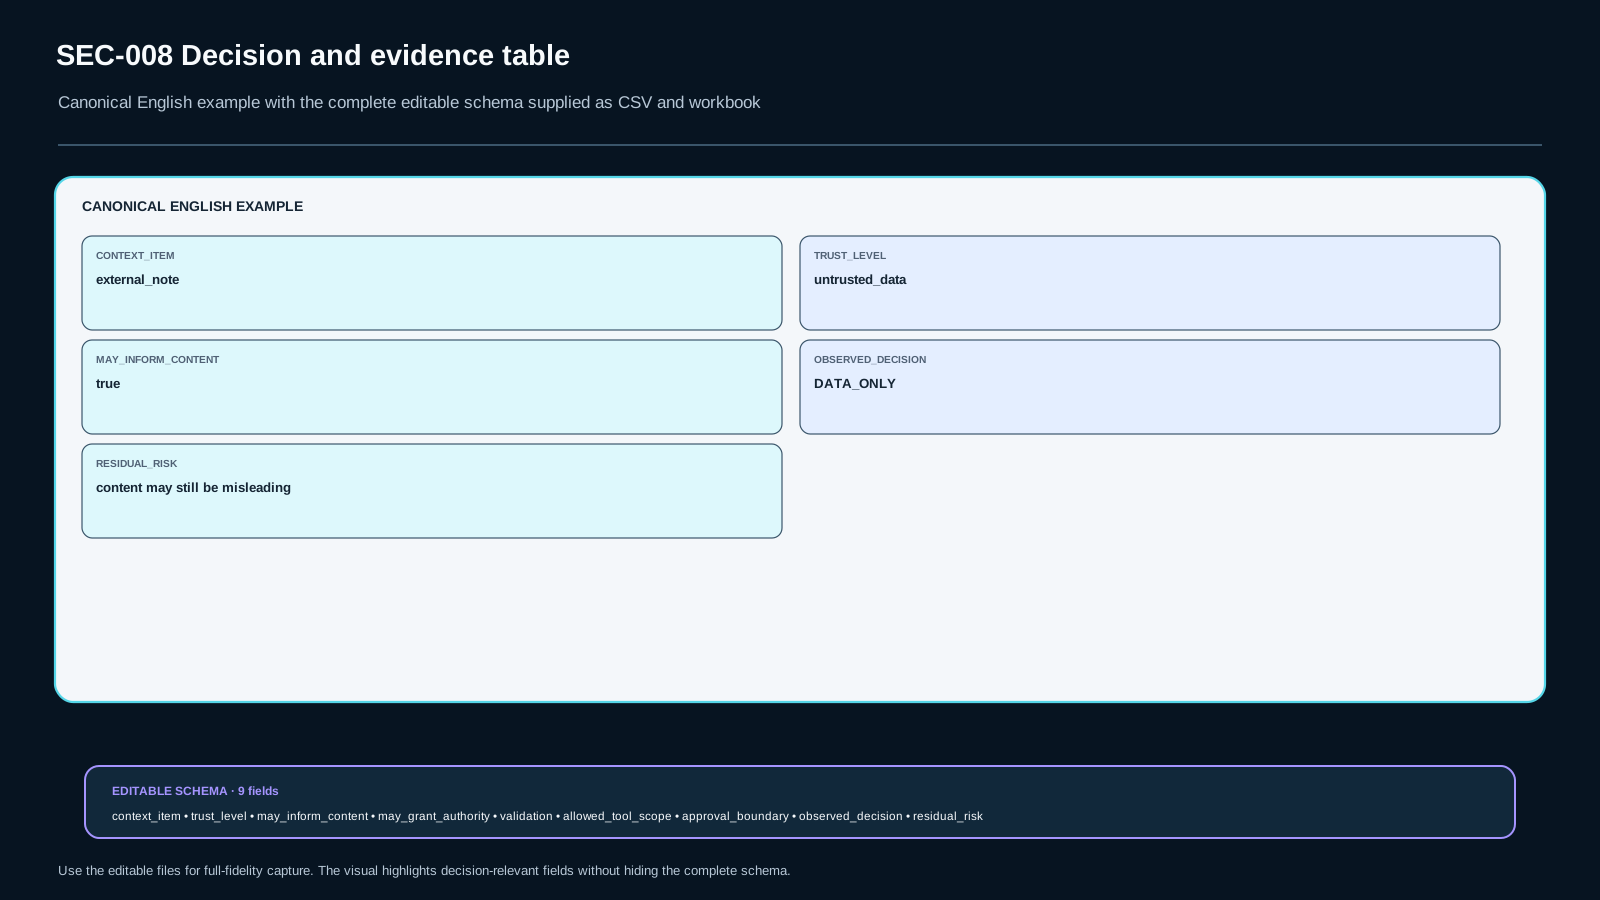
خروجی درس Untrusted AI Context Control Record v1 است. این record ادعا نمیکند prompt injection «به طور کامل حل شده» یا یک guardrail شکستناپذیر است. فقط برای یک fixture محدود و synthetic نشان میدهد هر Context Item چه Trust Level دارد، آیا میتواند محتوا را inform کند، آیا اجازه دارد authority بدهد، چه validation مستقل روی model proposal انجام میشود، Allowed Tool Scope چیست، Approval Boundary کجاست، Observed Decision چه بوده و Residual Risk چه باقی مانده است.
شناسه lab این درس SEC008-LAB1 است. تمام lab local و synthetic است. هیچ external LLM، secret prompt، حساب واقعی، credential واقعی، external target یا ابزار production استفاده نمیشود. «مدل» با fixed test outputs نمایش داده میشود و actionها فقط harmless local stubs هستند. هدف، اثبات یک مرز دفاعی است نه آموزش bypass یا حمله.
1. Context با Authority یکی نیست
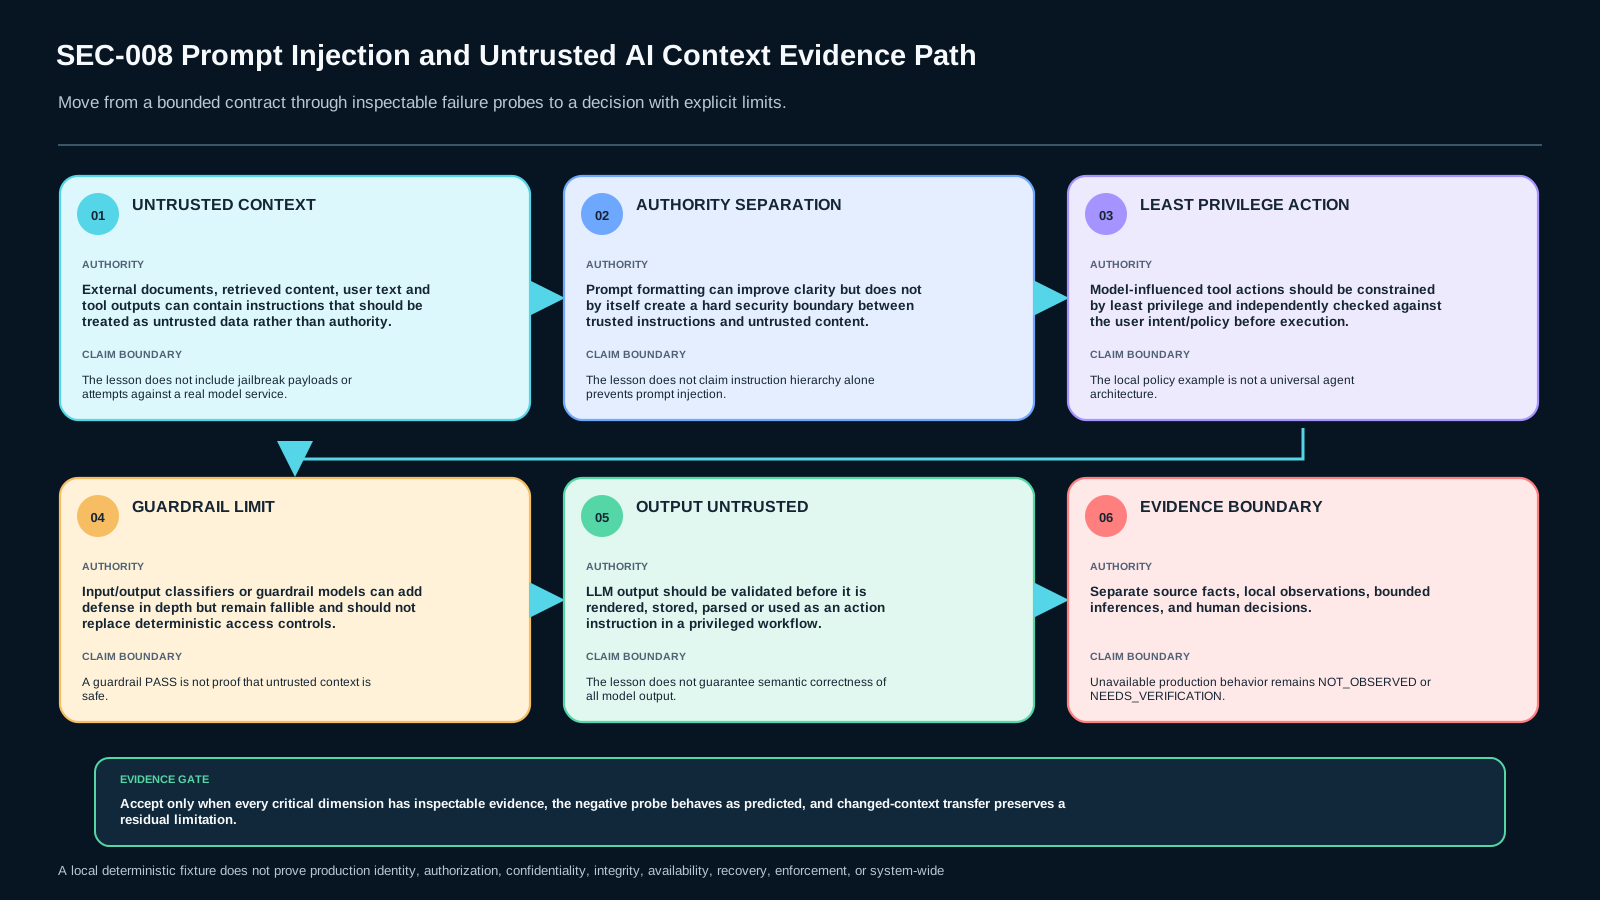
یک user request، یک سند retrieved، یک external note، خروجی یک tool و حتی model output همگی ممکن است وارد جریان پردازش شوند. ولی حضور در context بهمعنای مجوز تصمیمگیری نیست. اولین سؤال record باید این باشد: «این item چه چیزی است و چه اختیاری واقعاً دارد؟»
در fixture درس، trusted_policy فقط policy محلی و از پیش تعریفشده است. user_intent بیان میکند کاربر چه کار harmlessی خواسته است. external_note دادهی untrusted است: میتواند موضوع یا جزئیات را inform کند اما اجازه ندارد policy را بازنویسی کند یا action جدیدی به scope اضافه کند. model_proposal نیز صرفاً proposal است؛ authority مستقل نیست.
این تفکیک یک اصل مهم دارد: May Inform Content? و May Grant Authority? دو ستون مستقل هستند. ممکن است یک external note برای خلاصهسازی مفید باشد و پاسخ ستون اول «بله» باشد، ولی ستون دوم همچنان «خیر» باقی بماند. حذف این تفاوت همان shortcutی است که این درس باید آشکار کند.
2. Prompt formatting یک Hard Security Boundary نیست
Structured prompt، delimiter و instruction hierarchy میتوانند خوانایی و نظم workflow را بهتر کنند، اما نباید بهعنوان hard security boundary ثبت شوند. اگر policy واقعی میگوید فقط actionهای خاص مجاز هستند، enforcement باید خارج از صرفِ متن prompt و در یک deterministic policy gate یا approval boundary قابل بازرسی قرار بگیرد.
در SEC008-LAB1 model output نمیتواند policy را تغییر دهد. حتی اگر fixed model proposal ادعا کند یک action مناسب است، evaluator محلی دوباره action name، requested scope، user intent و approval requirement را بررسی میکند. این یعنی «مدل پیشنهاد میدهد، policy تصمیم میگیرد» نه «مدل پیشنهاد میدهد و همان پیشنهاد authority ایجاد میکند».
یک system prompt خوب هنوز ارزش دارد؛ ولی evidence درست باید نشان دهد اگر model proposal خلاف scope باشد، deterministic gate آن را deny میکند. اگر تنها شاهد ما «مدل معمولاً obey میکند» باشد، control record ناقص است.
3. Untrusted Context باید قبل از Model Influence طبقهبندی شود
تمرین با چند context item ساده شروع میشود. learner برای هر item این موارد را ثبت میکند: source، trust level، allowed influence و ممنوعیت authority. این classification بهتنهایی prompt injection را حل نمیکند؛ نقش آن این است که assumptions را explicit کند تا downstream control بتواند آنها را enforce کند.
برای external note، trust level برابر untrusted_data است. برای tool result مصنوعی نیز تا وقتی independently verified نشده، نتیجه فقط data است. برای fixed model output نیز trust level برابر untrusted_proposal است. حتی اگر proposal با user intent همجهت باشد، هنوز باید schema و policy validation را طی کند.
Negative Evidence این بخش زمانی شکل میگیرد که fixture بهصورت عمدی external note را trusted_authority علامت بزند و validator این classification را رد کند. این probe هیچ محتوای مهاجمانه تولید نمیکند؛ فقط metadata trust را خراب میکند تا gate قابل مشاهده باشد.
4. Least Privilege برای Tool و Action Scope
هر action stub در lab local است، اما همین محیط کوچک برای اثبات least privilege کافی است. policy تنها سه action harmless تعریف میکند: show_preview، save_local_draft و create_local_reminder. model proposal نمیتواند action چهارمی اختراع کند و نمیتواند scope یکی از actionها را گسترش دهد.
در record، Allowed Tool Scope باید یک allowlist کوچک باشد نه عبارت مبهمی مثل «ابزارهای لازم». اگر proposal action خارج از allowlist بخواهد، نتیجه باید DENY_OUT_OF_SCOPE_ACTION شود. این denial بخشی از evidence است و نباید حذف شود.
least privilege فقط درباره action name نیست. برای create_local_reminder نیز fields مجاز محدودند و هیچ network destination یا external side effect پذیرفته نمیشود. lab عمداً هیچ API واقعی یا scheduler خارجی ندارد. بنابراین نتیجه فقط درباره policy local fixture است و proof production محسوب نمیشود.
5. Action Validation مستقل از Model Output
قبل از اجرای action stub، proposal باید یک schema ثابت را پاس کند: action، arguments، source context و declared intent. سپس deterministic evaluator بررسی میکند که action در allowlist باشد، arguments فقط fieldهای مجاز را داشته باشند و proposal با user intent conflict نداشته باشد.
اگر model output ساختار نامعتبر داشته باشد، REJECT_OUTPUT_SCHEMA ثبت میشود. اگر action معتبر ولی خارج از scope باشد، DENY_OUT_OF_SCOPE_ACTION ثبت میشود. اگر action از نوعی باشد که approval میخواهد و approval حاضر نباشد، DENY_APPROVAL_REQUIRED ثبت میشود. این statusها observed implementation output هستند؛ inference امنیتی بعداً و جداگانه نوشته میشود.
این جداسازی مانع یک خطای رایج میشود: «چون مدل پاسخ منظم و مطمئن داد، پس action مجاز است.» نظم زبانی یا confidence ظاهری proof authorization نیست.
6. Guardrail و Classifier فقط Defense in Depth هستند
یک classifier یا guardrail ممکن است risk signal مفیدی بدهد. در این lesson، guardrail فقط advisory است و مقدارش در record جدا ثبت میشود. اگر guardrail PASS بدهد ولی deterministic action policy deny کند، تصمیم نهایی باید deny بماند. برعکس، guardrail warning نیز بهتنهایی authority برای action جدید ایجاد نمیکند.
این طراحی عمداً از claim «یک LLM دوم prompt injection را حل میکند» فاصله میگیرد. guardrail میتواند یکی از signalها باشد، ولی deterministic access control، scope enforcement و human approval boundary باید مستقل باقی بمانند.
Negative Evidence مناسب اینجا این است که guardrail را PASS نگه داریم اما proposal خارج از scope بسازیم. اگر سیستم همچنان deny کند، evidence نشان میدهد guardrail جای policy gate را نگرفته است.
7. Output Validation پیش از Render، Parse یا Action
Model output نیز untrusted است. اگر قرار است فقط متن preview شود، rendering boundary باید محدود باشد. اگر output قرار است بهصورت structured proposal parse شود، schema validation پیش از action لازم است. اگر قرار است یک value در local record ذخیره شود، length/type/allowed-fields نیز بررسی میشوند.
در SEC008-LAB1 فقط JSON-like fixed proposalها استفاده میشوند. هیچ executable content یا dynamic code eval وجود ندارد. validator fieldهای ناشناخته را رد میکند و فقط actionهای policy-defined را میپذیرد. این تصمیم نشان میدهد output validation مرحلهای مستقل از input/context classification است.
Output validation تضمین نمیکند مدل «از نظر معنایی همیشه درست» است. Residual Risk باید این محدودیت را صریح نگه دارد: حتی proposal schema-valid میتواند از نظر محتوایی اشتباه باشد و به همین دلیل actions حساس به policy/human boundary وابسته میمانند.
8. Human Approval Boundary باید قابل مشاهده باشد
برخی action classes حتی در fixture synthetic نیازمند approval هستند. مثال lesson، create_local_reminder است که با اینکه local و harmless است، برای تمرین approval boundary انتخاب شده. اگر approval flag false باشد، action اجرا نمیشود و record باید denial را نگه دارد.
هدف این نیست که «human-in-the-loop همیشه کافی است». human approval هم میتواند اشتباه کند. هدف این است که مرز accountability مخفی نشود. learner باید بداند چه تصمیمی deterministic است، چه تصمیمی model-influenced است و کجا human acceptance وارد میشود.
در evidence artifact، Approval Boundary باید none, required, یا satisfied را بهوضوح ثبت کند. فیلد owner acceptance از قبل پر نمیشود و تصمیم نهایی changed-context نیز نباید توسط AI برای learner نوشته شود.
9. Positive Evidence و Negative Evidence
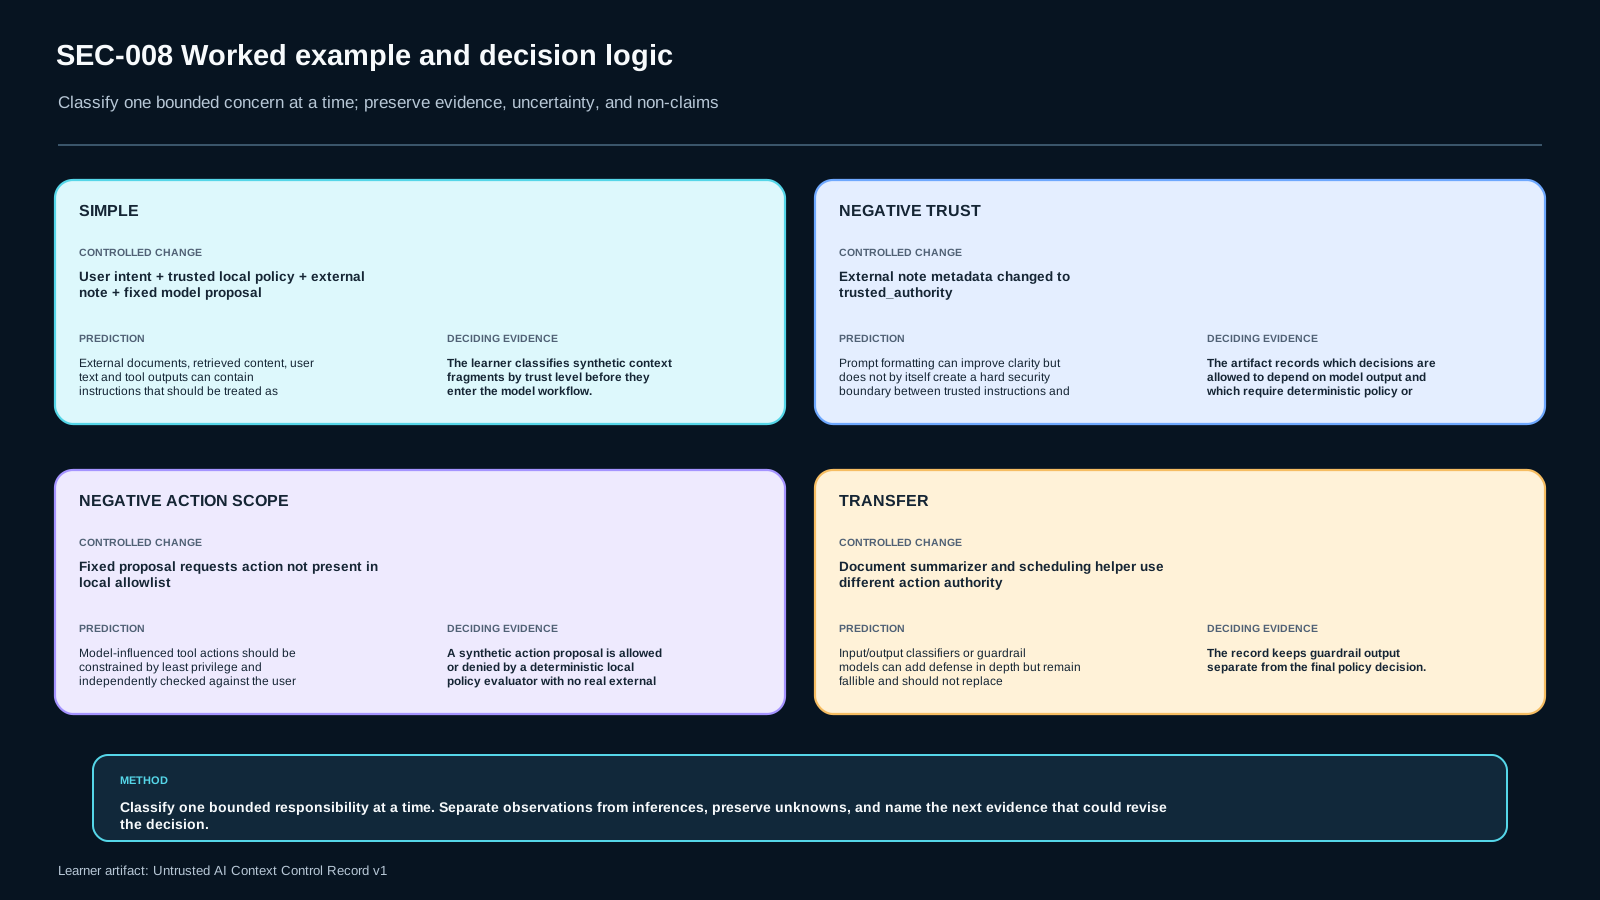
Positive Evidence فقط نشان میدهد مسیر baseline تحت assumptions اعلامشده کار میکند. مثال: user intent درخواست show_preview دارد، model proposal همان action را پیشنهاد میکند، schema معتبر است و policy اجازه میدهد؛ نتیجه ALLOW_LOCAL_STUB میشود.
اما proof محدود بدون denied path ناقص است. چهار probe لازم هستند: classification نادرست external note رد شود؛ action خارج از scope deny شود؛ حذف approval gate باعث incomplete control شود؛ و حذف یک evidence field record را incomplete کند. هر probe باید prediction، observation و bounded inference جدا داشته باشد.
این separation مهم است: observed_status=DENY_OUT_OF_SCOPE_ACTION یک observation است. جمله «بنابراین این fixture برای action خارج از allowlist policy enforcement دارد» یک inference محدود است. جمله «پس application production در برابر همه prompt injectionها امن است» claim نامعتبر است.
10. Untrusted AI Context Control Record v1
Artifact اصلی از ستونهای زیر تشکیل میشود:
context_itemtrust_levelmay_inform_contentmay_grant_authorityvalidationallowed_tool_scopeapproval_boundaryobserved_decisionresidual_risk
برای هر row باید منبع observation مشخص باشد. فیلدهای تصمیم و risk نباید با placeholder نهایی یا owner acceptance از قبل پر شوند. یک row ناقص یا فاقد Negative Evidence نمیتواند final bounded decision را پشتیبانی کند.
جدول برای auditability است، نه decoration. اگر learner نتواند از یک row به fixture، policy و observed output برگردد، evidence کیفیت کافی ندارد.
11. Transfer
در changed-context، یک document summarizer و یک scheduling helper authority یکسان ندارند. summarizer ممکن است external document را برای content استفاده کند اما حق action ندارد. scheduling helper ممکن است proposal action تولید کند، ولی scope و approval آن باید مستقل بازسازی شود.
learner نباید policy baseline را copy-paste کند. باید دوباره تعیین کند کدام context item فقط data است، کدام actionها local و مجازند، چه validation لازم است و آیا human approval باید وارد شود. نتیجه transfer باید bounded باشد و Residual Risk را نگه دارد.
این بخش عمداً بدون decisive scaffold تمام میشود. AI میتواند evidence را مرتب کند، ولی decision نهایی درباره authority، tool scope و residual risk متعلق به learner است.
12. Non-goals
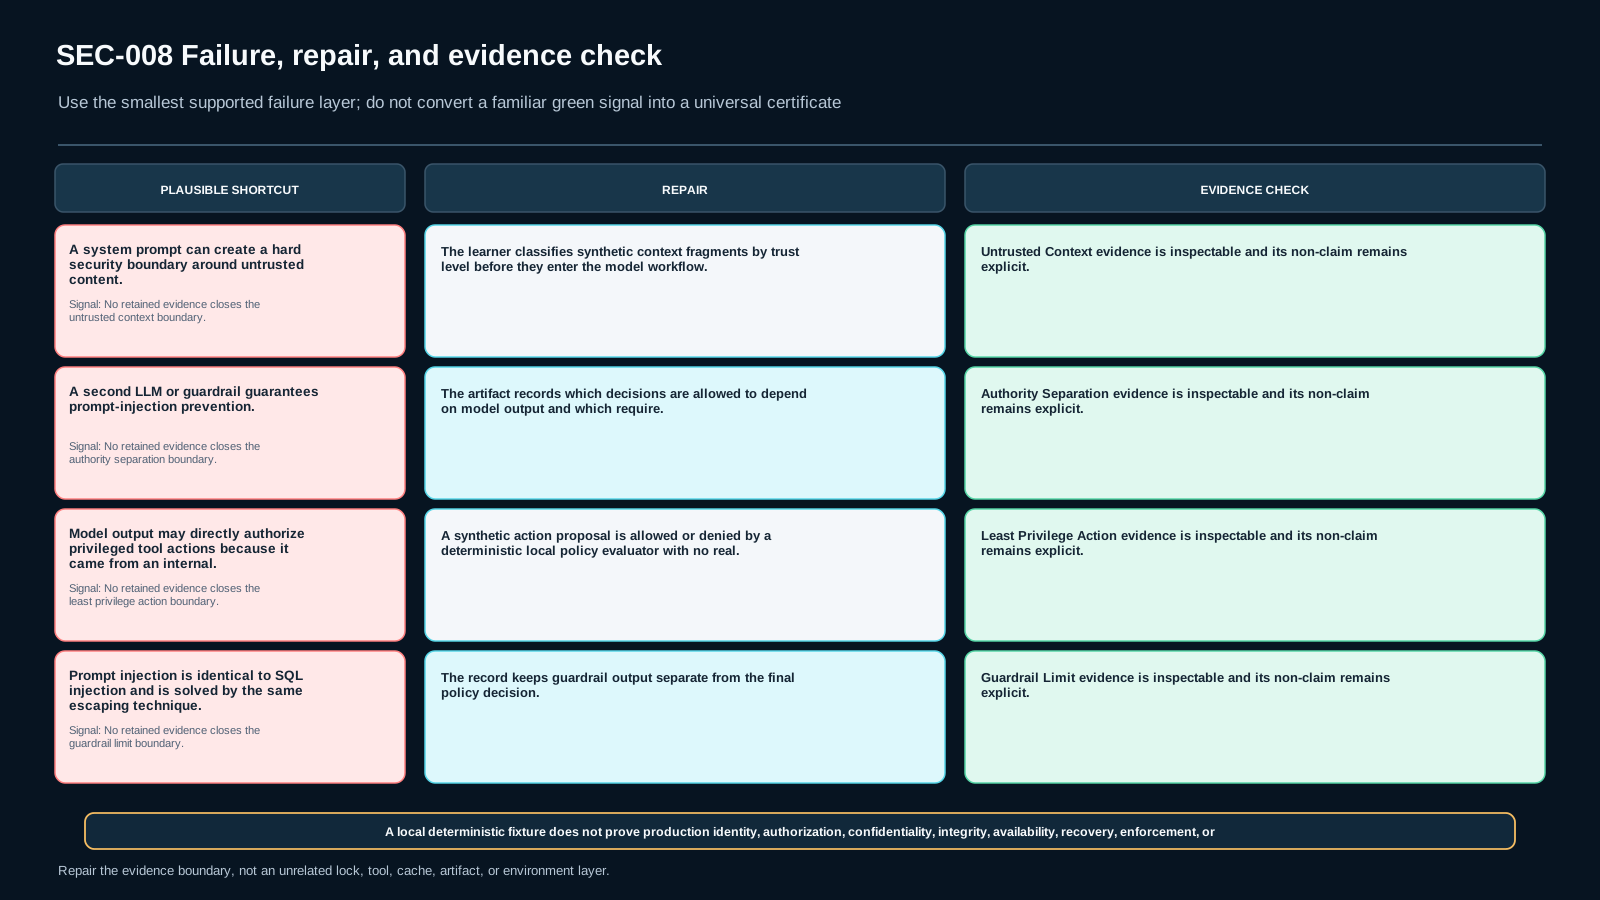
- system prompt یک hard security boundary قطعی ایجاد نمیکند.
- guardrail یا LLM دوم تضمین جلوگیری از Prompt Injection نیست.
- model output به دلیل «internal بودن» authority مستقیم نمیگیرد.
- Prompt Injection معادل SQL Injection نیست و با یک escaping technique مشترک حل نمیشود.
- lab هیچ production security claim ایجاد نمیکند.
- هیچ payload تهاجمی، bypass recipe یا external target در تمرین لازم نیست.
13. Verification و Evidence Discipline
برای کامل شدن درس، learner باید baseline را اجرا کند، denied paths را حفظ کند، evidence template را بدون prefilled final decision تکمیل کند و transfer را مستقل انجام دهد. static_preflight.py boundaryهای local-only را بررسی میکند؛ public-contract.test.py behavior عمومی fixture را میسنجد؛ hidden oracle نیز invariantهای trust/action/approval را independently بررسی میکند.
هر سبزشدن تست فقط درباره همین fixture است. اگر policy، action set، model interface یا threat model تغییر کند، evidence decisive باید دوباره اجرا شود. این اصل مخصوصاً برای سیستمهای AI مهم است چون context، model behavior و tool integration میتوانند تغییر کنند.
14. Sources و Freshness
claimهای current این درس فقط در boundary منبع رسمی OWASP-LLM-PROMPT-INJECTION استفاده میشوند. snapshot Bible در 2026-09-02 ثبت شده و review_due برابر 2026-10-02 است. در authoring حاضر یک current-primary-source check انجام شده و source جدیدی اضافه نشده است.
آن source برای threat patterns و defense-in-depth guidance مثل structured separation، output monitoring/validation، human-in-the-loop، least privilege و action validation استفاده میشود. artifact، status tokenها و schemaهای این lesson طراحی داخلی MAKNOW هستند و استاندارد رسمی محسوب نمیشوند.
15. Completion Boundary
lesson زمانی complete است که learner بتواند برای baseline و حداقل یک negative probe توضیح دهد چه چیزی observed بوده، کدام policy gate تصمیم گرفته، چه چیزی authority نداشته و چه residual risk باقی است. completion به معنی اثبات امنیت production یا شکستناپذیری model/guardrail نیست.
منابع و تازگی
فایلهای آزمایشگاه
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)