مهندسی سامانههای هوش مصنوعی · فصل ۲ — Model Selection، Serving، Cost Governor و Workflow · 139
vLLM Serving Concepts
میتواند مدل یا ابزار AI را فراخوانی کند اما contract، qualification، routing، cost، trust و failure را کنترل نمیکند. موضوع جاری: «vLLM Serving Concepts». میتواند «vLLM Serving Concepts» را در یک workflow AI محدود طراحی کند و validation، authority، cost یا failure controls مرتبط را مشخص کند.
خلاصهٔ درس
میتواند مدل یا ابزار AI را فراخوانی کند اما contract، qualification، routing، cost، trust و failure را کنترل نمیکند. موضوع جاری: «vLLM Serving Concepts».
میتواند «vLLM Serving Concepts» را در یک workflow AI محدود طراحی کند و validation، authority، cost یا failure controls مرتبط را مشخص کند.
خروجی این درس
میتواند «vLLM Serving Concepts» را در یک workflow AI محدود طراحی کند و validation، authority، cost یا failure controls مرتبط را مشخص کند.
1. مسئله واقعی: پاسخدادن endpoint مساوی ظرفیت اثباتشده نیست
vLLM میتواند یک مدل را پشت API قابلاستفاده قرار دهد، اما موفقیت یک درخواست فقط نشان میدهد همان درخواست در همان لحظه پاسخ گرفته است. برای تصمیم مهندسی باید بدانیم دقیقاً چه model revision، چه نسخه vLLM، چه سختافزار، چه تنظیمات parallelism و scheduler، چه طول ورودی/خروجی و چه concurrency اندازهگیری شدهاند. این درس بهجای جملههای کلی مثل «vLLM سریع است» یک vLLM Serving Configuration & Capacity Evidence Record v1 میسازد. خروجی فقط برای slice اندازهگیریشده معتبر است.
چهار ادعا را از هم جدا نگه دار: ۱) قابلیت فعلی ابزار، ۲) تنظیمی که ما انتخاب کردهایم، ۳) عددی که واقعاً اندازهگیری شده، ۴) تصمیم محصول. اگر یکی از این چهار لایه در دیگری حل شود، audit بعدی نمیتواند بفهمد چرا یک configuration مجاز شده است.
2. هویت رکورد serving باید immutable و بازسازیپذیر باشد
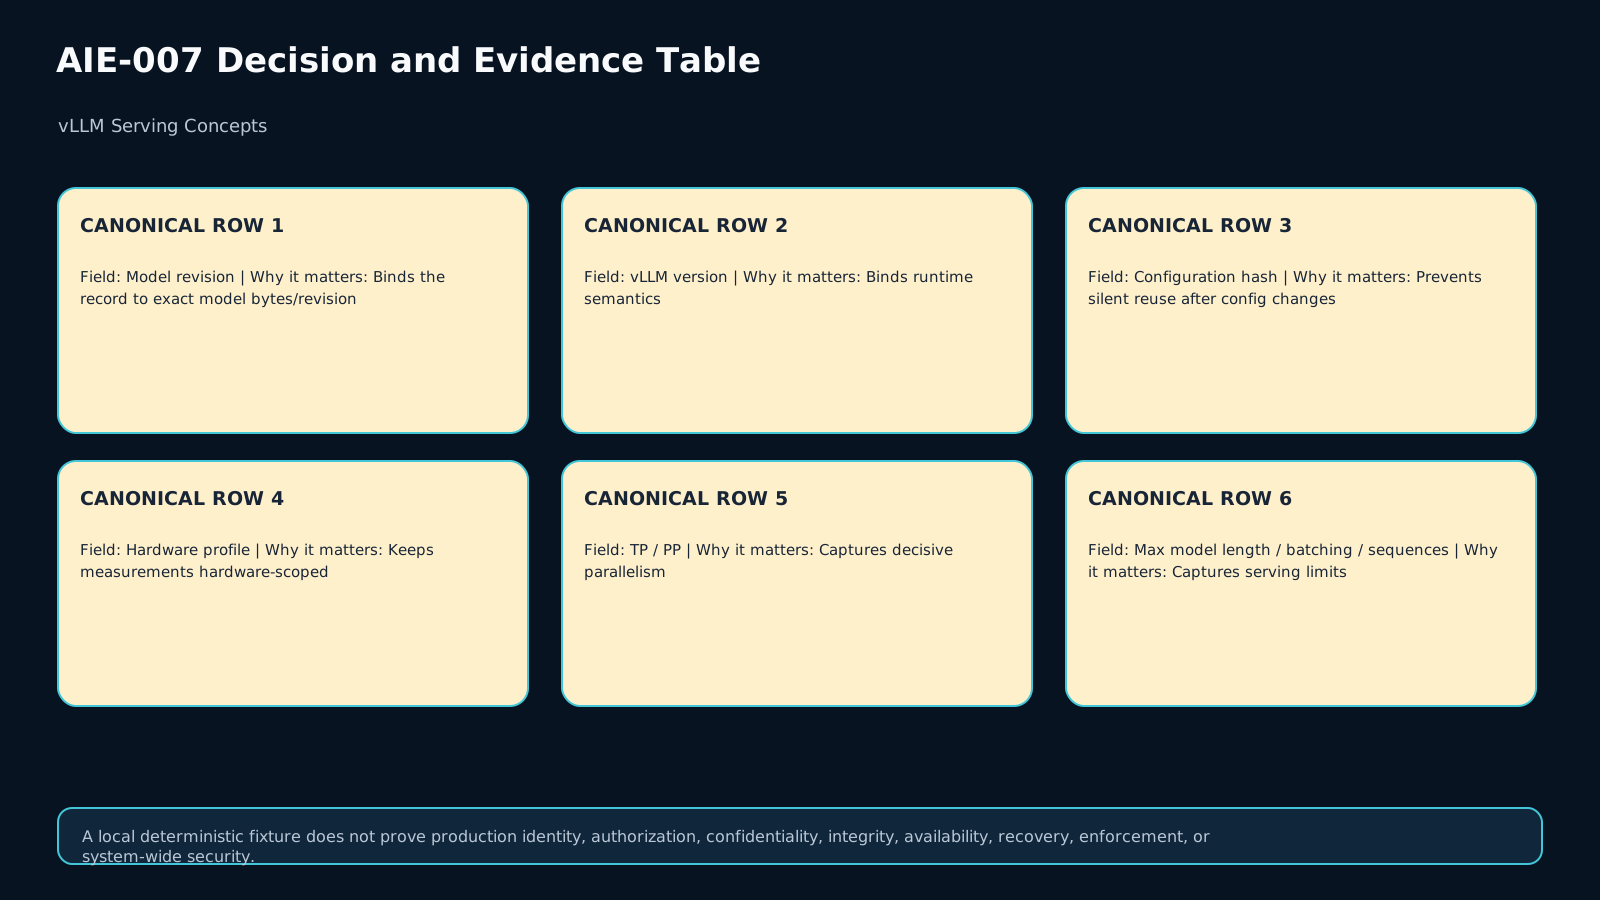
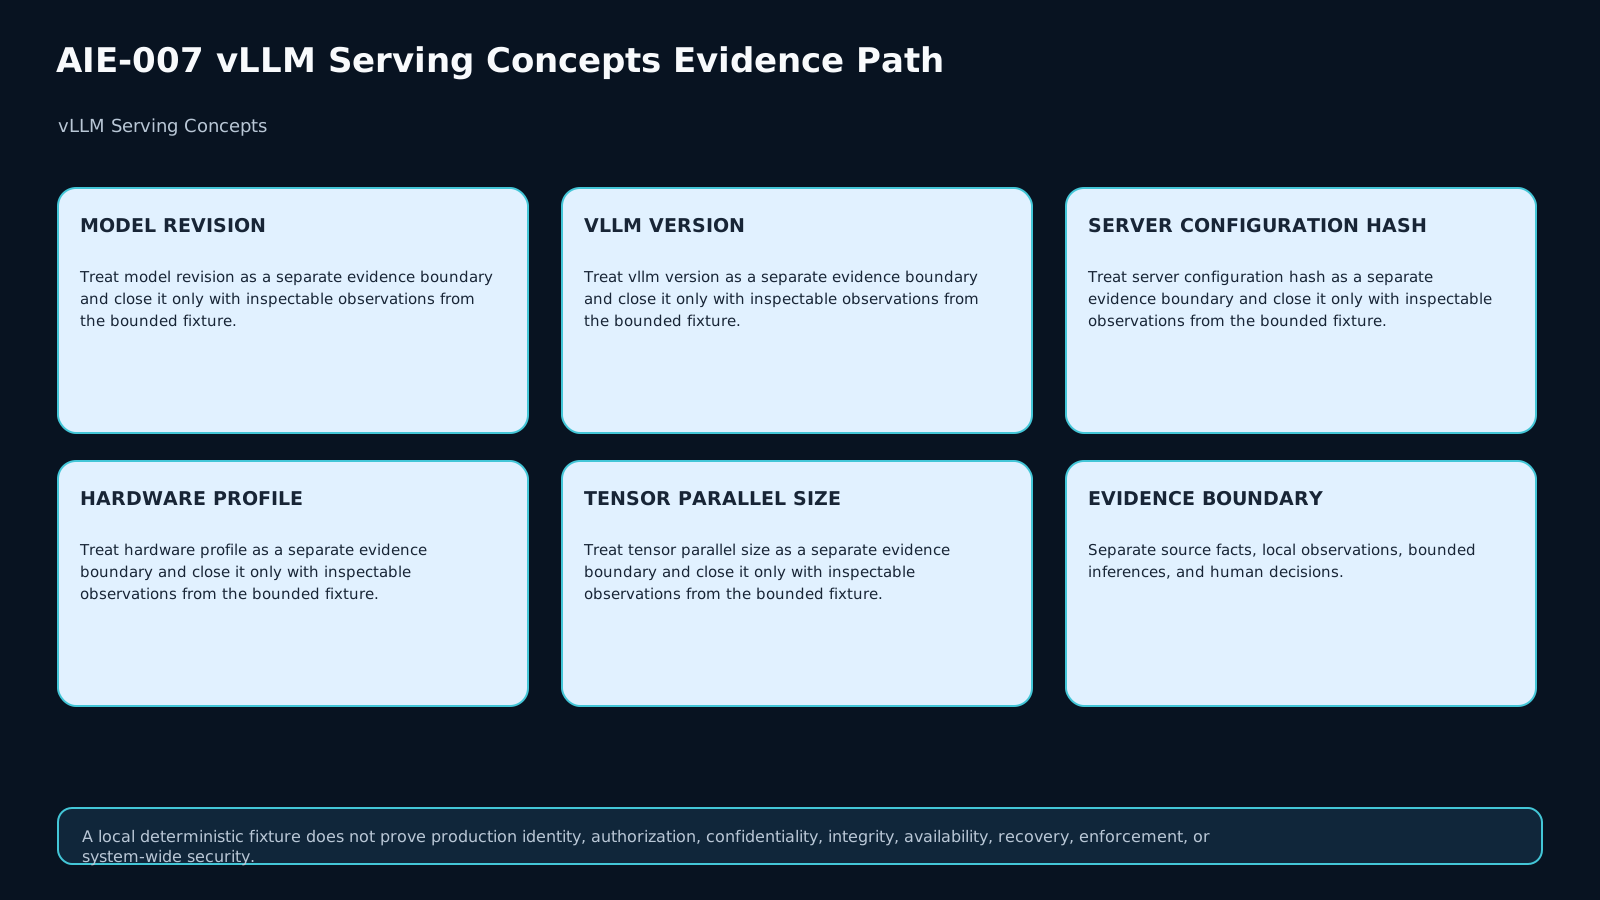
حداقل هویت رکورد شامل model_revision، vllm_version، server_configuration_hash و hardware_profile است. served_model_name یا یک alias برای convenience مفید است، اما جای revision و hash را نمیگیرد. parallelism، max_model_len، memory budget، batching/sequence limits و حالت warmup نیز جزو context evidence هستند.
اگر همان مدل با configuration دیگری اجرا شود، رکورد جدید میخواهیم. رکورد قبلی را درجا mutate نکن. هدف این است که بتوانیم چند ماه بعد دقیقاً بگوییم p95 ثبتشده متعلق به کدام ترکیب مدل، runtime، hardware و server config بوده است.
3. PagedAttention را بهعنوان مفهوم مدیریت KV cache بفهم
در vLLM، PagedAttention یکی از مفاهیم کلیدی مدیریت حافظه attention/KV cache است. ارزش آموزشی آن برای این درس این نیست که یک عدد ثابت سرعت وعده بدهد؛ بلکه نشان میدهد serving behavior به نحوه مدیریت cache و scheduling وابسته است. تغییر طول context، batch composition یا concurrency میتواند فشار متفاوتی بر KV cache ایجاد کند و بنابراین شواهد یک workload لزوماً به workload دیگر منتقل نمیشود.
پس از نام یک mechanism نتیجه performance نساز. «PagedAttention فعال/موجود است» یک fact درباره runtime است؛ «این configuration برای ۱۲ درخواست همزمان SLO ما را پاس میکند» فقط با اندازهگیری همان slice قابلاثبات است.
4. Continuous batching، chunked prefill و prefix caching را با evidence قاطی نکن
vLLM از continuous batching و قابلیتهایی مانند chunked prefill و prefix caching پشتیبانی میکند. اینها میتوانند رفتار queue، زمان prefill، استفاده از cache و throughput را تغییر دهند، اما هیچکدام بهتنهایی ظرفیت محصول را ثابت نمیکنند. اگر configuration یا workload طوری تغییر کند که اثر این mechanisms عوض شود، benchmark قبلی فقط historical evidence است.
در رکورد ظرفیت، capability را جدا بنویس و measurement را جدا. مثلاً «prefix caching در runtime وجود دارد» با «workload فعلی hit pattern قابلاستفاده دارد» یکی نیست. همین تفکیک جلوی overclaim را میگیرد.
5. Parallelism یک عدد واحد نیست
Serving ممکن است از tensor parallelism، pipeline parallelism، data parallelism یا ترکیبهایی از آنها استفاده کند. تعداد GPU بهتنهایی توصیف کافی نیست. tensor_parallel_size و pipeline_parallel_size را دقیق ثبت کن و اگر data parallel یا topology دیگری تعیینکننده است آن را نیز در provenance بیاور.
Config A با TP=1 و Config B با TP=2 دو configuration متفاوتاند حتی اگر model revision یکسان باشد. تغییر parallelism میتواند memory layout، communication و queue behavior را تغییر دهد. بنابراین qualification رکورد A به B ارث نمیرسد مگر evidence تازهای که B را پوشش دهد.
6. تنظیمات ظرفیتساز را hash کن، نه اینکه فقط در prose بنویسی
حداقل configuration surface این درس شامل max_model_len، gpu_memory_utilization، max_num_batched_tokens و max_num_seqs در کنار parallelism است. همه محیطها دقیقاً همین knobs یا defaultهای یکسان ندارند؛ به همین دلیل server_configuration_hash باید نماینده configuration مؤثر باشد، نه صرفاً command نمونه.
اگر یک knob تعیینکننده عوض شود، retest_trigger فعال میشود. حتی اگر server بالا بیاید و همان مدل را سرو کند، evidence قدیمی نباید به شکل خودکار معتبر بماند.
7. ظرفیت را به request shape و concurrency محدود کن
هر measurement باید محدوده ورودی و خروجی و concurrency را مشخص کند. مثال: input تا 2048 token، output تا 512 token، concurrency تا 8. اگر هدف جدید 4096/1024 با concurrency=12 است، نتیجه قبلی خارج از measured slice است.
این درس extrapolation بیمدرک را ممنوع میکند. تصمیم ممکن است PASS، CONDITIONAL یا DEFER باشد، اما هیچ تصمیمی نباید محدوده اندازهگیریشده را مخفی کند. PASS یعنی «برای همین slice و همین configuration»، نه «برای هر workload».
8. Warmup و protocol اندازهگیری جزو evidence هستند
یک benchmark بدون دانستن warmup state و protocol مقایسهپذیری ضعیفی دارد. رکورد باید حداقل بگوید warmup انجام شده، عمداً انجام نشده، یا نامشخص است. حالت نامشخص برای capacity qualification کافی نیست.
از fixtureهای deterministic درس استفاده میکنیم تا learner مفهوم را بدون GPU یا API خارجی تمرین کند. در production، همین discipline باید روی benchmark واقعی اعمال شود: نسخهها ثابت، workload مشخص، sample کافی و measurement method ثبتشده.
9. p50، p95، queue time و throughput هرکدام چیز متفاوتی میگویند
p50 تجربه میانه را نشان میدهد و p95 tail behavior را بهتر آشکار میکند. queue time میگوید چه مقدار delay قبل از execution رخ داده و throughput نرخ کار انجامشده را نشان میدهد. error و timeout نیز نباید در میانگینهای زیبا گم شوند.
برای eligibility یک target تعریف کن. مثلاً p95 ≤ 1800ms، throughput ≥ 120 token/s و timeout=0 برای slice مشخص. این targetها design choice محصول هستند؛ documentation vLLM آنها را برای ما تعیین نمیکند.
10. Worked example: Config A و Config B را با نام مدل مقایسه نکن
فرض کن هر دو config یک revision از atlas-7b را سرو میکنند. Config A: TP=1، max model length=8192، max sequences=8. Config B: TP=2، max model length=16384 و batching limit متفاوت. حتی اگر Config B در یک درخواست منفرد پاسخ موفق بدهد، رکورد A evidence ظرفیت B نیست.
اگر fixture نشان دهد Config A برای request shape کوچک و concurrency=8 SLO را پاس کرده، فقط همان slice PASS است. برای Config B یا concurrency بالاتر، تصمیم DEFER تا زمان measurement تازه، از یک PASS ساختگی سالمتر است.
11. OpenAI-compatible یعنی interface آشنا، نه security کامل
سرور vLLM APIهای OpenAI-style را ارائه میکند، اما مرز امنیتی باید جدا ثبت شود. مستندات فعلی vLLM هشدار میدهد --api-key همه endpointهای همان HTTP server را authenticate نمیکند. بنابراین موفقیت /v1/... یا وجود API key بهتنهایی اثبات نمیکند کل server surface محافظت شده است.
در evidence record فقط یک security_boundary_note ثبت میکنیم: چه چیزی توسط API key پوشش داده میشود و برای exposure واقعی چه reverse-proxy/network boundary در design لازم است. این درس معماری امنیت production را تصاحب نمیکند؛ فقط از ادعای غلط «API key = کل server امن» جلوگیری میکند.
12. Lab: هشت fixture deterministic
Lab هیچ GPU یا provider call لازم ندارد. هشت case شامل baseline معتبر، target خارج از measured concurrency، تغییر config hash، provenance ناقص، warmup نامشخص، شکست SLO، boundary امنیتی ثبتنشده و transfer با context/concurrency بزرگتر هستند.
تابع learner باید هشت فیلد برگرداند: provenance_state، measurement_state، slice_state، service_state، security_boundary_state، retest_state، final_decision و reason_class. Oracle فقط state machine را میسنجد؛ prose یا انتخاب واژههای learner را از قبل حل نمیکند.
13. ترتیب تصمیم: provenance → measurement → slice → SLO → boundary
اول provenance را بررسی کن. اگر model revision، vLLM version، config hash یا hardware profile ناقص است، capacity evidence قابل اتکا نیست. بعد warmup/measurement completeness را بررسی کن. سپس target را با measured slice مقایسه کن. بعد SLO و error/timeout را بسنج. در آخر boundary note امنیتی را جدا نگه دار.
یک configuration ممکن است از نظر performance PASS باشد اما boundary note ناقص داشته باشد؛ در این حالت CONDITIONAL بهتر از تبدیل موضوع security به benchmark failure است. دلیل تصمیم باید typed بماند.
14. Retest triggerها را از قبل تعریف کن
تغییر model revision، نسخه vLLM، hardware profile، configuration hash، parallelism، max model length، batching/sequence limit یا request/concurrency target میتواند retest بخواهد. هدف trigger این نیست که هر deploy را متوقف کند؛ هدف این است که reuse evidence فقط وقتی رخ دهد که ابعاد تعیینکننده ثابت ماندهاند.
رکورد جدید باید بگوید چه چیزی تغییر کرده و کدام evidence دوباره لازم است. «مدل همان مدل است» کافی نیست، چون serving qualification به مدل تنها bind نشده است.
15. Exit checklist و تمرین انتقال
قبل از PASS بپرس: revision دقیق ثبت شده؟ نسخه vLLM مشخص است؟ hardware و config hash داریم؟ parallelism و limits ثبت شدهاند؟ request/output range و concurrency اندازهگیریشده روشناند؟ warmup state معلوم است؟ p50/p95/queue/throughput و errors/timeouts ثبت شدهاند؟ boundary note امنیتی وجود دارد؟ retest triggerها مشخصاند؟
تمرین انتقال: model revision ثابت میماند، اما max context و target concurrency افزایش پیدا میکند. بدون استفاده از benchmark قدیمی برای extrapolation، یک رکورد تازه بساز و فقط بر اساس evidence موجود PASS، CONDITIONAL یا DEFER صادر کن. خروجی خوب ممکن است DEFER باشد؛ صداقت evidence بخشی از مهارت است.
ارزیابی
پاسخنامهی این درس در بستهی آموزش وجود ندارد؛ خودت جواب بده و صادقانه علامت بزن. «نیاز به مرور» درس را به صف تکرار میفرستد.
Q1 retrieval
Why is one successful OpenAI-compatible request insufficient as capacity evidence?
Q2 application
Which four provenance fields are mandatory before reusing a capacity record?
Q3 diagnosis
The target concurrency is 12 but the record measured only up to 8. What decision is justified?
Q4 security-boundary
Does --api-key by itself prove every endpoint on the vLLM HTTP server is authenticated?
Q5 transfer
Model revision stays fixed but max context length and server configuration hash change. May the old benchmark remain qualified?
ملاکهای ارزیابی (rubric)
PASS requires exact serving provenance, an explicit measured request/concurrency slice, warmup/measurement state, latency/queue/throughput plus error evidence, a bounded security-boundary note, and retest triggers. The learner must refuse unsupported extrapolation and keep the final decision no stronger than the evidence.
منابع و تازگی
مطالعهٔ موارد (case studies)
تصاویر درس
فایلهای آزمایشگاه
Implement evaluate(case) in starter.py. Use only the supplied deterministic fixtures. Return these fields: provenance_state, measurement_state, slice_state, service_state, security_boundary_state, retest_state, final_decision, reason_class.
Decision discipline: exact provenance first; changed configuration requires retest; unknown warmup is insufficient; target shape/concurrency must remain inside the measured slice; SLO/error evidence is evaluated only after those gates; an incomplete server-authentication boundary is a conditional deployment note rather than proof of full security.
رسانه و اسلایدهای درس
فایلهای آموزشی (دانلود)